Эмоциональная озвучка текста: как ИИ передаёт чувства в голосе
Как получить озвучку текста с эмоциями через ИИ: радость, тревога, уверенность. Без диктора, без студии — готовый файл за 2 минуты на speakmi.ru. Разбор от Спикми.
Почему обычная TTS-озвучка звучит «мёртво» и как это влияет на конверсию?
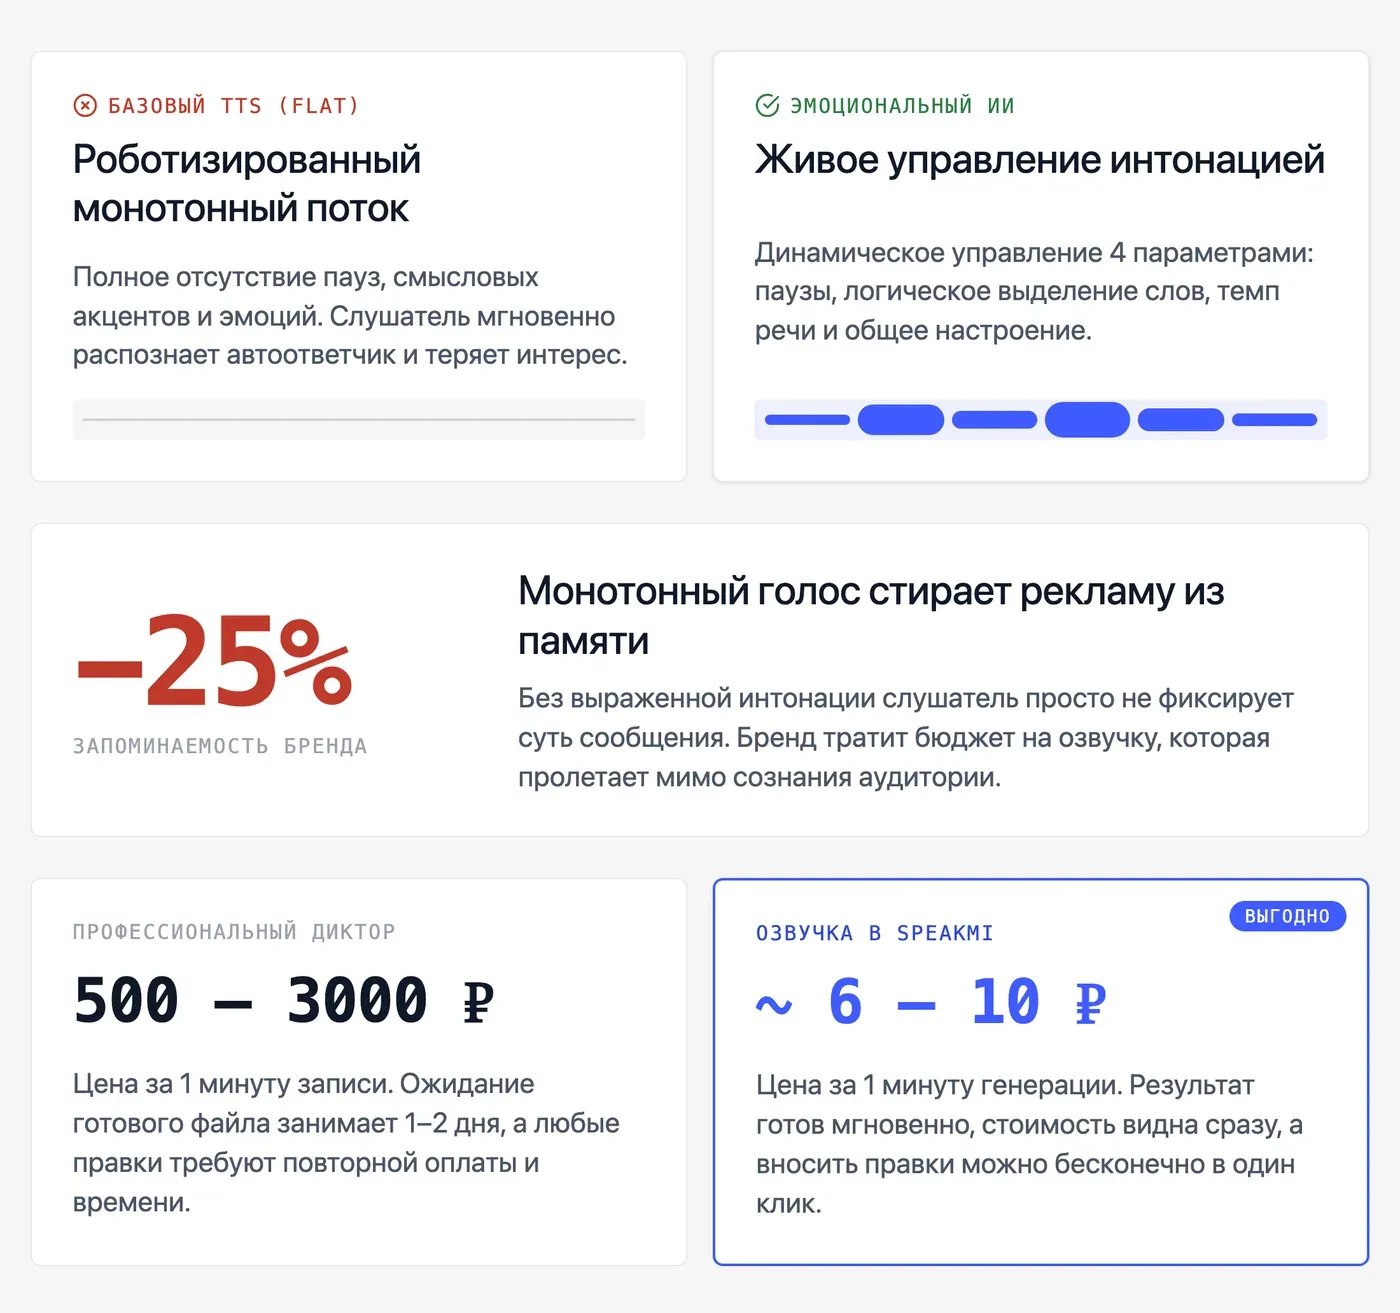
Базовый TTS читает текст с ровной интонацией: нет пауз в нужных местах, нет выделения ключевых слов, нет эмоциональной окраски. Слушатель физически ощущает, что с ним разговаривает машина, — и отключается.
Разница между flat TTS и эмоциональной моделью — не в качестве звука, а в том, как голос расставляет смысловые акценты. Современные модели управляют четырьмя параметрами одновременно: место паузы, выделение слова, скорость произнесения фразы, общее настроение (vc.ru/ai/3085849, 2026). Базовый TTS не трогает ни один из них.
Конкретно для рекламы и карточек товаров это выглядит так: монотонный голос в ролике снижает запоминаемость бренда на 20–25% по сравнению с голосом с выраженной интонацией (Ipsos Audio Branding Study, 2023). Зритель просто не запоминает, что именно ему сказали.
Боль сегмента — в ценовой вилке. Диктор стоит 500–3000 ₽ за минуту, ждать нужно 1–2 дня, любая правка — новый заказ. Дешёвый TTS бесплатен, но отпугивает слушателя с первой секунды. Эмоциональная ИИ-озвучка закрывает этот зазор: стоимость минуты у Speakmi — примерно 6–10 ₽ (Спикми) против 500–3000 ₽ у диктора, и цена видна ещё до нажатия кнопки «Озвучить».
Какие эмоции умеет передавать ИИ-озвучка в 2026 году?
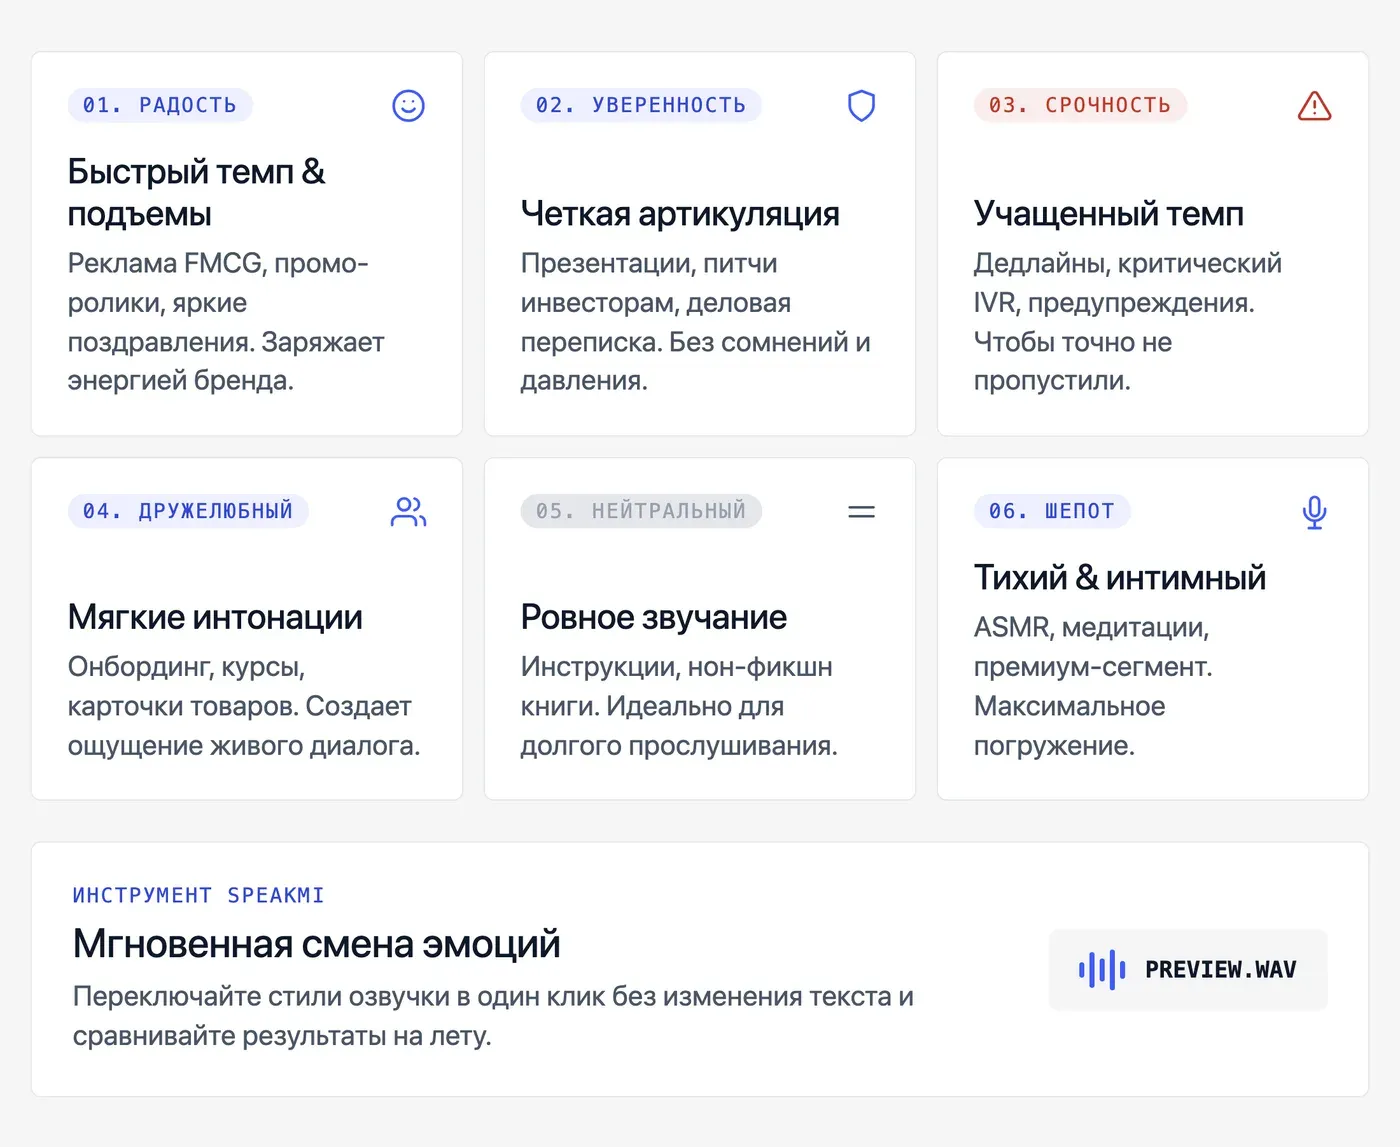
Флагманские модели поддерживают 6–8 базовых стилей. Для каждого — своя область применения.
Радость / позитив. Повышенный темп, лёгкие подъёмы интонации в конце фраз. Подходит для рекламы FMCG, промо-роликов, поздравительных открыток. Слушатель считывает энергию и переносит её на продукт.
Уверенность / официальный. Ровный темп, чёткая артикуляция, минимум пауз. Работает в корпоративных презентациях, питчах для инвесторов, деловых письмах с озвучкой. Голос не давит, но не оставляет пространства для сомнений.
Тревога / срочность. Учащённый темп, акценты на ключевых словах, короткие паузы перед важными фразами. Уместен в предупреждениях, дедлайн-рекламе, сценариях IVR с критической информацией — там, где нужно, чтобы человек не пропустил сообщение.
Дружелюбный / разговорный. Чуть сниженный темп, мягкие интонации, ощущение живого диалога. Идеален для обучающих курсов, онбординга, карточек товара на маркетплейсе — везде, где важно не напугать новичка.
Нейтральный. Ровный голос без выраженной эмоции. Подходит для информационных роликов, инструкций, аудиокниг нон-фикшн. Не раздражает при длинном прослушивании.
Шёпот / интимный. Сниженная громкость, замедленный темп. Используется в ASMR-контенте, рекламе luxury-сегмента, медитативных приложениях.
Speakmi поддерживает выбор эмоционального стиля на этапе настройки генерации — переключаешь стиль, не меняя текст, и сравниваешь варианты через превью.
Эмоциональная ИИ-озвучка vs живой диктор: что выбрать для рекламы и контента?
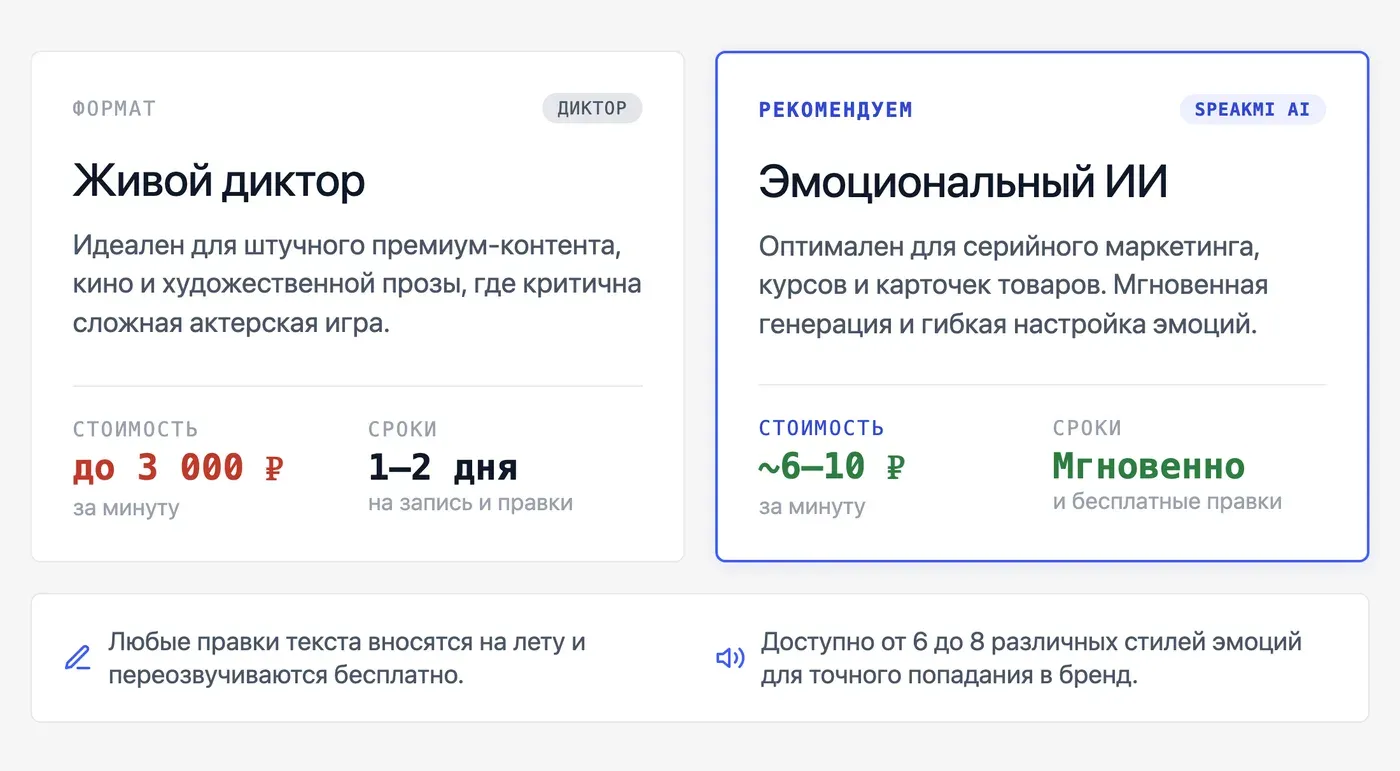
Честный ответ: для разовых имиджевых проектов с высоким бюджетом живой диктор всё ещё выигрывает по нюансам интонации. Для серийного контента — карточки товаров, обучающие курсы, регулярные ролики — эмоциональный ИИ выгоднее по всем параметрам, кроме одного.
| Параметр | Живой диктор | Базовый TTS | Эмоциональный ИИ (Speakmi) |
|---|---|---|---|
| Стоимость | 500–3 000 ₽/мин | 0 ₽ | ~6–10 ₽/мин |
| Скорость готовности | 1–2 дня | Мгновенно | Мгновенно |
| Правка после сдачи | Новый заказ | Бесплатно | Бесплатно |
| Выбор эмоций | Полный диапазон | Нет | 6–8 стилей |
| Масштабируемость | Ограничена занятостью диктора | Неограниченно | Неограниченно |
| Качество на русском | Высокое | Среднее–низкое | Высокое |
| Узнаваемость голоса между проектами | Зависит от договора | Нет | Да (сохранённый голос) |
Ключевое ограничение ИИ — тонкие эмоциональные нюансы в сложных текстах: ирония, горечь, сарказм. Там, где диктор-профессионал считывает контекст и играет голосом, ИИ-модель опирается только на пунктуацию и разметку. Для 90% маркетинговых задач этого достаточно. Для озвучки художественной прозы — пока нет.
Опечатка или неудачная фраза правится прямо в тексте и переозвучивается заново — без нового брифа и без ожидания следующего дня.
Как сделать озвучку текста с эмоциями в Speakmi: пошаговая инструкция?
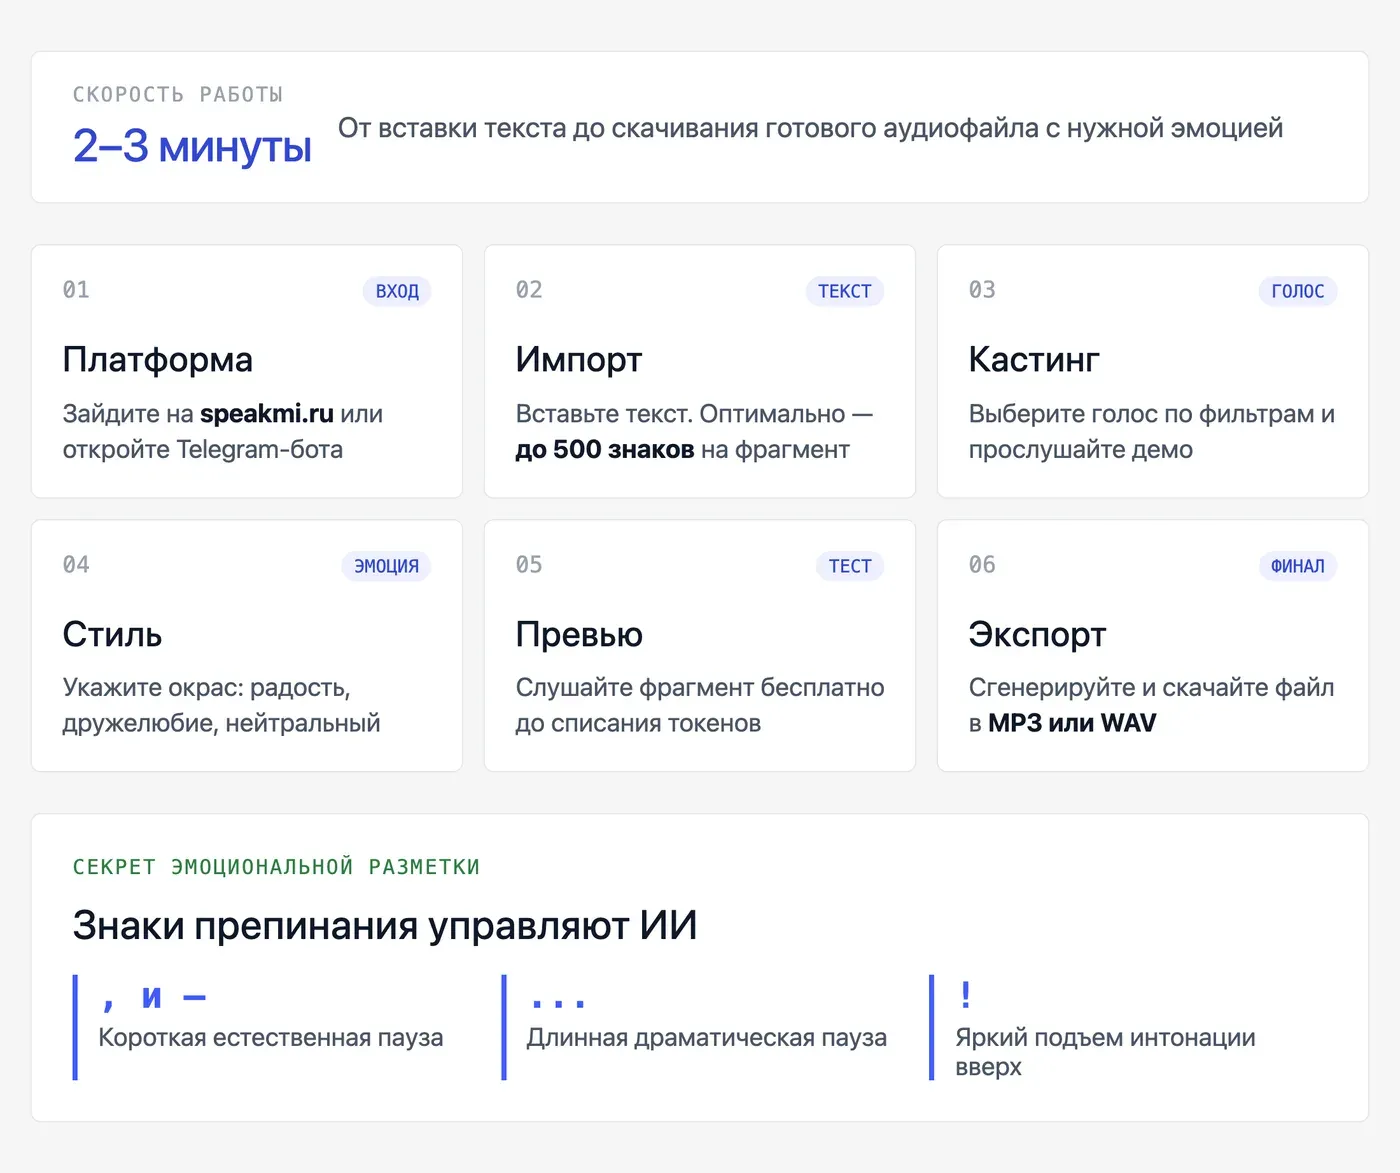
Весь процесс генерации занимает не более 2–3 минут при наличии готового текста. Пользователю достаточно вставить материал в поле ввода, выбрать подходящий голос и настроить эмоциональный окрас. Система мгновенно обработает запрос и выдаст готовый аудиофайл в нужном формате.
-
Зайти на speakmi.ru (или открыть Telegram-бот @speakmi_bot — интерфейс тот же, баланс общий).
-
Вставить текст в поле ввода. Оптимальная длина фрагмента — до 500 символов для сохранения эмоциональной целостности. Длинные тексты лучше разбивать по смысловым блокам.
-
Выбрать голос из библиотеки. Фильтр по полу, возрасту, тембру. Каждый голос можно прослушать на коротком примере до генерации.
-
Выбрать эмоциональный стиль — радость, уверенность, дружелюбный, нейтральный и другие варианты в зависимости от выбранного голоса.
-
Прослушать превью — короткий фрагмент без списания токенов. Если интонация не та — меняешь стиль или пунктуацию в тексте и слушаешь снова.
-
Сгенерировать полностью — токены списываются здесь. Файл готов через несколько секунд.
-
Скачать MP3 или WAV — оба формата доступны сразу после генерации.
Совет по тексту: расставляй запятые и тире там, где нужна пауза. Многоточие даёт более длинную паузу, восклицательный знак поднимает интонацию вверх. Знаки препинания — это и есть разметка для эмоциональной модели.
Где эмоциональная озвучка реально нужна: 5 сценариев для бизнеса и маркетинга?
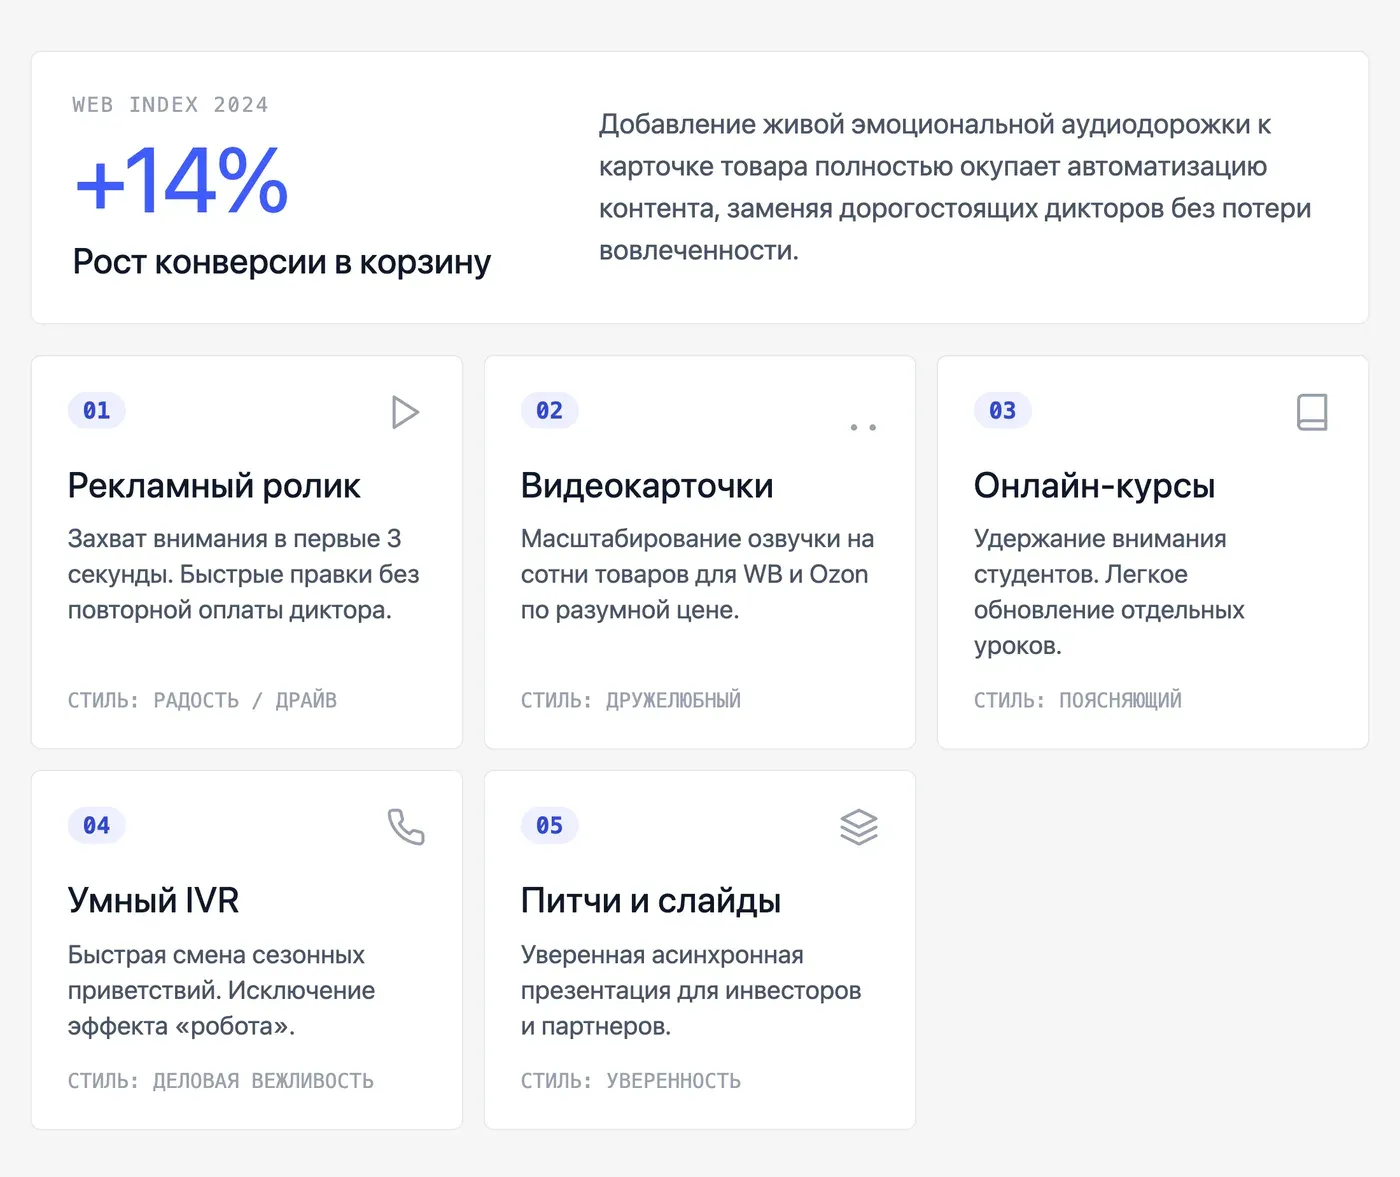
Внедрение живого ИИ-синтеза помогает компаниям автоматизировать создание контента без потери вовлечённости. Технология решает задачи там, где классический монотонный робот вредит конверсии, а наём диктора экономически нецелесообразен. По данным исследования Web Index за 2024 год, добавление качественной аудиодорожки к карточке товара увеличивает конверсию в корзину на 14%.
1. Рекламный ролик. Нужна энергия и позитив в первые 3 секунды — иначе зритель уходит. Стиль «радость» или «уверенность» в зависимости от продукта. Главный аргумент: ролик с живым голосом обходится в 5–10 раз дороже, а правки после монтажа — в отдельный счёт. С ИИ переписал строчку, переозвучил, загрузил снова.
2. Карточка товара на маркетплейсе. Wildberries и Ozon всё активнее показывают видеокарточки в выдаче. Голос «дружелюбный» снижает тревогу покупателя перед незнакомым товаром. При 50+ карточках в ассортименте ни один диктор не покроет объём по разумной цене.
3. Обучающий курс. Монотонный голос в курсе — главная причина, по которой студенты бросают на третьем уроке. Стиль «дружелюбный» с умеренным темпом держит внимание. Плюс: можно обновлять отдельные уроки без перезаписи всего курса.
4. IVR и автоответчик. Голос автоответчика формирует первое впечатление о компании. Стиль «официальный» для B2B, «дружелюбный» для B2C. Смена сезонного приветствия занимает 5 минут, не 2 дня.
5. Презентация для инвесторов. Питч с озвученными слайдами воспринимается серьёзнее, чем просто текст. Стиль «уверенность» — голос не выдаёт сомнений, даже если слайды ещё дорабатываются. Отправляешь запись асинхронно, инвестор слушает в удобное время.
Что влияет на качество эмоциональной озвучки: язык, модель, пунктуация?
Итоговое звучание зависит от синергии технологической базы и правильной подготовки исходного текста. Даже лучшая нейросеть не сможет выдать правильную интонацию без верной расстановки знаков препинания. Понимание этих факторов позволяет получать естественную речь с первой попытки.
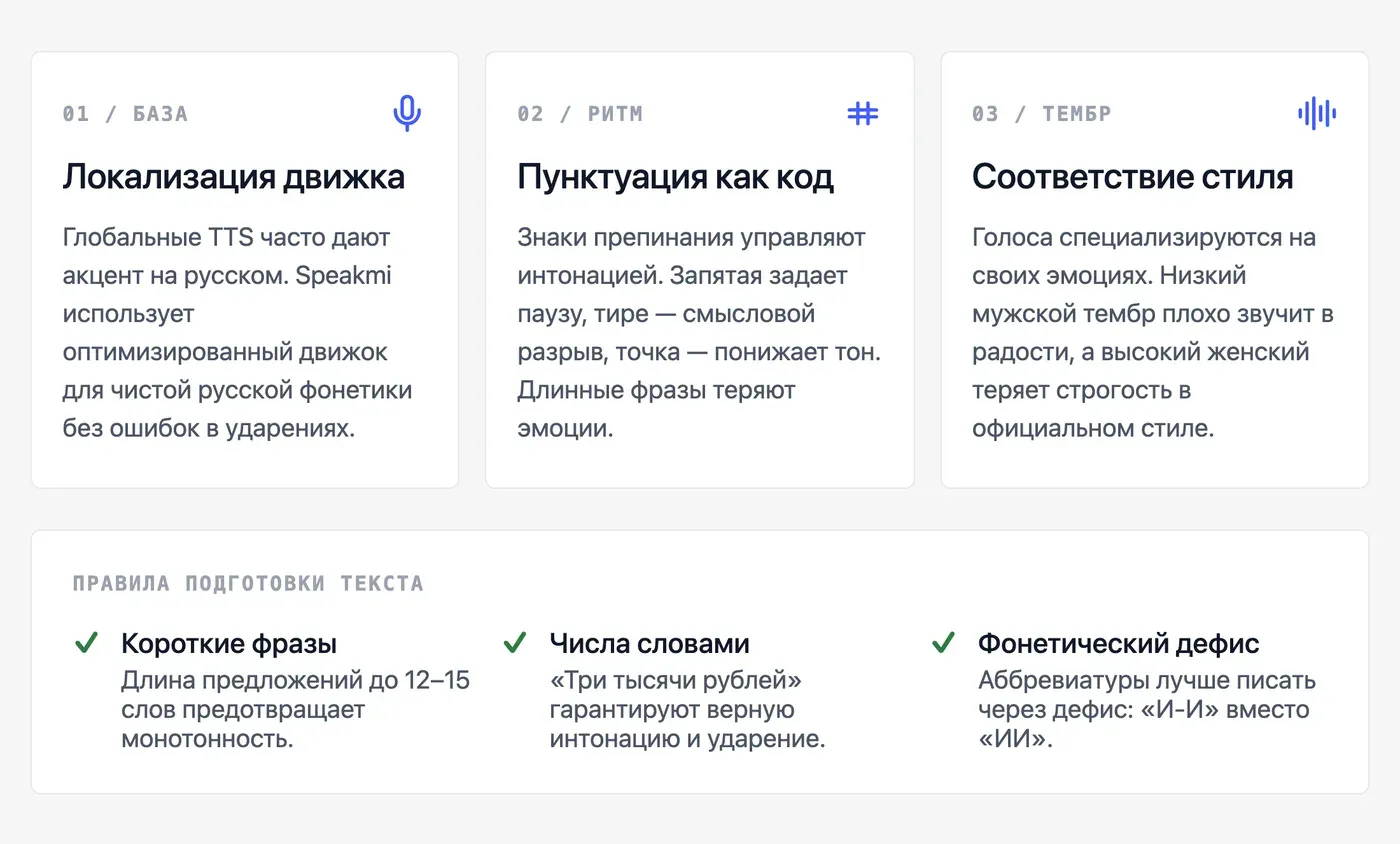
Качество TTS-модели на русском. Это главный фактор. Большинство известных глобальных сервисов (ElevenLabs, OpenAI TTS) обучены преимущественно на английском: русские тексты звучат с акцентом или неправильными ударениями, особенно на редких словах, аббревиатурах, датах (habr.com/ru/companies/tehrevizor/articles/1012688/, 2026). Speakmi работает на движке Fish Audio, оптимизированном под русскоязычный контент.
Fish Audio — товарный знак его правообладателя. Speakmi не является его представителем или партнёром; использует API Fish Audio как поставщика технологии синтеза речи.
Пунктуация и длина фразы. Модель читает знаки препинания как инструкции по интонации. Запятая — короткая пауза. Тире — смысловой разрыв. Точка — понижение голоса и полная пауза. Фразы длиннее 15–18 слов без знаков препинания модель «склеивает» в один интонационный блок — эмоция теряется. Короткие предложения с правильными знаками дают лучший результат, чем длинные с идеальной лексикой.
Выбор голоса под стиль. Не каждый голос одинаково хорошо держит все эмоциональные стили. Мужской голос с низким тембром плохо передаёт «радость» — звучит натужно. Женский голос с высоким тембром теряет убедительность в «официальном» стиле. Перед финальной генерацией стоит проверить 2–3 голоса в нужном стиле через превью.
Практические советы по тексту:
-
Разбивай длинные предложения на короткие — каждое до 12–15 слов
-
Расставляй запятые перед важными словами, которые нужно выделить
-
Числа пиши словами там, где важна интонация: «три тысячи рублей» звучит убедительнее, чем «3000»
-
Аббревиатуры расшифровывай или пиши через дефис: «И-И» вместо «ИИ»
Сколько стоит эмоциональная озвучка через ИИ по сравнению с диктором?
Стоимость генерации в сервисе Speakmi в десятки раз ниже стандартных дикторских ставок при мгновенном результате. Традиционная запись требует оплаты студийного времени и работы специалиста, тогда как ИИ тарифицирует только реальный объем текста. Это позволяет гибко планировать бюджет и вносить правки без дополнительных затрат.
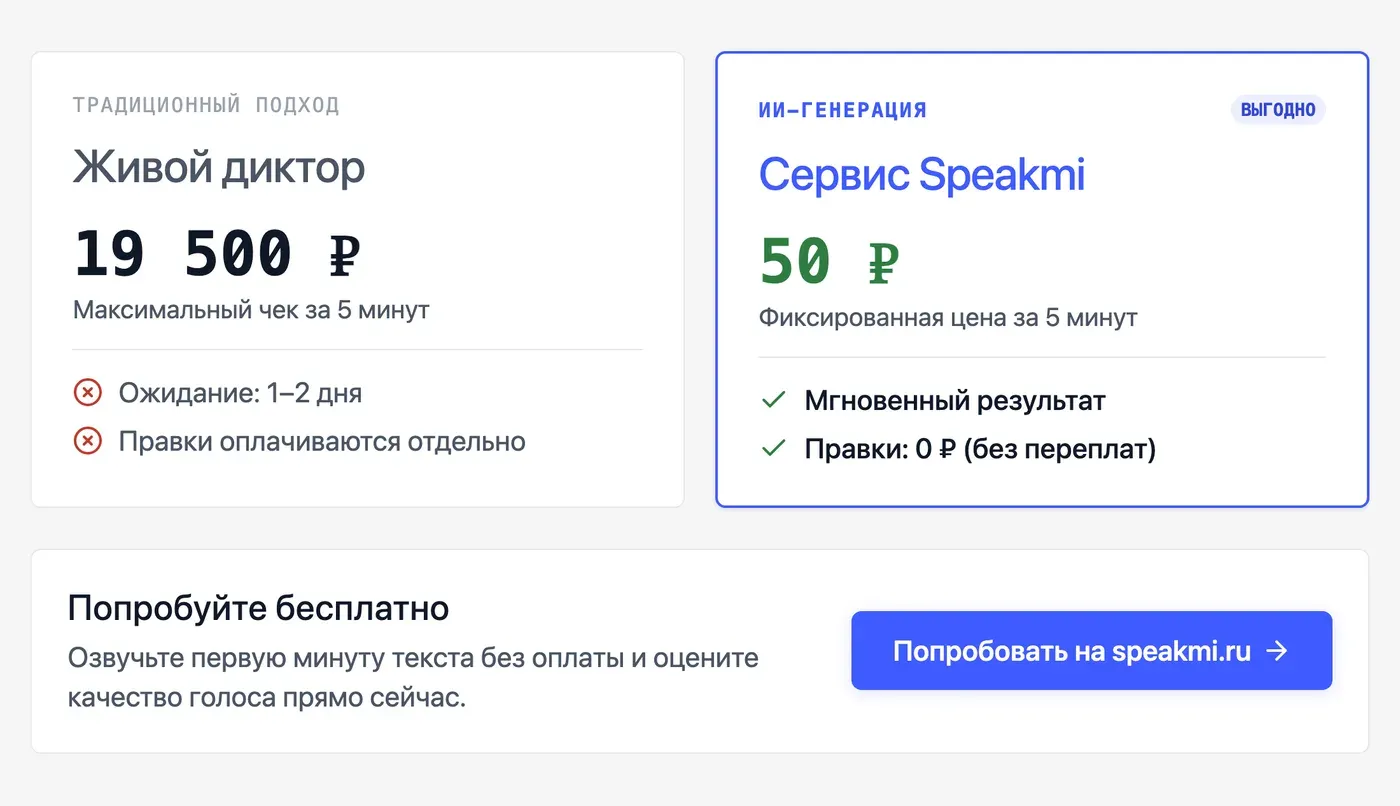
Диктор: 500–3 000 ₽ за минуту готового аудио + 1–2 дня ожидания + отдельная оплата правок. Типовой проект — 10 карточек товара по 30 секунд = 5 минут аудио. Нижняя граница: 5 × 500 = 2 500 ₽, верхняя — 15 000 ₽. Плюс если после монтажа нашлась ошибка — новый заказ от 500 ₽ за исправленную минуту.
Speakmi: ~6–10 ₽ за минуту готового аудио. Те же 5 минут = 30–50 ₽. Правки — бесплатно, токены списываются только за новую генерацию изменённого фрагмента, не за весь проект заново.
Расчёт на типовом проекте: 10 карточек товара по 30 секунд
| Статья расходов | Диктор | Speakmi |
|---|---|---|
| Озвучка | 2 500–15 000 ₽ | 30–50 ₽ |
| Ожидание | 1–2 дня | Мгновенно |
| 3 правки (типовой сценарий) | +750–4 500 ₽ | 0 ₽ |
| Итого | 3 250–19 500 ₽ | 30–50 ₽ |
Токены не сгорают: купил пакет — списывается только то, что реально озвучил, хоть за день, хоть за полгода. Прежде чем платить, можно озвучить первые 30 секунд текста бесплатно и оценить, подходит ли голос для рекламного ролика или карточки товара — попробовать на speakmi.ru.
Частые вопросы
- Может ли ИИ озвучить текст с эмоциями так же хорошо, как живой диктор?
- На коротких выразительных фразах — да, разница почти не слышна. На длинных художественных монологах с тонкими эмоциональными переходами профессиональный диктор пока даёт больше нюансов. Для рекламы, роликов и озвучки карточек современный ИИ-голос уже достаточно хорош и заметно быстрее и дешевле.
- Какие эмоции поддерживает ИИ-озвучка на русском языке?
- Базовый набор — радость, грусть, злость, удивление, шёпот и спокойствие, задаются тегами прямо в тексте. Точный список зависит от используемой модели, но основных эмоций достаточно для рекламы, роликов и диалогов с меняющейся по ходу фразы подачей. Список можно уточнить прямо в редакторе — там показаны доступные теги для выбранной модели голоса. Список можно уточнить прямо в редакторе — там показаны доступные теги для выбранной модели голоса.
- Как выбрать нужную эмоцию при озвучке текста онлайн?
- Подсказка ставится в квадратных скобках рядом с нужной фразой: [радостно], [грустно], [шёпотом]. Сама подсказка вслух не читается, она только меняет подачу этого конкретного места — поэтому в одном файле можно чередовать разные эмоции по ходу реплик персонажей. Перед финальной генерацией можно прослушать короткий фрагмент и при необходимости поменять эмоцию на месте. Перед финальной генерацией можно прослушать короткий фрагмент и при необходимости поменять эмоцию на месте.
- Можно ли сделать эмоциональную озвучку бесплатно?
- Да, первые 30 секунд озвучки в Speakmi бесплатны и не требуют карты — теги эмоций работают в этом лимите так же, как в платной генерации. Этого достаточно, чтобы протестировать несколько эмоций на своём тексте перед покупкой пакета. Дальше действуют пакеты токенов от 149 ₽ без подписки, если нужен больший объём текста. Дальше действуют пакеты токенов от 149 ₽ без подписки, если нужен больший объём текста.
- Почему обычный TTS звучит монотонно и как это исправить?
- Базовый TTS не управляет интонацией: читает текст с одинаковой скоростью и высотой голоса без учёта смысла. Исправить это можно двумя способами: перейти на эмоциональную модель, которая учитывает контекст, или использовать разметку текста — знаки препинания, короткие предложения, паузы через тире.
- Подходит ли эмоциональная озвучка для рекламы и карточек товаров?
- Да, это один из самых частых сценариев. Голос с позитивной интонацией в рекламном ролике повышает запоминаемость бренда; дружелюбный голос в карточке товара снижает тревогу покупателя. При серийном производстве (10+ карточек) ИИ-озвучка выигрывает у диктора и по цене, и по скорости правок.
- Как быстро можно получить готовый файл с эмоциональной озвучкой?
- Генерация занимает секунды — время зависит от длины текста, а не от количества использованных эмоциональных тегов. Короткая рекламная фраза озвучивается почти мгновенно, сценарий на несколько тысяч знаков — за десятки секунд, очереди на обработку нет. Ожидание в очереди отсутствует даже в пиковые часы — обработка идёт параллельно для всех пользователей. Ожидание в очереди отсутствует даже в пиковые часы — обработка идёт параллельно для всех пользователей.