Голос для ИИ-аватара: как озвучить говорящего аватара своим голосом
Как добавить голос ИИ-аватару: клонирование своего голоса, выбор модели и сервиса. Пошаговый гайд для аватара в видео и Reels. Озвучить текст можно в Спикми.
Что такое говорящий ИИ-аватар и почему ему нужен отдельный голос
Говорящий ИИ-аватар — это анимированный персонаж, у которого движение губ и мимика синхронизированы с аудиодорожкой. Аватарные сервисы (HeyGen, D-ID и подобные) отвечают только за визуальную часть: они берут фото или шаблон персонажа и «оживляют» его под поданное аудио. Голос при этом нужно подготовить отдельно.
У большинства таких платформ есть встроенные голоса, но русский язык они поддерживают слабо — интонации неестественные, ударения съезжают. Поэтому для русскоязычного контента аудиодорожку готовят в отдельном TTS-сервисе, а потом загружают в аватарный сервис или монтируют в редакторе.
Аватар по фото работает по той же схеме: загружаешь снимок, подаёшь аудио — нейросеть анимирует губы под запись. Без качественной русской дорожки даже хороший визуал будет смотреться неубедительно.
Три способа дать голос ИИ-аватару: встроенный TTS, сторонний сервис или клон своего голоса
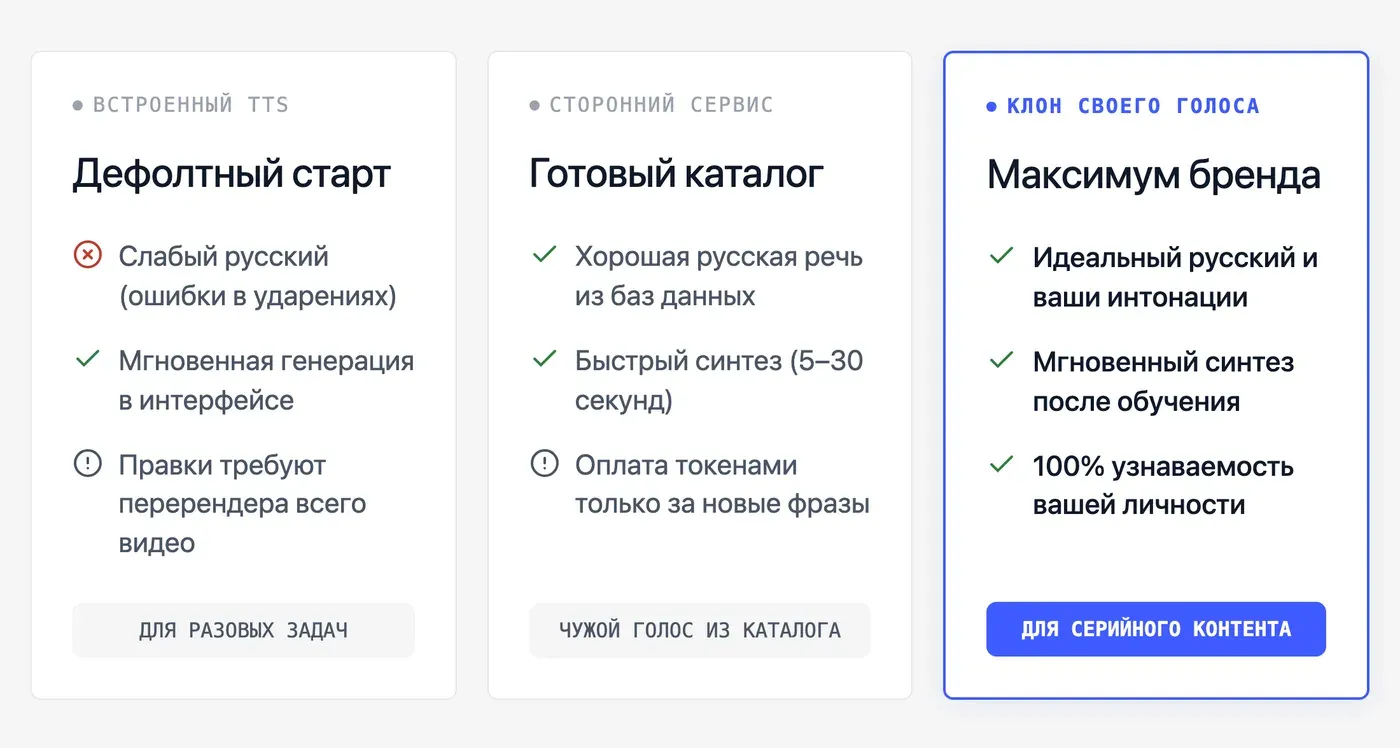
Выбор зависит от задачи: разовый ролик или серия, нужна узнаваемость голоса или нет, важна скорость или качество на русском.
| Способ | Качество русской речи | Скорость получения файла | Стоимость правки одной фразы | Узнаваемость голоса |
|---|---|---|---|---|
| Встроенный TTS аватарного сервиса | Слабое — ударения и интонации часто ломаются | Мгновенно, в том же интерфейсе | Бесплатно, но перегенерация всего ролика | Нет — дефолтный нейросетевой голос |
| Сторонний TTS-сервис, готовый голос | Хорошее при выборе русскоязычного каталога | 5–30 секунд на короткий текст | Несколько токенов, только дорожка | Нет — чужой голос из каталога |
| Клон своего голоса | Хорошее — голос обучен на твоей речи | Несколько минут на создание клона, потом мгновенно | Несколько токенов, только дорожка | Да — узнаваемо похоже на тебя |
Для разового ролика подойдёт любой голос из каталога — выбираешь подходящий по тембру и готово. Для серийного контента клон выгоднее: один раз создаёшь голос, дальше на каждый выпуск только вставляешь новый текст без повторной записи. Если публикуешь сериями — один раз сохраняешь голос в «Мои голоса» и дальше просто вставляешь новый текст на каждый выпуск, без повторной записи.
Подробнее о том, как подобрать голос персонажа для видео — в отдельном материале.
Как клонировать свой голос для аватара: требования к записи
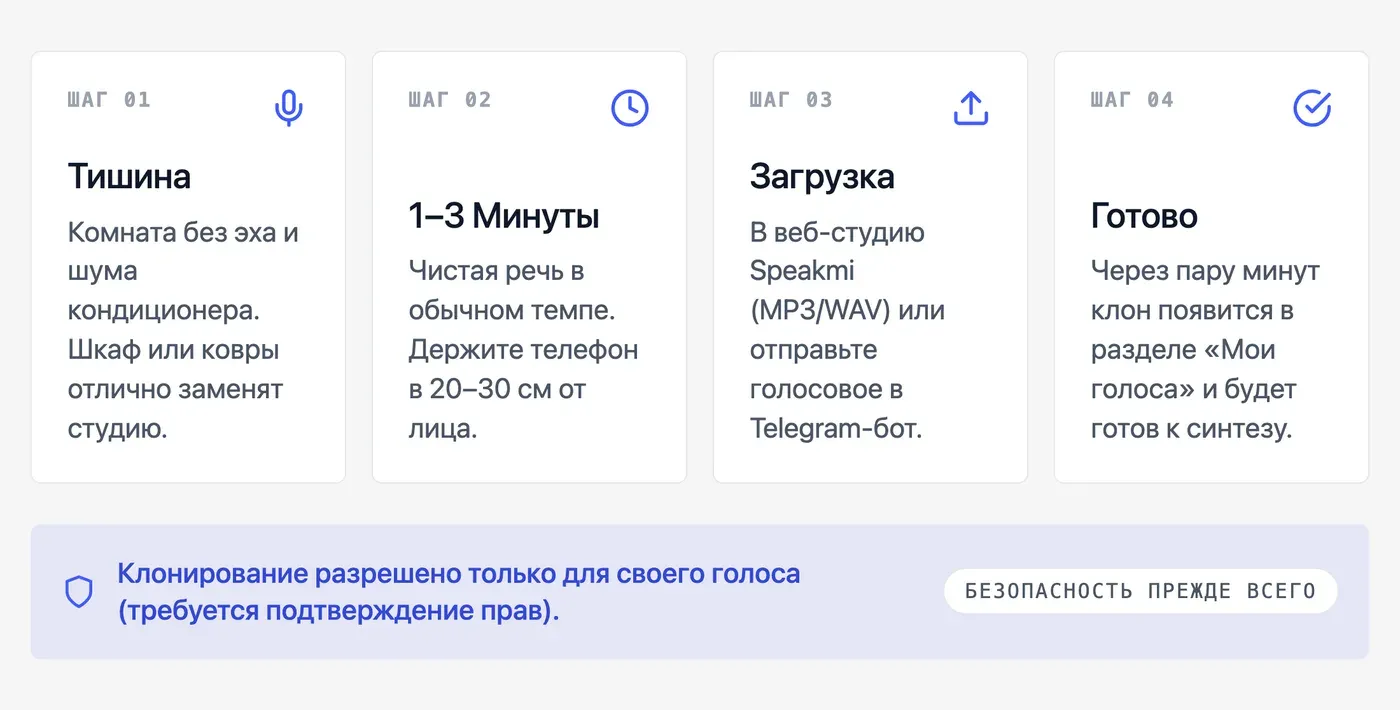
Качество клона напрямую зависит от качества исходной записи. Если в образце есть шумы или эхо — нейросеть клонирует их вместе с голосом, и артефакты будут проявляться на каждой генерации. Поэтому запись делается один раз, но правильно.
Шаг 1. Найди тихое место.
Закрытая комната без музыки, кондиционера и уличного шума. Не нужна студия — подойдёт шкаф с одеждой или комната с коврами и шторами. Фоновые звуки в записи — главная причина роботизированного клона.
Шаг 2. Запиши 1–3 минуты чистой речи.
Читай вслух в обычном темпе — не слишком медленно и не слишком быстро. Никакой фоновой музыки. Оптимальная длина по практике — около минуты чистых реплик. Если записываешь с телефона — держи его в 20–30 сантиметрах от лица, не прижимай к губам.
Шаг 3. Загрузи запись в Speakmi.
В веб-студии — раздел «Мои голоса» → «Клонирование». В Telegram-боте — просто отправь голосовое сообщение, бот сам предложит создать клон. Принимаются форматы MP3 и WAV.
Шаг 4. Подожди несколько минут.
Клон появится в разделе «Мои голоса». Свежий клон попадает в «Диалог» тоже через несколько минут — сразу после создания он там ещё недоступен.
Клонировать можно только свой голос или голос с подтверждением прав. Результат — «узнаваемо похоже на тебя», не обещание стопроцентной копии.
Как озвучить ИИ-аватара в Speakmi: пошаговая инструкция
Speakmi генерирует аудиодорожку из текста — готовый MP3 или WAV загружается в аватарный сервис или монтируется в редакторе. Вот полный путь от регистрации до файла.
Шаг 1. Зарегистрируйся на speakmi.ru — первые 30 секунд бесплатно, карта не нужна.
Шаг 2. Загрузи запись голоса и создай клон: «Мои голоса» → «Клонирование» → выбери файл → несколько минут ожидания.
Шаг 3. Вставь текст реплики аватара в редактор. Не загружай весь сценарий целиком — короткие фразы дают лучший контроль над интонацией и темпом.
Шаг 4. Выбери модель: S2.1 Pro — ровная дикция, предсказуемый результат; Drama 3 — эмоции и режиссура через пометки в квадратных скобках.
Шаг 5. При необходимости добавь режиссуру — пометку перед фразой, как её сыграть: [спокойно, уверенно] Добро пожаловать на канал. Пометка вслух не читается, меняет только подачу.
Шаг 6. Скачай MP3 или WAV. Правка — это новая генерация, не редактирование куска: планируй текст заранее, чтобы не переделывать по слову.
В каталоге Спикми 914 голосов (на ноябрь 2026) — фильтруй по полу, возрасту и манере, прослушивай демо, сохраняй понравившийся в «Мои голоса». Пакеты токенов от 149 ₽, токены не сгорают, оплата картой РФ. Для быстрого старта — Telegram-бот: отправляешь голосовое, получаешь клон без загрузки файлов.
Speakmi озвучивает текст и клонирует голос; приложения для практики английского с похожим названием — другой продукт.
Ровный или эмоциональный голос: какую модель выбрать под формат аватара
Две модели — под разные задачи. Выбор зависит от формата видео, а не от личных предпочтений.
S2.1 Pro — для обучающих роликов, корпоративных аватаров, карточек товаров.
Ровная дикция, стабильный результат от дубля к дублю. Подходит там, где важна чёткость и предсказуемость: инструкции, презентации, товарные видео. Дубли почти не отличаются друг от друга — удобно при серийном производстве.
Drama 3 — для Reels, сторис, развлекательного контента.
Модель Fish Audio, в Speakmi с 14 октября 2026 года. Плачет, злится, смеётся, держит паузы — эмоции задаются режиссурой в квадратных скобках прямо в тексте:
-
[радостно, немного взволнованно]— для анонсов и приветствий -
[серьёзно, с нажимом]— для важных тезисов -
[тихо, с паузой]— для драматических моментов
Метки на выделенных словах — шёпотом, с акцентом, мягко — меняют подачу только конкретного слова, не всей фразы.
Отличие Drama 3 от S2.1 Pro: дубли сильнее отличаются друг от друга — неудачный просто генерируют заново. Зато точнее справляется с трудными словами (93,2% против 88,1% по тесту Artificial Analysis) и быстрее отвечает на короткой фразе (1,5–3 секунды против 4–5 секунд, замер Speakmi). До 12 ноября 2026 — по цене обычной озвучки.
Пение голосом аватара Speakmi не поддерживает — только речь. Для озвучки сторис без микрофона — отдельный материал про озвучку сторис без микрофона.
Как наложить голос на говорящего аватара: финальная сборка в редакторе
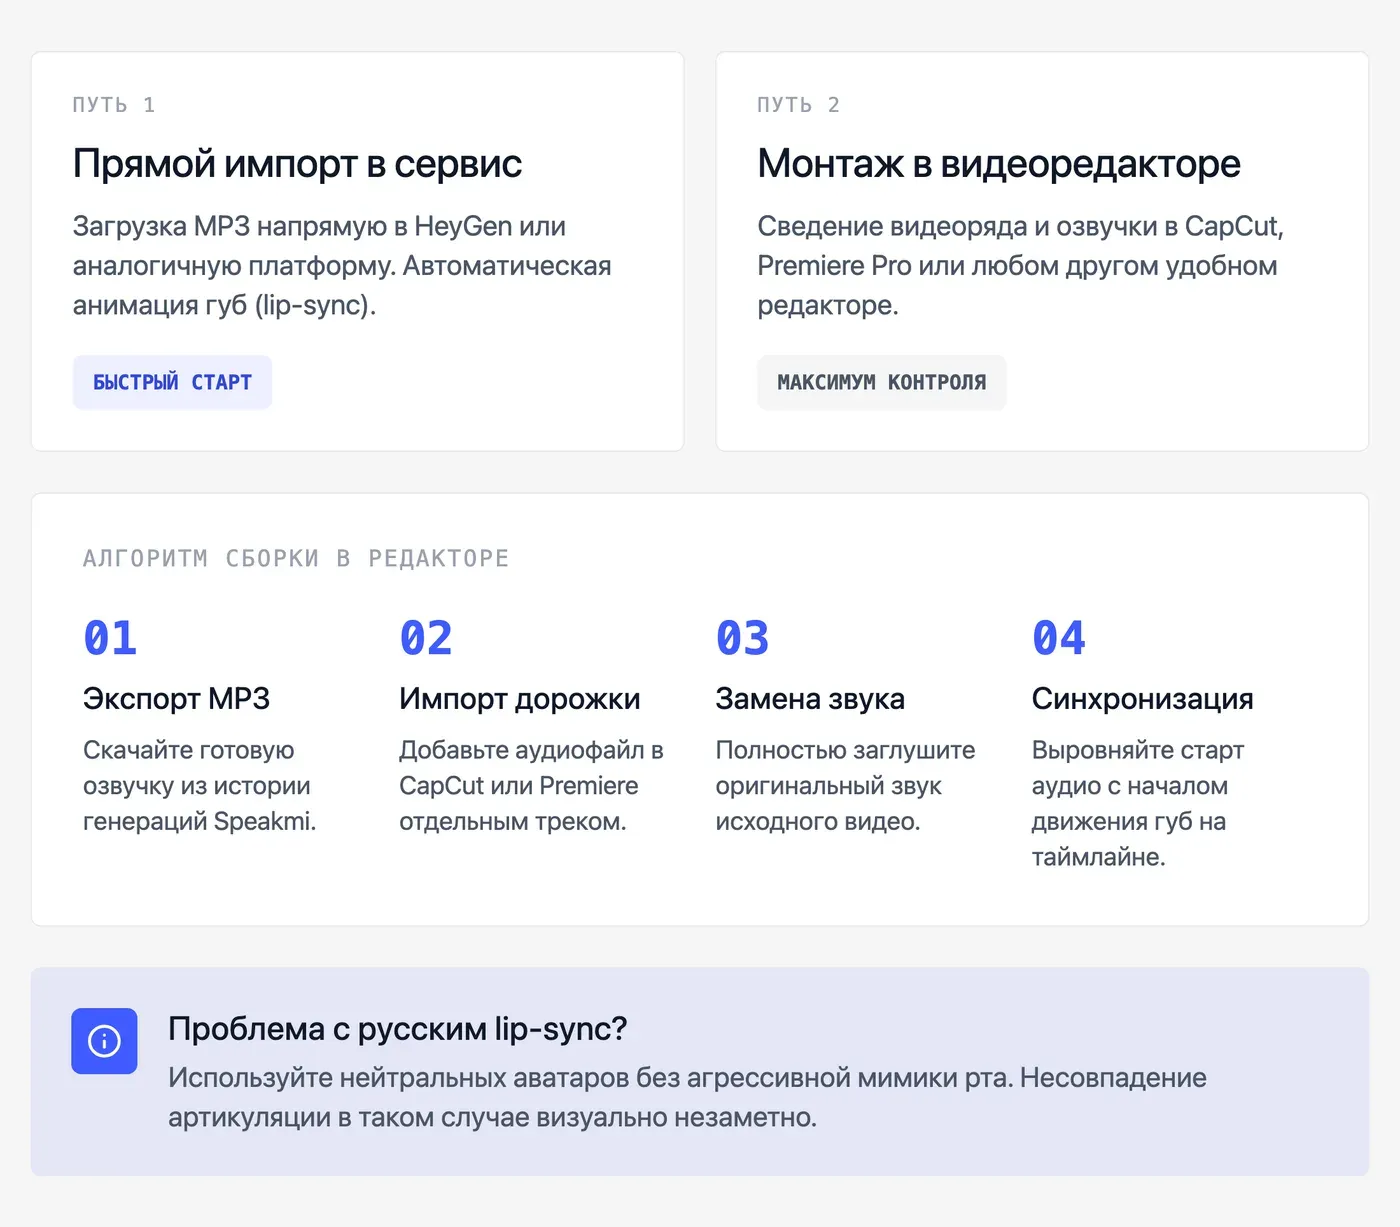
Аудиофайл из Speakmi — обычный MP3 или WAV. Дальше два пути в зависимости от рабочего процесса.
Путь 1: загрузка напрямую в аватарный сервис.
Платформы типа HeyGen принимают аудиофайл напрямую — загружаешь MP3 в интерфейс, сервис сам анимирует губы под дорожку. Это самый быстрый способ, если lip-sync поддерживает русский язык.
Путь 2: монтаж в видеоредакторе.
-
Скачай MP3 из Спикми на компьютер — кнопка скачивания в разделе «История» рядом с нужной генерацией.
-
Открой видео аватара в CapCut, Premiere или любом другом редакторе.
-
Импортируй MP3 как отдельную аудиодорожку.
-
Замени или заглуши исходную дорожку аватара.
-
Выровняй аудио по началу движения губ — обычно это нулевая метка таймлайна.
Если аватар не поддерживает русский lip-sync точно — используй нейтральный аватар без жёсткой привязки к движению губ: разрыв будет менее заметен. Подробнее о том, как заменить голос в ролике целиком, — в отдельном материале.
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Частые ошибки при озвучке ИИ-аватара: почему голос не совпадает с движением губ
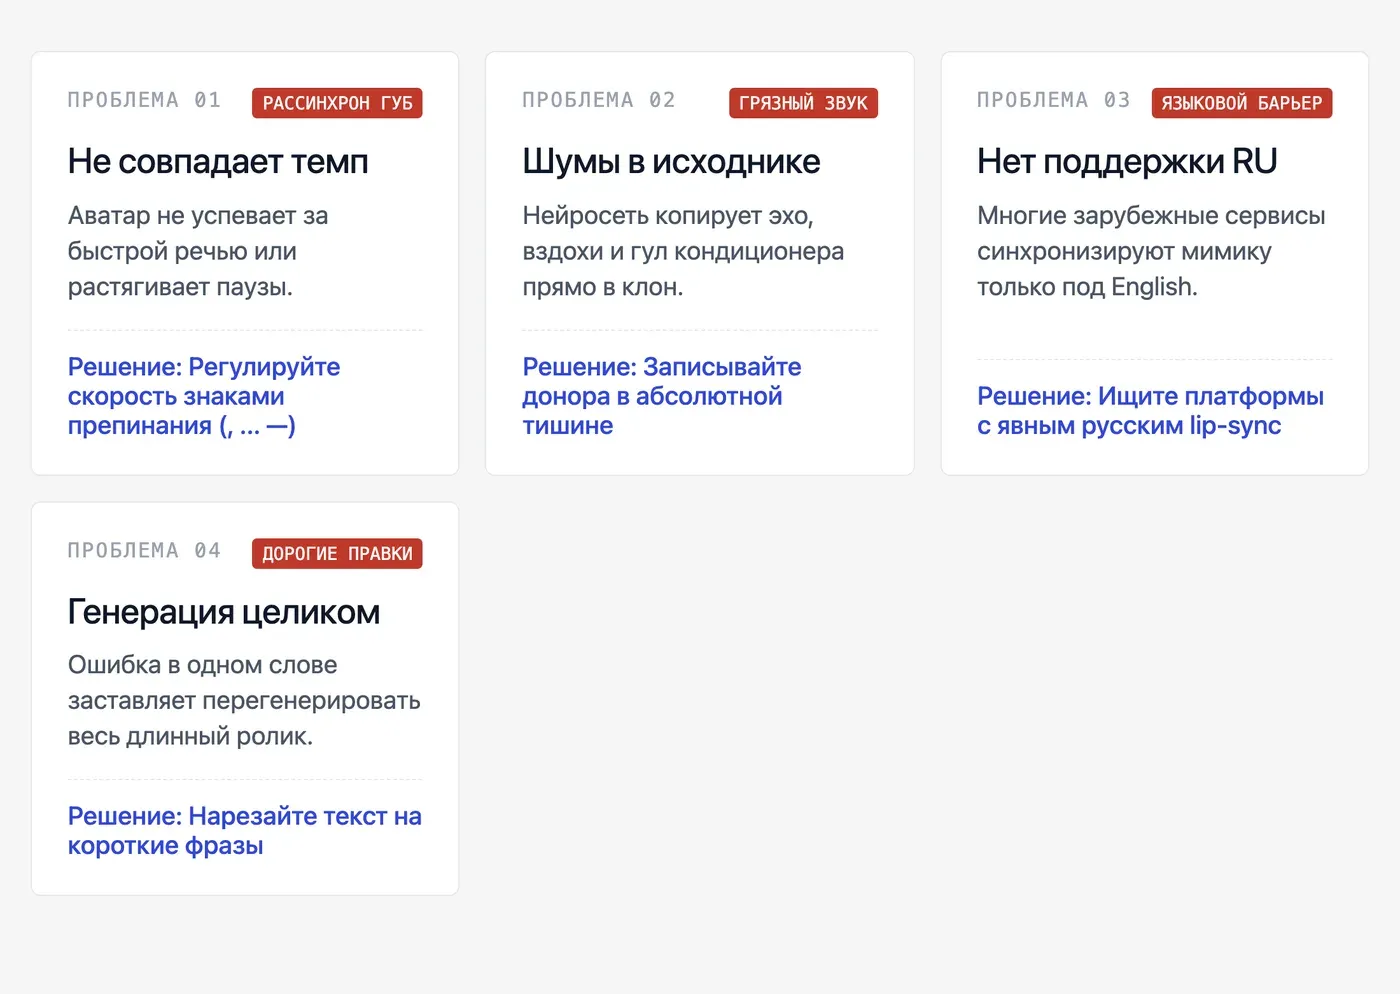
Большинство проблем с lip-sync и качеством голоса решаются на этапе подготовки, а не после публикации.
-
Темп речи не совпадает с анимацией. Аватарный сервис анимирует губы под конкретный темп — если дорожка быстрее или медленнее шаблона, губы разъезжаются. Решение: подобрать темп в настройках аватарного сервиса или перегенерировать с другим темпом. Регулировать скорость речи в тексте можно знаками препинания — запятыми, троеточиями, переносами строки.
-
Клон звучит тихо или с артефактами. Причина — шумы в исходной записи: кондиционер, эхо, музыка. Нейросеть клонирует шум вместе с голосом. Решение: перезаписать исходник в тишине.
-
Аватар не поддерживает русский lip-sync. Часть аватарных платформ хорошо синхронизирует губы только с английским. Решение: выбрать нейтральный аватар без точного lip-sync или найти сервис с явной поддержкой русского языка.
-
Правка одного слова требует новой генерации. Это нормально — так работают все TTS-сервисы. Поправить кусок дубля нельзя, запись делается заново. Планируй текст заранее и генерируй короткими фразами, а не всем сценарием сразу — тогда переделывать придётся только один кусок, а не всё.
-
Неестественные паузы в середине фразы. Часто причина — лишняя точка или опечатка в тексте. ИИ делает паузу на каждой точке. Убирай лишние знаки препинания, имена пиши с маленькой буквы, если они вызывают неожиданное ударение.
-
Исходная дорожка записана с шумами и вздохами. ИИ переносит все дефекты и интонацию на клон целиком. Если дорожка для клонирования записана медленно, с частыми вздохами или в шумном месте — именно так и будет звучать каждая генерация.
Частые вопросы
- Как сделать диалог из нескольких голосов?
- На сайте Speakmi есть раздел «Диалог» (speakmi.ru/app/dialogue, меню «Создать»): до 5 ролей в одной сцене, у каждой свой голос из каталога или клон. Вставляешь сценарий в формате «Имя: реплика», роли создаются автоматически, на выходе — один аудиофайл. В Telegram-боте диалогов нет — только одиночная озвучка.
- Как скачать готовый аудиофайл на компьютер?
- В веб-студии Speakmi — открой раздел «История», найди нужную генерацию и нажми кнопку скачивания рядом с ней. Файл сохраняется в MP3 или WAV на твой компьютер. В Telegram-боте готовый файл приходит прямо в чат — нажми на него и выбери «Сохранить».
- Что такое Speakmi?
- Speakmi — сервис ИИ-озвучки текста и клонирования голоса на русском, работает как веб-студия и Telegram-бот на одной базе. Движок — Fish Audio. Первые 30 секунд бесплатно без карты, дальше пакеты токенов от 149 ₽, токены не сгорают. Распознавания речи и публичного API у Speakmi нет.
- Можно ли озвучить ИИ-аватара бесплатно?
- Да, первые 30 секунд озвучки в Спикми бесплатно и без карты — можно проверить, как звучит голос на реальном тексте реплики аватара, прежде чем платить. Для короткого Reels или одной сцены этого часто хватает. Дальше — пакеты токенов от 149 ₽, токены не сгорают.
- Сколько времени занимает клонирование голоса для аватара?
- Запись образца — 1–3 минуты речи. Загрузка и создание клона в Speakmi — несколько минут ожидания после загрузки файла. Итого от начала записи до первой генерации своим голосом — около 10–15 минут при хорошем исходнике. Если клон создан в Telegram-боте — просто отправляешь голосовое сообщение, файл загружать не нужно.
- Подойдёт ли клонированный голос для серии видео с аватаром?
- Да, это основной сценарий использования клона. Голос сохраняется в «Мои голоса» и доступен на каждой сессии — вставляешь новый текст, генерируешь дорожку, скачиваешь. Повторная запись не нужна. Голос звучит одинаково от выпуска к выпуску, что важно для узнаваемости канала.
- Можно ли использовать чужой голос для озвучки аватара?
- Клонировать чужой голос без согласия нельзя — ни голос знаменитости, ни голос другого человека. Speakmi принимает только свой голос или запись с подтверждением прав. Из готового каталога в 914 голосов (на ноябрь 2026) можно выбрать любой и использовать его для озвучки аватара без ограничений.