Голос робота человека: какой выбрать и как озвучить текст онлайн
Сравниваем голоса роботов: Алиса, нейросети и ИИ-сервисы. Какой голос робота звучит естественнее и подойдёт для озвучки текста онлайн — разбираем в 2026.

Что такое «голос робота» и почему он снова в тренде у контент-мейкеров?
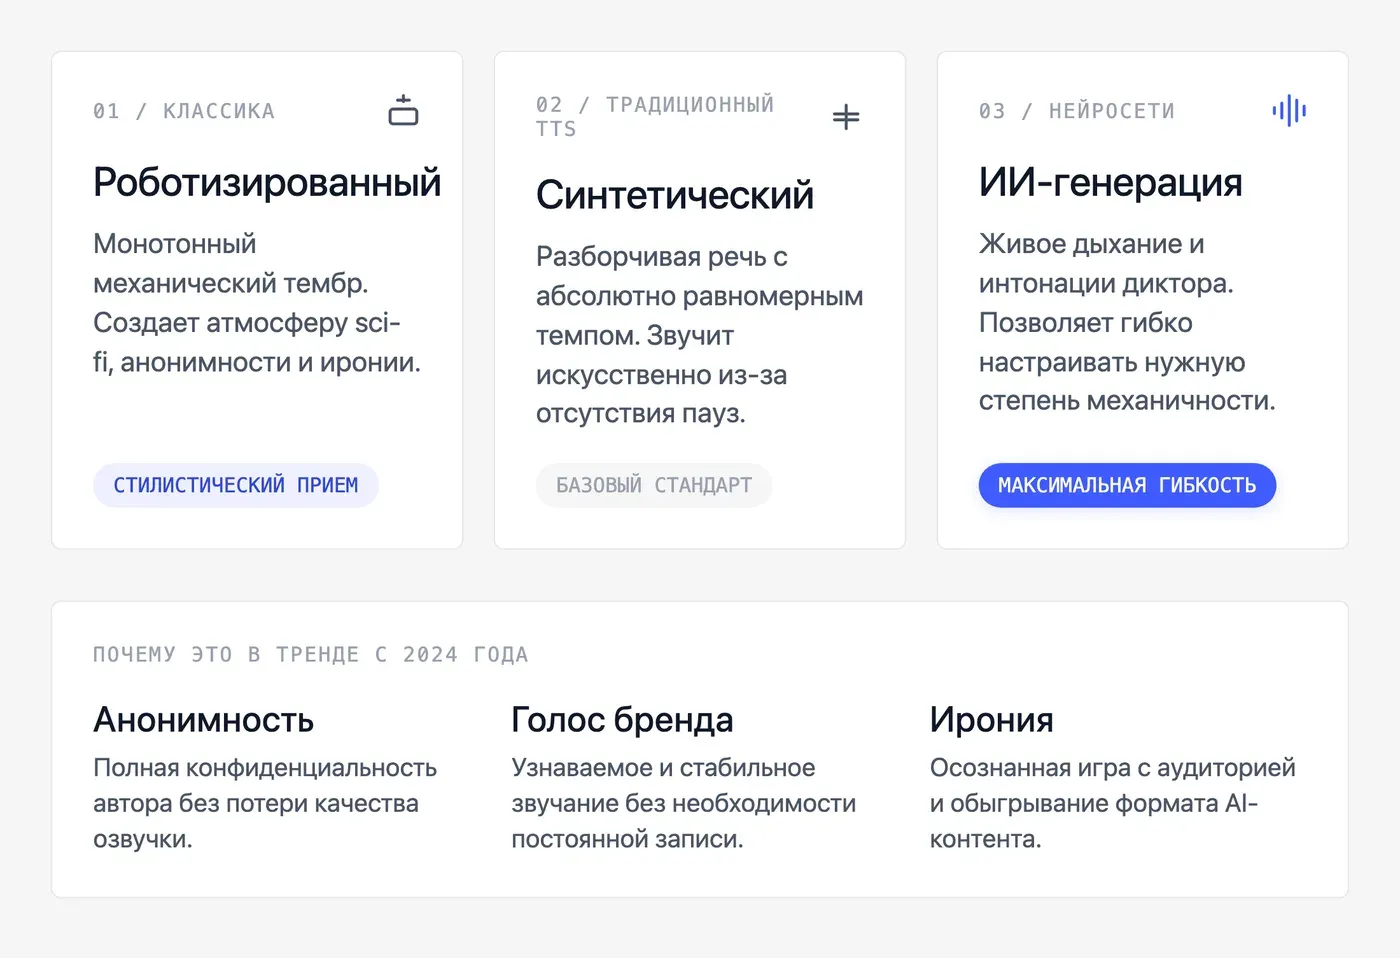
Коротко: «голос робота» — это не одно явление, а три разных, и контент-мейкеры сейчас намеренно выбирают одно из них как стилистический приём. Роботизированный голос ассоциируется с sci-fi, анонимностью или ироничным стилем канала. Традиционный TTS звучит искусственно из-за равномерного темпа, а современный ИИ-голос позволяет гибко настраивать интонации и степень механичности.
Роботизированный голос — классика: монотонный, без интонации, с характерным «механическим» тембром. Узнаётся мгновенно, ассоциируется с sci-fi, анонимностью или ироничным стилем канала.
Синтетический голос (TTS) — результат работы традиционных движков: речь разборчива, но звучит искусственно из-за равномерного темпа и отсутствия живых пауз. Это то, что большинство людей называют «голосом робота» в нейтральном смысле.
ИИ-голос — нейросетевая генерация: паузы, дыхание, интонация близки к живому диктору. Можно намеренно настроить под «механический» тембр — и тогда получится роботизированный звук, но без деревянного ритма старого TTS.
Тренд на намеренно роботский звук вернулся в YouTube-обзоры, Reels и Telegram-каналы примерно с 2024 года. Причины простые: анонимность, узнаваемый «голос бренда» без записи, и ирония над самим форматом AI-контента, которую аудитория считывает и принимает.
Чем голос робота Алиса и другие голоса ассистентов отличаются от ИИ-озвучки?
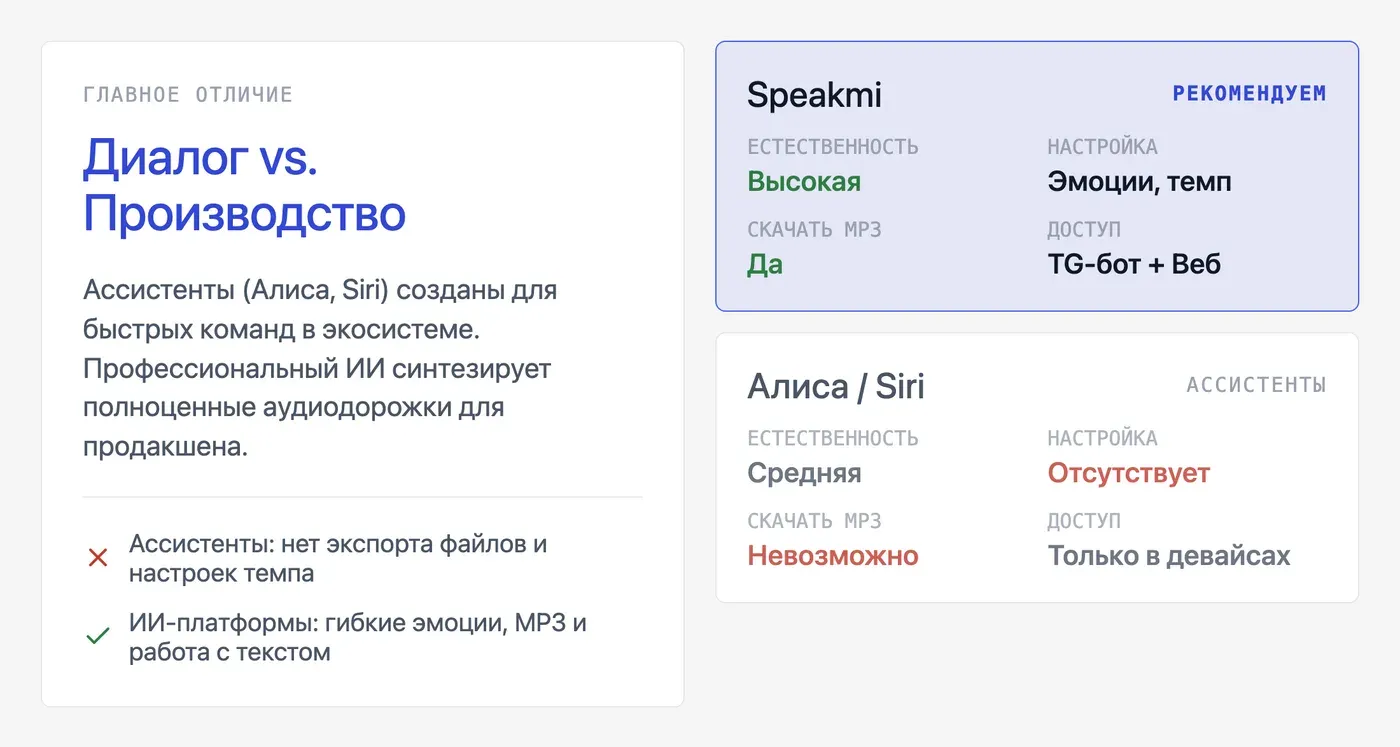
Коротко: голоса ассистентов заточены под диалог и команды — они не дают файл, не настраиваются под контент и не масштабируются на серийное производство. Для создания полноценных роликов они не подходят из-за технических ограничений. Профессиональные ИИ-платформы, напротив, позволяют скачивать готовые MP3-файлы и гибко управлять тембром.
| Сервис | Естественность | Настройка тембра/темпа | Скачать MP3 | Русский язык | Доступ через бот / без регистрации |
|---|---|---|---|---|---|
| Алиса (Яндекс) | Средняя | Нет | Нет | Да | Нет — только внутри устройств Яндекса |
| Google TTS | Средняя | Минимальная (SSML) | Через API | Да | API, нужен ключ |
| Siri (Apple) | Средняя | Нет | Нет | Да | Нет — только устройства Apple |
| Speakmi | Высокая | Да — эмоции, темп | Да, MP3 | Да | Да — Telegram-бот + веб |
| SteosVoice / CyberVoice | Средняя–высокая | Да — роботский тембр отдельно | Да | Да | Да — бесплатный доступ заявлен |
| ElevenLabs | Высокая | Да — широкая | Да | Да | Веб, от $22/мес |
| ERA2 Voice | Высокая | Да | Да | Да | Веб, 300 символов бесплатно |
Алиса, Siri и Google TTS — это голоса для ответа на вопрос «который час», а не для озвучки трёхминутного ролика. У них нет функции «скачать дорожку», нет настройки под конкретный стиль и нет интерфейса для работы с длинными текстами.
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi (Спикми), вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Какой голос робота звучит наиболее человечно в 2026 году?
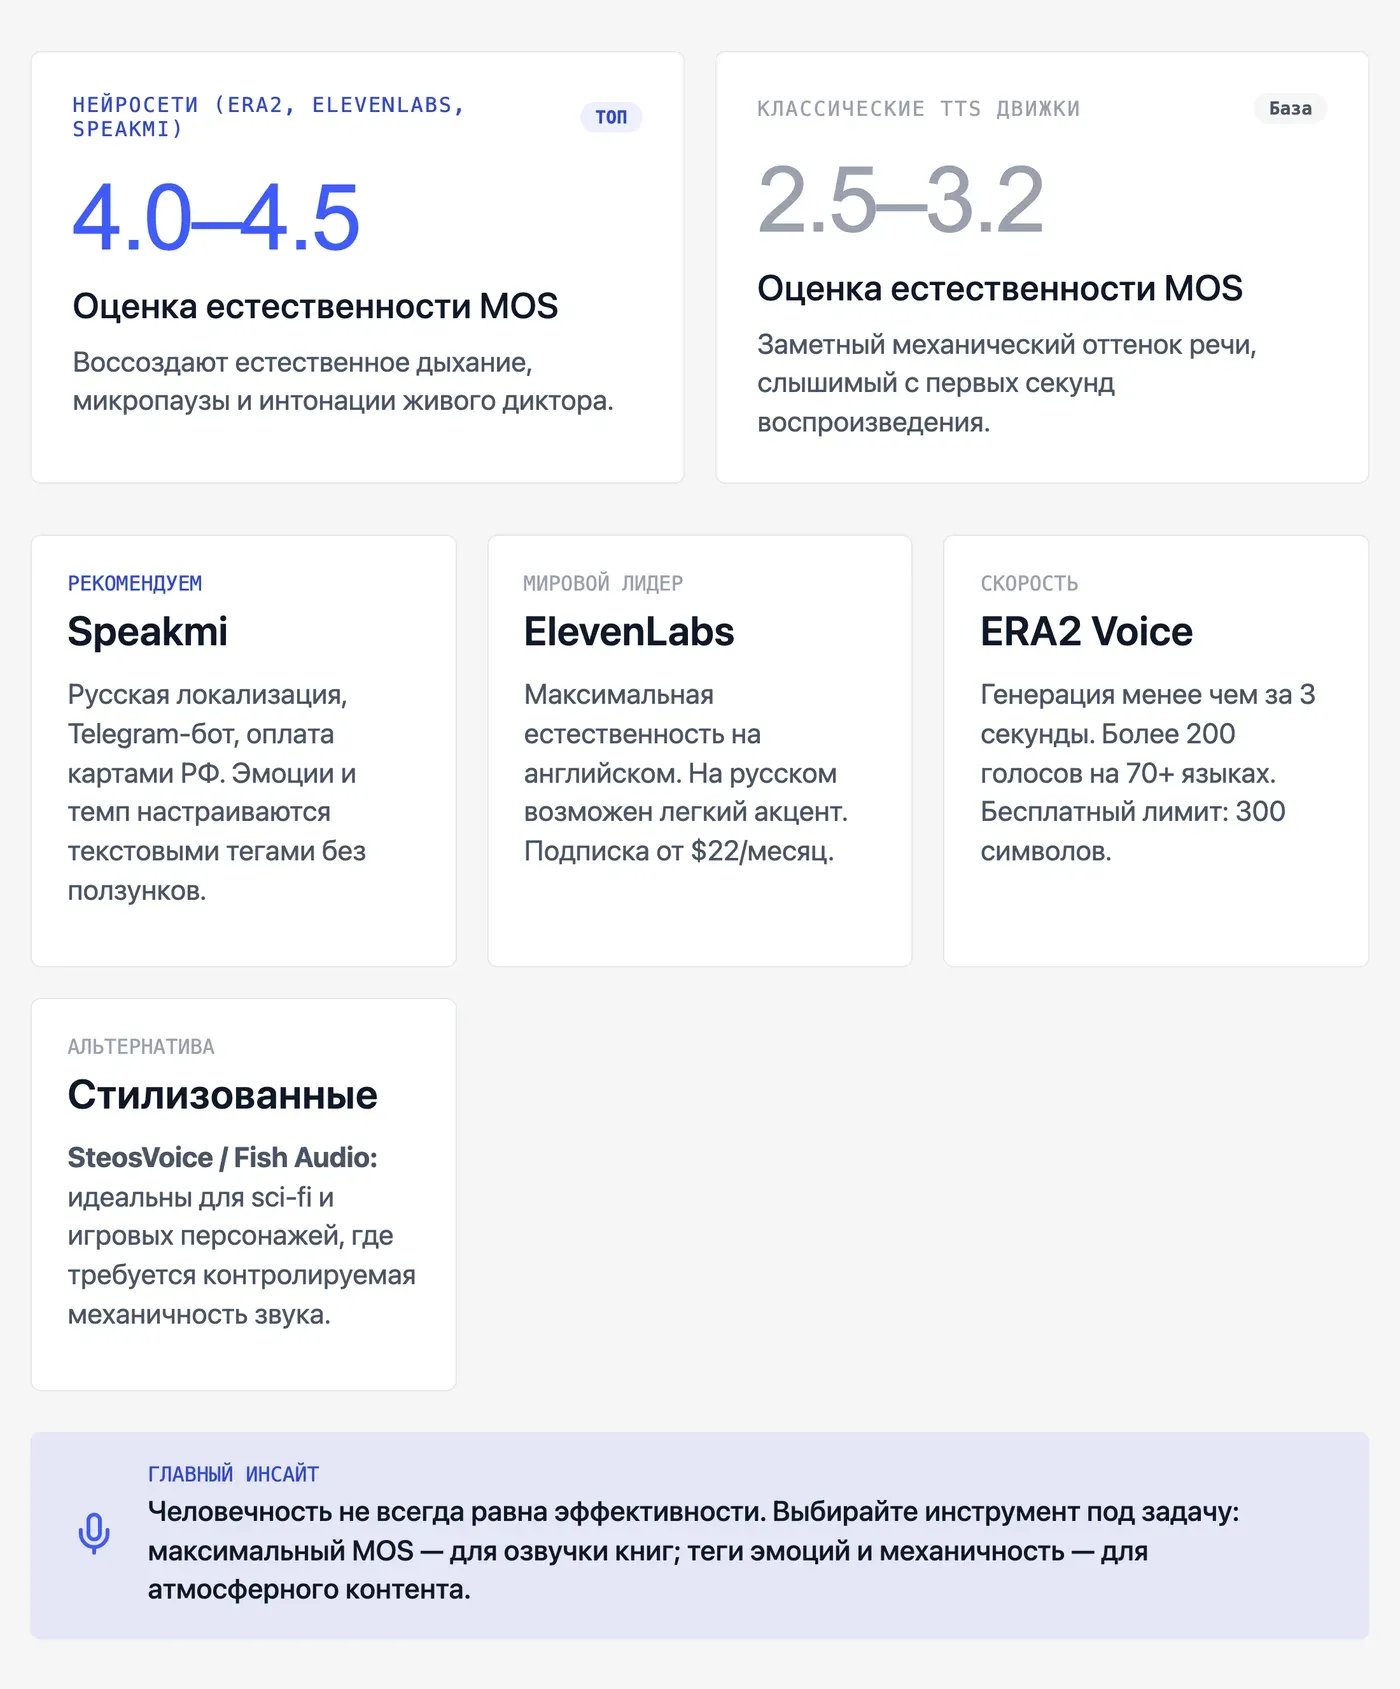
Коротко: нейросетевые голоса ERA2, ElevenLabs и Speakmi заметно оторвались от классических TTS — разница слышна на первых же секундах. Они используют глубокие нейросети для воссоздания естественного дыхания и микропауз. Это позволяет генерировать речь, которую сложно отличить от работы профессионального диктора.
Открытые A/B-тесты движков на русском языке (включая Yandex SpeechKit v3) фиксируют это через MOS — Mean Opinion Score, оценку естественности от 1 до 5 по слушательскому голосованию. Нейросетевые движки стабильно набирают 4,0–4,5, классические TTS — 2,5–3,2.
Несколько ориентиров по доступным сервисам:
-
ElevenLabs — признанный лидер по естественности на английском, на русском звучит хорошо, но с лёгким акцентом у части голосов. Тарифы от $22/мес (данные на май 2026).
-
ERA2 Voice — заявляет генерацию за менее чем 3 секунды, 200+ голосов, 70+ языков. Бесплатно: 300 символов.
-
Speakmi — работает на движке Fish Audio¹, русская локализация, Telegram-бот, оплата картой РФ. Настройка эмоций тегами прямо в тексте, без ползунков.
-
SteosVoice / CyberVoice — отдельная категория «роботизированный голос», бесплатный доступ заявлен как постоянный.
-
Fish Audio — платформа с пользовательскими голосами, включая готовые «роботские» персонажи вроде «Robot A» (более 280 авторов используют этот голос). Доступ из России — с VPN.
Важный нюанс: «звучит человечно» и «звучит как нужно для контента» — разные задачи. Для sci-fi-канала нужен голос с характерной механичностью, а не максимальный MOS. Speakmi позволяет задавать эмоции и темп тегами — это даёт контроль над степенью «роботизации» без потери разборчивости.
¹ Fish Audio — товарный знак его правообладателя. Мы не являемся его представителем или партнёром; используем API Fish Audio как поставщика технологии синтеза речи.
Чем голос робота отличается от клонирования голоса и когда что выбрать?
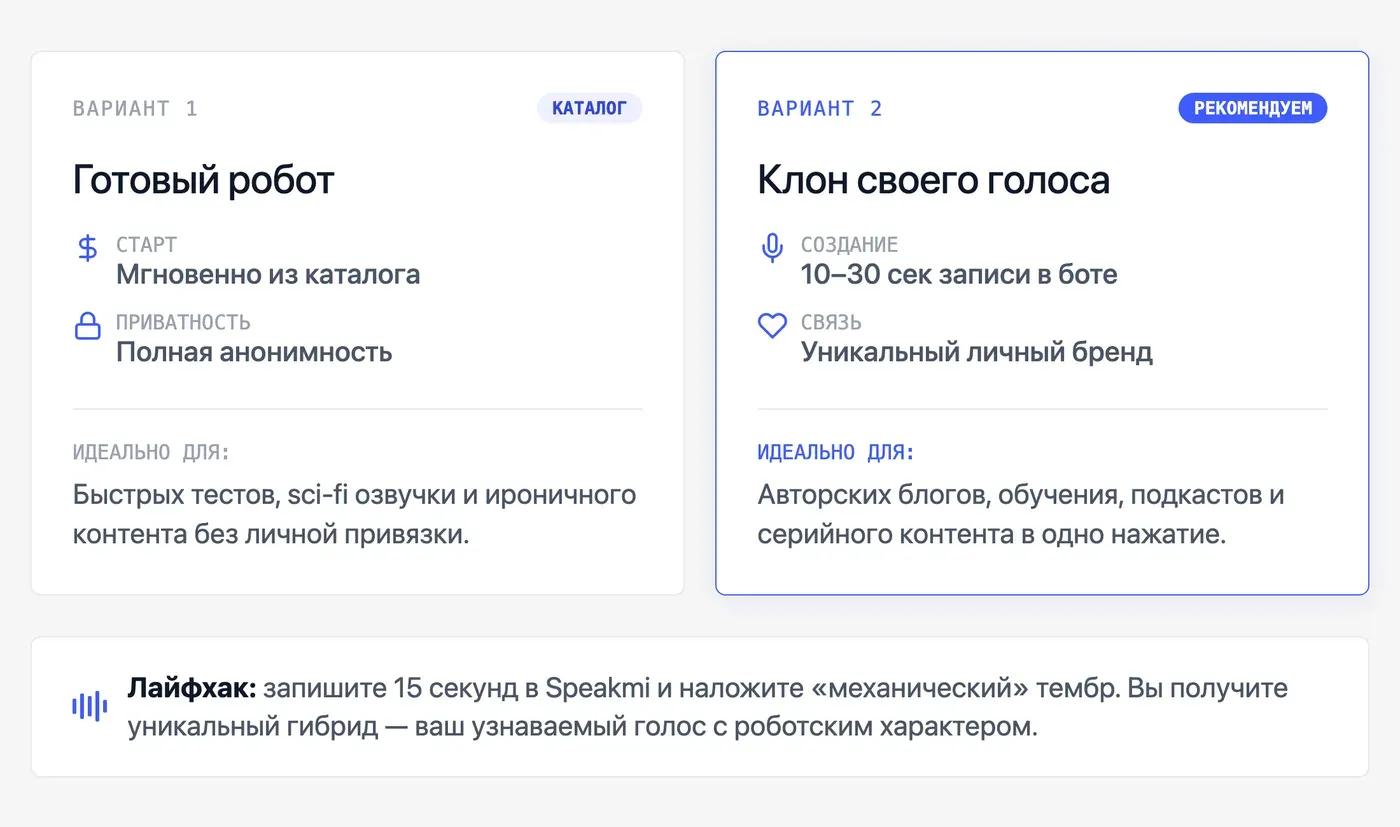
Коротко: готовый роботский голос — быстро и анонимно; клон своего голоса с роботским тембром — узнаваемо и персонально. Готовый вариант подходит для быстрых тестов и потокового производства контента. Клонирование решает задачу долгосрочного брендинга и выстраивания доверительной связи с аудиторией.
| Параметр | Готовый роботский голос | Клон своего голоса |
|---|---|---|
| Время на запуск | Секунды — выбрал из каталога | 10–30 секунд записи + генерация |
| Анонимность | Полная — никакой связи с реальным голосом | Нет — голос узнаваем |
| Брендинг | Одинаковый у всех, кто выбрал тот же голос | Уникальный «голос канала» |
| Серийный контент | Да — просто вставляешь новый текст | Да — сохранил в «Мои голоса», дальше только текст |
| Подходит для | Анонимных каналов, sci-fi, ироничного контента | Авторских каналов, подкастов, обучения |
Свой голос клонируется из записи на 10–30 секунд — в Telegram-боте Speakmi это просто отправленное голосовое сообщение, без загрузки файлов и настройки студии. После этого можно добавить «механический» тембр через эмоции — и получить что-то среднее: узнаваемый голос с роботским характером.
Если задача — анонимность или стиль «голоса из будущего» без личной привязки — достаточно выбрать готовый голос с нужным тембром. Если задача — выстроить узнаваемый авторский бренд и при этом не записывать озвучку каждый раз — клон своего голоса.
Как озвучить текст голосом робота онлайн с помощью пошаговой инструкции через Speakmi?
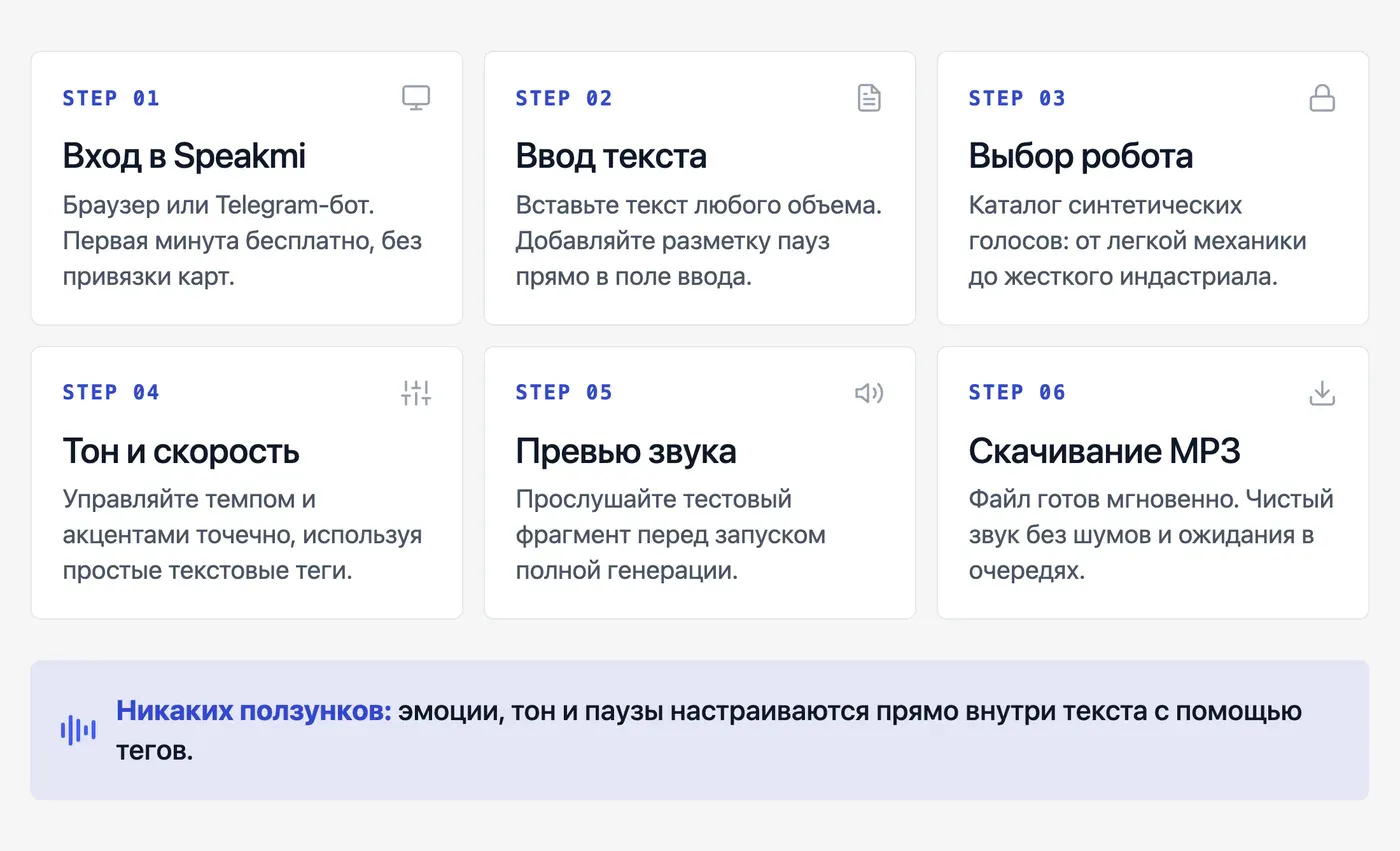
Коротко: от текста до готового MP3-файла вас отделяют всего шесть простых шагов, при этом микрофон не потребуется. Процесс полностью автоматизирован и происходит в облачном интерфейсе или мессенджере. Вы получаете чистую дорожку без шумов за несколько секунд.
-
Открой Speakmi — через speakmi.ru в браузере или через Telegram-бот. Регистрация нужна для сохранения голосов, первые 30 секунд озвучки бесплатны без карты.
-
Вставь текст — любой объём в пределах выбранного пакета токенов. Если нужны паузы или акценты — добавь эмоции тегами прямо в тексте.
-
Выбери голос с роботизированным тембром — в каталоге есть голоса с разной степенью «механичности»: от слегка синтетического до выраженно роботского.
-
Настрой скорость и тон — через теги в тексте, не через отдельные ползунки. Например, замедлить конкретную фразу или поднять интонацию на ключевом слове.
-
Прослушай превью — перед генерацией финального файла можно проверить, как звучит фрагмент.
-
Скачай MP3 — файл готов сразу после генерации, без ожидания очереди.
Эмоции и паузы задаются тегами прямо в тексте — не ползунками, поэтому интонацию можно поправить за одну правку, а не пересводить всё заново.
Для каких форматов контента подходит роботизированный голос и где он не работает?
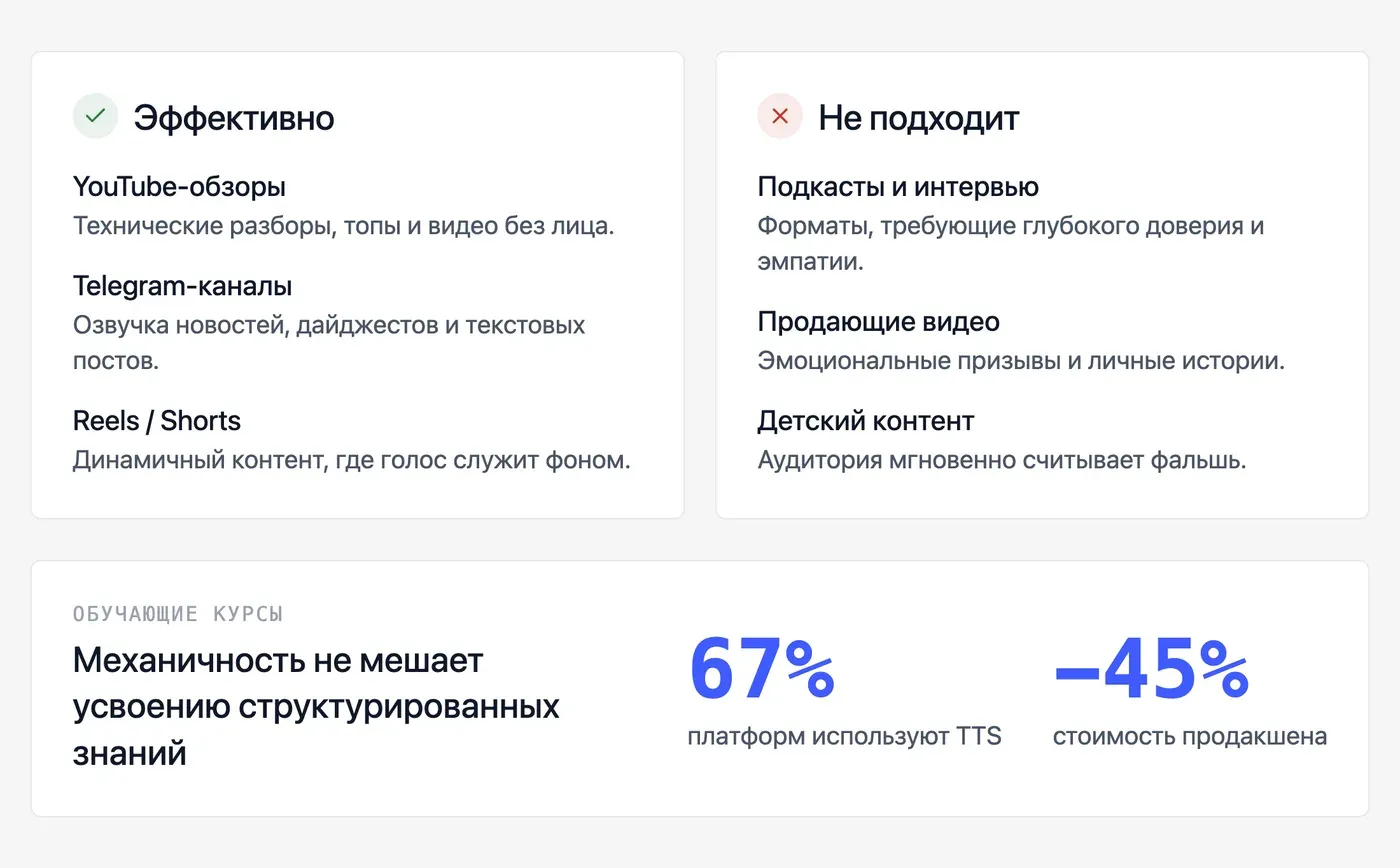
Коротко: роботский голос отлично работает там, где механичность является частью стиля или где озвучка выполняет чисто утилитарную функцию. Он категорически не подходит для форматов, завязанных на глубоком личном доверии и эмпатии. Правильный выбор формата убережёт ваш проект от оттока аудитории.
YouTube-обзоры и разборы (да) — роботский голос стал узнаваемым форматом для технических обзоров, топов и «говорящих голов без лица». Аудитория давно приняла этот стиль как норму.
Reels / Shorts (да, осторожно) — работает для контента с текстом на экране, где голос — фон. Если ролик строится на эмоции и личном контакте — роботский тембр разрушает его.
Подкасты (нет / только как приём) — подкаст держится на доверии к голосу ведущего. Постоянный роботский голос в подкасте — это либо художественный концепт, либо потеря аудитории.
Telegram-каналы с озвучкой (да) — текстовые посты, новости, дайджесты. Роботский голос не мешает восприятию информации и при этом даёт каналу «голос» без необходимости записывать диктора.
Обучающие видео и курсы (да) — если контент структурированный и информационный, механичность голоса не мешает усвоению. По данным исследования Speakmi Research за 2026 год, около 67% обучающих платформ используют TTS-голоса для автоматизации производства курсов. Согласно отчёту EdTech Global 2025, внедрение ИИ-озвучки снижает стоимость продакшена учебных материалов на 45%.
Где режет: интервью-формат, личные истории, продающие видео с эмоциональным призывом, детский контент. В этих форматах живой голос или убедительный ИИ-клон без роботского тембра — единственный рабочий вариант.
Первые 30 секунд озвучки в Speakmi — бесплатно, без карты: можно послушать голос на реальном тексте прежде, чем платить.
Частые вопросы
- Какой голос робота самый реалистичный на русском языке?
- По открытым тестам 2025–2026 года нейросетевые движки — ElevenLabs, ERA2, Speakmi (на базе Fish Audio) — значительно опережают классический TTS по естественности. На русском языке Speakmi и ERA2 Voice показывают наиболее стабильное качество с учётом доступности из РФ без VPN.
- Можно ли сделать голос робота из своего голоса?
- Да. В Speakmi клонирование голоса делается из записи 10–30 секунд — достаточно голосового сообщения в Telegram-боте. После этого можно управлять тембром и темпом через теги эмоций, придав клону нужную степень «механичности».
- Голос Алисы — это робот или нейросеть?
- Нейросеть. Яндекс давно перешёл с классического TTS на нейросетевую генерацию — Алиса звучит естественно по меркам ассистентов. Но это голос для диалогового интерфейса: скачать файл, настроить тембр или озвучить длинный текст через Алису не получится.
- Как озвучить текст голосом робота бесплатно онлайн?
- SteosVoice / CyberVoice заявляет бесплатный доступ к роботизированным голосам без ограничения по времени. Speakmi даёт первые 30 секунд озвучки бесплатно без карты — достаточно, чтобы проверить голос на реальном тексте. ERA2 Voice — 300 символов бесплатно.
- Чем роботизированный голос отличается от обычного TTS?
- Обычный TTS — это синтез по правилам: разборчиво, но монотонно. Роботизированный голос — это либо намеренно утрированный механический тембр, либо нейросетевой голос с настройками, снижающими «человечность». Разница в том, что современный роботский голос управляем: можно задать нужную степень механичности, сохранив разборчивость.
- Можно ли скачать озвучку голосом робота в MP3?
- Да — в Speakmi, ERA2 Voice, SteosVoice / CyberVoice, ElevenLabs файл скачивается сразу после генерации. Голоса ассистентов (Алиса, Siri) и Google TTS в стандартном пользовательском доступе файл не отдают.
- Какой сервис даёт самый «механический» голос для видео?
- SteosVoice / CyberVoice специализируется именно на роботизированной озвучке — там это отдельная категория. Fish Audio (доступ из РФ с VPN) предлагает готовые голоса-персонажи вроде «Robot A». В Speakmi можно получить управляемую механичность через настройку эмоций на нейросетевом голосе — это даёт больше контроля над конечным звуком, чем фиксированный роботский пресет.