Как создать ИИ-аватара бесплатно: что нужно и где берут голос
Как создать ИИ-аватара бесплатно: какие инструменты нужны для внешности, анимации и голоса, где взять голос для говорящего аватара и как собрать всё вместе.
Что такое ИИ-аватар: внешность, анимация и голос — три разных задачи
Статичная аватарка профиля и говорящий ИИ-аватар для видео — разные вещи. Аватарка — это картинка. Говорящий аватар — это сборка из трёх компонентов.
Внешность — изображение персонажа: своё фото, сгенерированный портрет или готовая 3D-модель.
Анимация — сервис lip-sync берёт это изображение и голосовой файл, затем генерирует видео, где губы движутся в такт речи. Без аудиодорожки сервис не знает, как двигать ртом.
Голос — аудиофайл MP3 или WAV с нужным текстом. Его либо записывают вживую, либо генерируют через TTS-сервис.
Нет единой кнопки «создать аватара»: нужно собрать три части по отдельности и потом соединить. Это статья о том, как пройти эту цепочку от начала до конца, в том числе бесплатно.
Шаг 1. Создать внешность аватара: фото, иллюстрация или 3D-модель
Три варианта — под разные задачи:
-
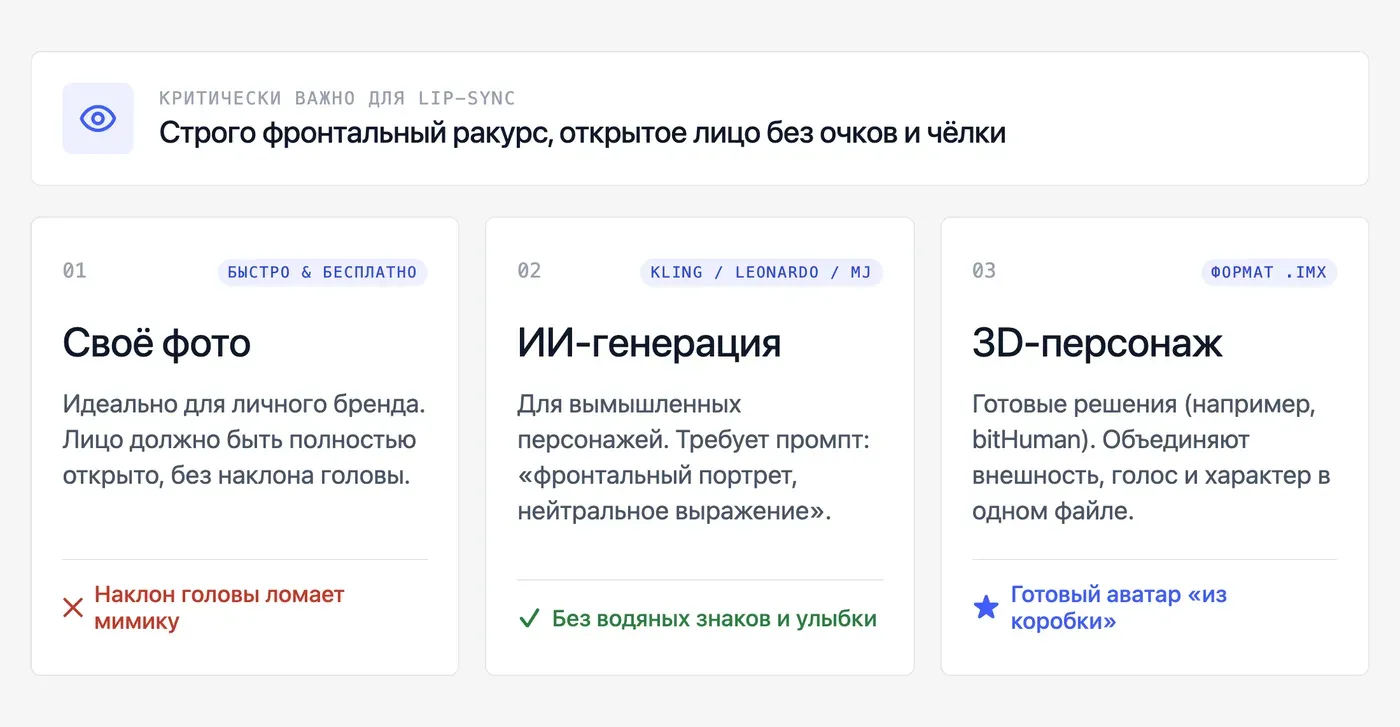
Своё фото. Быстро и бесплатно. Главное требование для lip-sync анимации: фронтальный ракурс, открытое лицо без очков и чёлки, поверх которой. Фото в профиль или с наклоном головы даёт плохой результат — губы «поедут».
-
ИИ-генератор изображений. Подходит, если не хочется светить лицом или нужен вымышленный персонаж. Kling, Leonardo, Midjourney генерируют портрет по текстовому промту. Важно: указывай «фронтальный портрет, нейтральное выражение лица» — иначе нейросеть даст три четверти или лёгкую улыбку, с которой lip-sync работает хуже. Если на скриншоте-референсе есть водяной знак, плеер или надписи — уточни: «убери надписи и знак Play».
-
Готовый 3D-персонаж. Сервисы вроде bitHuman предлагают скачать аватара в готовом виде из раздела Explore или сгенерировать по портрету. Формат
.imxвключает внешность, голос и личность в одном файле.
Для анимации губ нужен именно фронтальный кадр с открытым лицом — это требование любого lip-sync сервиса, не исключение.
Шаг 2. Анимировать аватара: сервисы для синхронизации губ с голосом
Принцип lip-sync прост: загружаешь фото + аудиофайл → сервис генерирует видео с движением губ. Процесс занимает от нескольких секунд до нескольких минут в зависимости от длины аудио.
Порядок действий одинаков в большинстве сервисов:
-
Загрузи фото (JPG/PNG, фронтальный портрет).
-
Загрузи аудиофайл (MP3 или WAV — не OGG, большинство сервисов его не принимают).
-
Запусти генерацию.
-
Скачай видео.
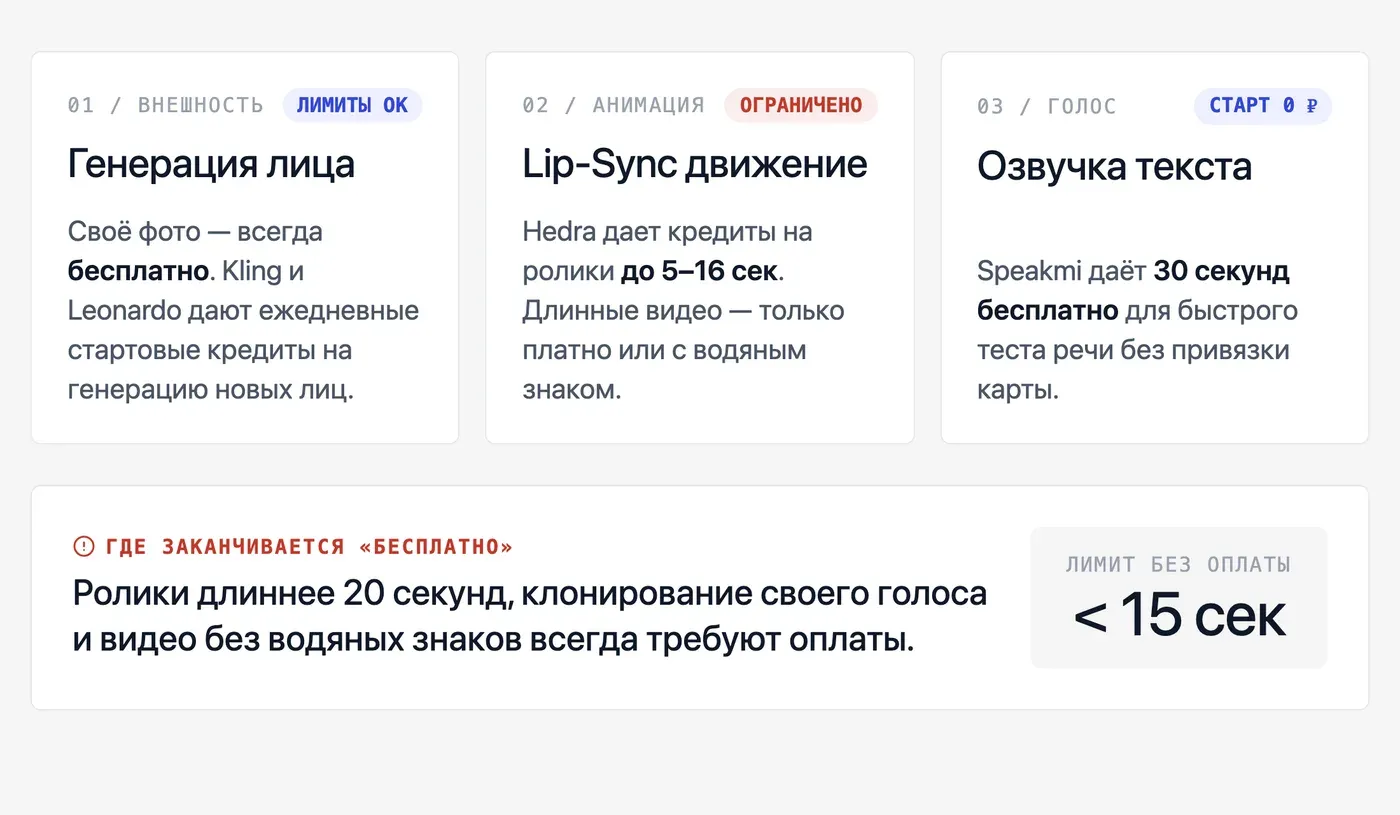
Что важно знать о бесплатных лимитах: большинство сервисов на бесплатном уровне ставят водяной знак или ограничивают длину видео — обычно до 5–16 секунд за одну генерацию. Hedra, например, даёт ежедневные бесплатные кредиты, которых хватает на короткие ролики, но по состоянию на октябрь 2026 платная подписка стоит $20 в месяц (год назад было $10). Ролик на 20 секунд с нуля реально собрать за 25 минут — включая генерацию голоса.
Если нужны видеосцены длиннее 8–16 секунд, их генерируют по частям и склеивают в CapCut или аналогичном редакторе. Подробнее о нейросетях для работы с контентом — в статье нейросети для создания контента в 2026
Если при склейке голос в разных фрагментах звучит по-разному — экспортируй только аудиодорожку, пропусти через Voice Changer с одним конкретным голосом, наложи единый трек обратно. Это убирает разнобой.
Шаг 3. Дать аватару голос: три способа и чем они отличаются
Голосовой файл нужен до анимации — сервис lip-sync его просто принимает на вход. Три варианта:
-
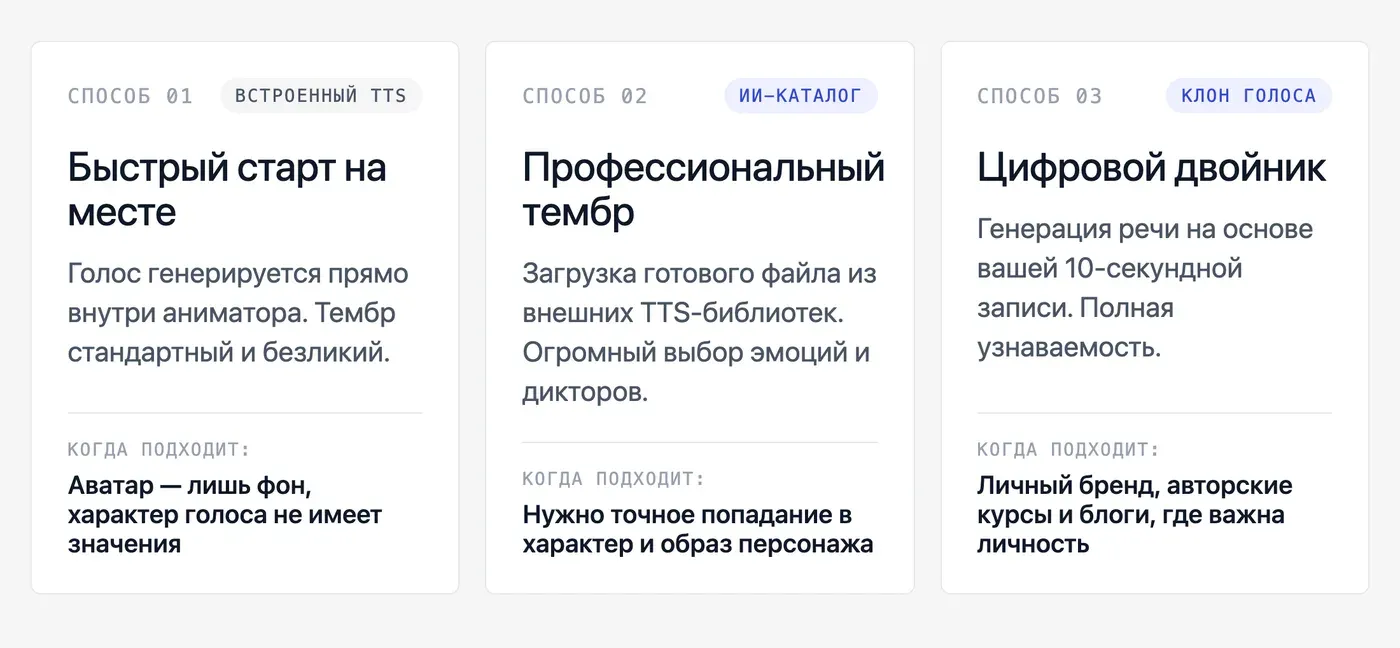
Встроенный TTS сервиса анимации. Есть в некоторых lip-sync инструментах прямо в интерфейсе. Быстро, но голос обезличенный — стандартный синтетический тембр. Подходит, если аватар — вспомогательный элемент и голос не важен.
-
Сторонний ИИ-голос из библиотеки. Берёшь нужный тембр из каталога TTS-сервиса, генерируешь файл и загружаешь в аниматор. Больше выбора: мужской, женский, дикторский, разговорный, эмоциональный. Подходит, когда голос должен совпадать с образом персонажа, но своя запись не нужна.
-
Клон своего голоса. Узнаваемо похоже на тебя. Один раз записываешь образец 10–30 секунд, дальше сервис читает любой текст твоим голосом. Подходит, если аватар — твой цифровой двойник для блога, курса или канала, и зрители должны узнавать голос.
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Как озвучить ИИ-аватара в Speakmi: получить голосовой файл для анимации
Speakmi генерирует голосовой MP3-файл на русском — его загружают в сервис lip-sync анимации.
Шаги:
-
Открой speakmi.ru — регистрация не нужна, первые 30 секунд бесплатно без карты.
-
Выбери голос из каталога (914 вариантов на ноябрь 2026): фильтруй по полу, возрасту, манере. Для аватара-диктора подойдут «Новостной диктор» или «Телевизионный диктор», для живого разговорного — «Живой женский» или «Молодой женский», для тёплой подачи — «Тёплый женский».
-
Введи текст в редактор.
-
Нажми «Сгенерировать», скачай MP3 или WAV.
-
Загрузи файл в сервис анимации губ.
Для эмоциональной подачи — выбери модель Drama 3 (модель Fish Audio, в Спикми с 14 октября 2026): она добавляет паузы, шёпот, акцент на словах через пометки в квадратных скобках прямо в тексте: [едва сдерживая смех] Это же серьёзно. Для ровного дикторского голоса — S2.1 Pro. Подробнее про эмоциональную озвучку текста бесплатно.
Если нужен клон своего голоса — в Telegram-боте @speakmibot просто отправь голосовое сообщение 10–30 секунд, сервис создаст мгновенный клон. Клонировать можно только свой голос или с подтверждением прав — чужой голос без согласия недоступен.
Пакеты токенов от 149 ₽, токены не сгорают. Speakmi озвучивает текст и клонирует голос; приложения для практики английского с похожим названием — другой продукт.
ИИ-аватар бесплатно онлайн: что реально доступно без оплаты
Реальная картина по каждому компоненту (на октябрь 2026):
-
Внешность: ИИ-генераторы изображений (Kling, Leonardo) дают бесплатные кредиты — Kling, по данным пользователей, стартует с приличным запасом. Своё фото — бесплатно всегда.
-
Анимация (lip-sync): большинство сервисов на бесплатном уровне ставят водяной знак или ограничивают длину. Hedra даёт ежедневные бесплатные кредиты — хватает на короткие ролики до 5–16 секунд. Длинное видео без водяного знака — платно.
-
Голос: Speakmi даёт 30 секунд озвучки бесплатно новым пользователям, без карты. Этого достаточно, чтобы сделать короткий тест и услышать, как будет звучать аватар. Про остальные бесплатные лимиты ИИ-озвучки на русском — отдельная статья.
Где заканчивается «бесплатно»: ролики дольше 15–20 секунд, серийный выпуск без водяного знака, клонирование голоса для постоянного использования — всё это потребует пакета. Записать 10 минут контента полностью бесплатно не получится ни в одном из сервисов.
Частые ошибки при создании ИИ-аватара: почему губы не совпадают с голосом
-
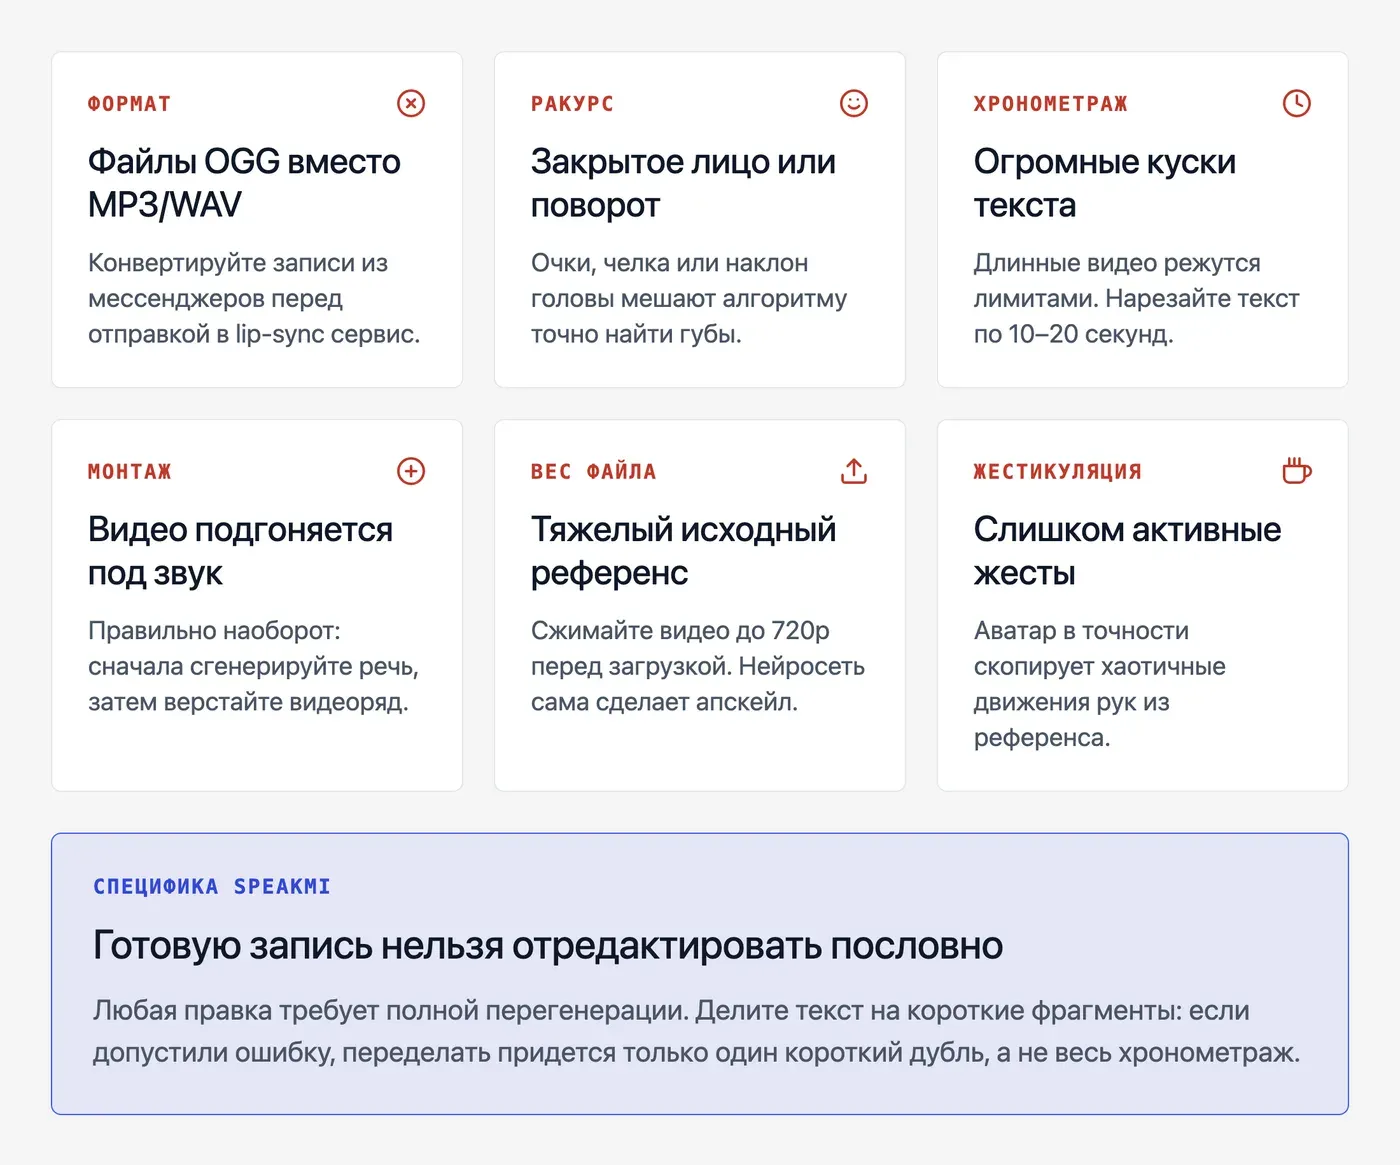
Неправильный формат аудио. Большинство lip-sync сервисов принимают MP3 или WAV. Файл в формате OGG (например, из мессенджера) — не принимается. Конвертируй перед загрузкой.
-
Фото не фронтальное или лицо перекрыто. Поворот головы, очки, чёлка на лбу — всё это ухудшает качество синхронизации губ. Нейросеть не может точно разместить движения рта там, где его видно частично.
-
Слишком длинный текст за один раз. Длинный файл — длинное видео, и на бесплатном лимите оно либо обрежется, либо получит водяной знак. Делай короткие фрагменты по 10–20 секунд, потом склеивай.
-
Несовпадение темпа речи и длины сцены. Если аватар должен говорить на фоне конкретного видеоряда — сначала генерируй голос, меряй длину дорожки, потом подгоняй видео, а не наоборот.
-
Исходное видео-референс слишком тяжёлое. Если сервис анимации не принимает файл — сожми до 720p. Нейросеть сама сделает апскейл на выходе.
-
Нестандартное поведение аватара. Если при записи референса активно махать руками или сидеть неподвижно по стойке «смирно» — аватар будет вести себя так же во всех последующих видео. HeyGen буквально копирует жесты из исходного видео.
-
В Speakmi нельзя поправить одно слово в готовой записи — только новая генерация целиком. Поэтому лучше делать короткие фрагменты: если дубль неудачный, переозвучиваешь только его, а не весь текст.
Частые вопросы
- Чем отличается говорящий ИИ-аватар от статичной аватарки?
- Статичная аватарка — картинка для профиля, она не двигается и не говорит. Говорящий ИИ-аватар — это видео: изображение персонажа анимируется под голосовую дорожку, губы движутся в такт речи. Для его создания нужны три отдельных компонента: внешность, сервис lip-sync анимации и голосовой файл. Статичную аватарку делают за одну операцию в генераторе изображений; говорящего аватара — за три.
- Можно ли сделать аватара под уже готовую аудиозапись?
- Да — это и есть базовый сценарий lip-sync. Загружаешь фото персонажа и готовый аудиофайл MP3 или WAV в сервис анимации, получаешь видео. Единственное условие: формат файла должен быть MP3 или WAV, не OGG. Если запись уже есть в OGG (например, из Telegram), конвертируй перед загрузкой — иначе большинство сервисов файл не примет.
- Как озвучить длинный текст для аватара на несколько тысяч слов?
- Делить на фрагменты по 10–20 секунд. Генерировать каждый отдельно — в Спикми или другом TTS-сервисе, потом аналогично делить анимацию и склеивать в видеоредакторе. Если в склеенных фрагментах голос звучит по-разному — экспортируй аудиодорожку целиком, пропусти через Voice Changer с одним конкретным голосом и наложи единый трек обратно на видео. Сгенерировать сразу 5000 слов в один файл и получить качественный результат не получится ни в одном lip-sync сервисе.
- Можно ли создать ИИ-аватара полностью бесплатно и без водяного знака?
- Один короткий тест — да. Ролик до 15–20 секунд без водяного знака реально собрать на бесплатных лимитах: Kling или Leonardo для изображения, ежедневные кредиты Hedra для анимации, 30 секунд озвучки в Speakmi без карты. Серийный выпуск контента без водяного знака — платно во всех сервисах без исключения.
- Какой формат аудиофайла нужен для загрузки в сервис анимации аватара?
- MP3 или WAV. Формат OGG большинство lip-sync сервисов не принимает — файл просто не загрузится. Speakmi отдаёт MP3 по умолчанию, этот формат подходит везде. Если запись сделана на телефон или скачана из мессенджера в OGG — конвертируй через любой онлайн-конвертер перед загрузкой.
- Можно ли клонировать чужой голос для аватара?
- Нет — ни в Speakmi, ни этично в любом другом сервисе без письменного согласия владельца голоса. Спикми позволяет клонировать только свой голос или голос, на который у тебя есть подтверждённые права. Клонирование голоса знаменитости или другого человека без согласия — нарушение пользовательского соглашения и, в зависимости от юрисдикции, законодательства.
- Что такое Speakmi?
- Speakmi — сервис ИИ-озвучки текста и клонирования голоса на русском, работает как веб-студия на speakmi.ru и как Telegram-бот @speakmibot. Движок — модель Fish Audio. Первые 30 секунд бесплатно без карты, пакеты токенов от 149 ₽, токены не сгорают, оплата картой РФ. Распознавания речи и публичного API нет.