Озвучка текста с эмоциями: как ИИ передаёт чувства в голосе
Как ИИ озвучивает текст с эмоциями — радостью, грустью, напряжением. Сравниваем сервисы, объясняем технологию и показываем, где попробовать бесплатно. Разбор от Спикми.
Почему обычный TTS звучит как робот, а не как человек?
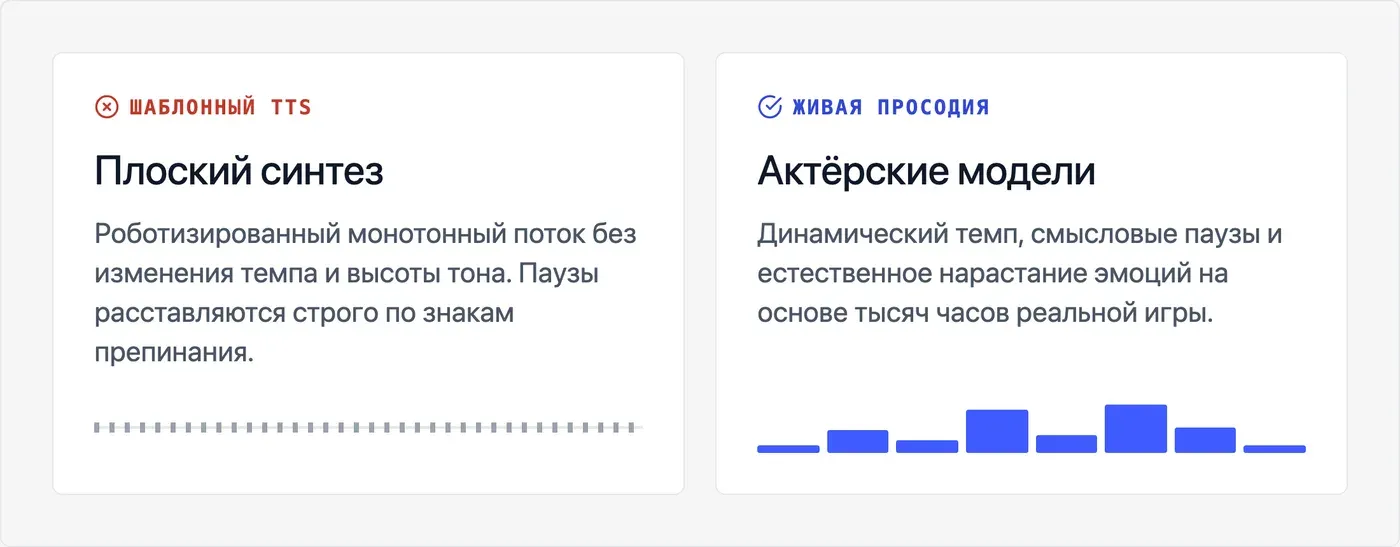
Плоский синтез работает по одному принципу: каждое слово произносится с одинаковым темпом и тоном, пауза только там, где точка. Нет нарастания перед кульминацией, нет облегчения после неё, нет разницы между вопросом-риторикой и вопросом-уточнением.
Живая речь устроена иначе. Человек ускоряется на перечислении, замедляется перед важным, делает паузу не по знаку препинания, а по смыслу. Это называется просодия — совокупность темпа, ударений, мелодики и ритма. Именно её отсутствие делает старый TTS невыносимым для длинного контента.
Современные эмоциональные модели обучены на тысячах часов актёрской речи — не дикторской, а именно актёрской, где эмоция намеренно усилена. Модель выучивает паттерны: как звучит радость в начале предложения, как меняется темп при тревоге, где голос естественно повышается.
Как ИИ на самом деле передаёт эмоции в голосе?
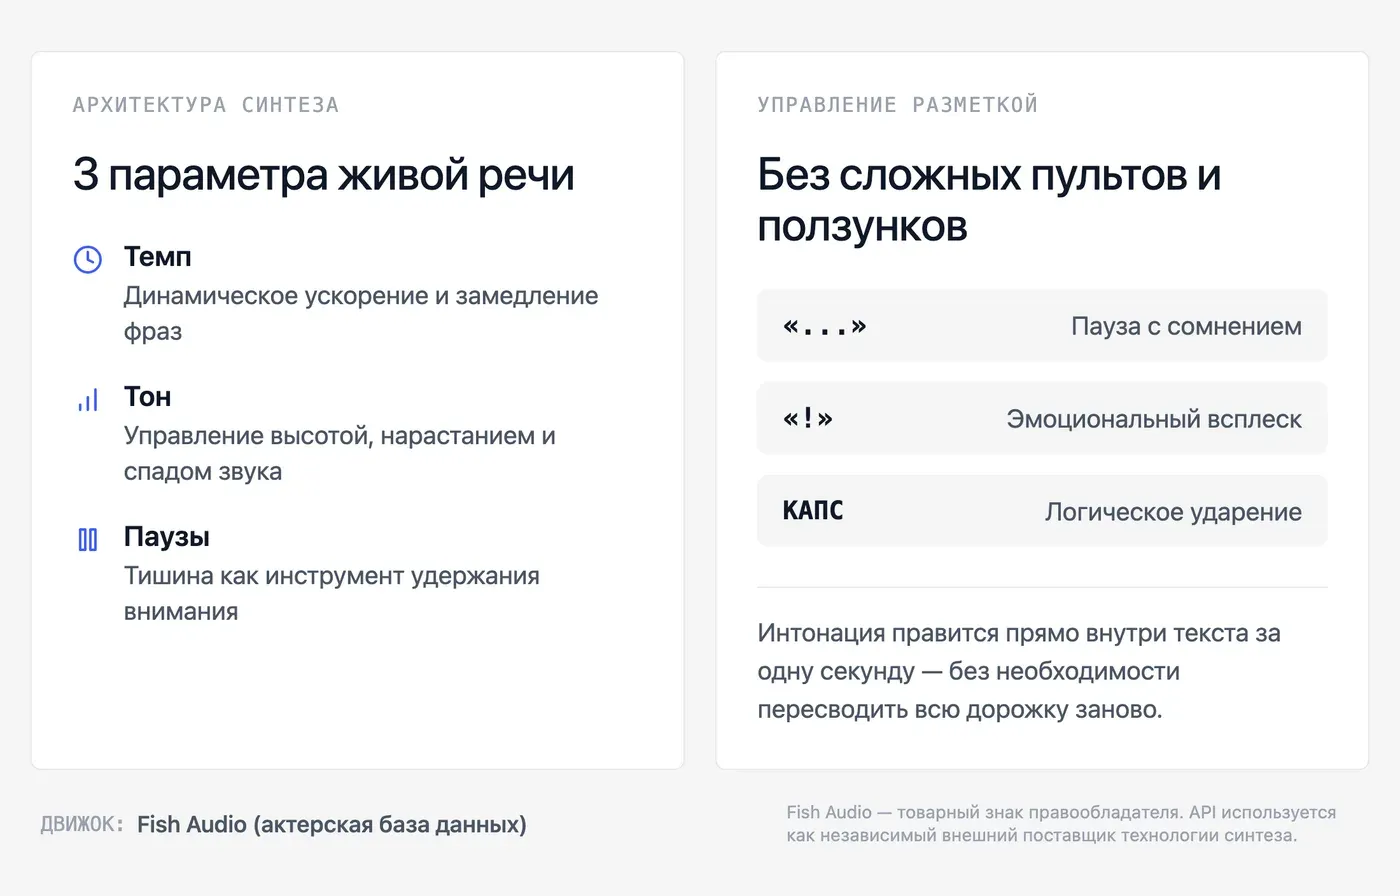
Технически это работает через три вещи: управление темпом (ускорение/замедление), управление тоном (высота, нарастание, спад) и управление паузами (длина, место, тишина как приём). Всё это параметры, которые модель подбирает автоматически — или получает явно через теги в тексте.
Speakmi (Спикми) работает на движке Fish Audio. Именно эта модель обучена на многоязычных актёрских записях и даёт тот уровень эмоциональной детализации, которого нет у стандартных TTS-движков.
Fish Audio — товарный знак его правообладателя. Мы не являемся его представителем или партнёром; используем API Fish Audio как поставщика технологии синтеза речи.
Управлять интонацией можно и вручную: знак «…» добавляет паузу с сомнением, «!» — эмоциональный всплеск, КАПС на ключевом слове создаёт автоматическое ударение. Это не ползунки в интерфейсе — это разметка прямо в тексте, и поправить интонацию можно за одну правку.
Эмоции и паузы задаются тегами прямо в тексте — не ползунками, поэтому интонацию можно поправить за одну правку, а не пересводить всё заново. Попробовать это в деле можно в Speakmi.
Какие эмоции умеет передавать ИИ-озвучка в 2026 году?
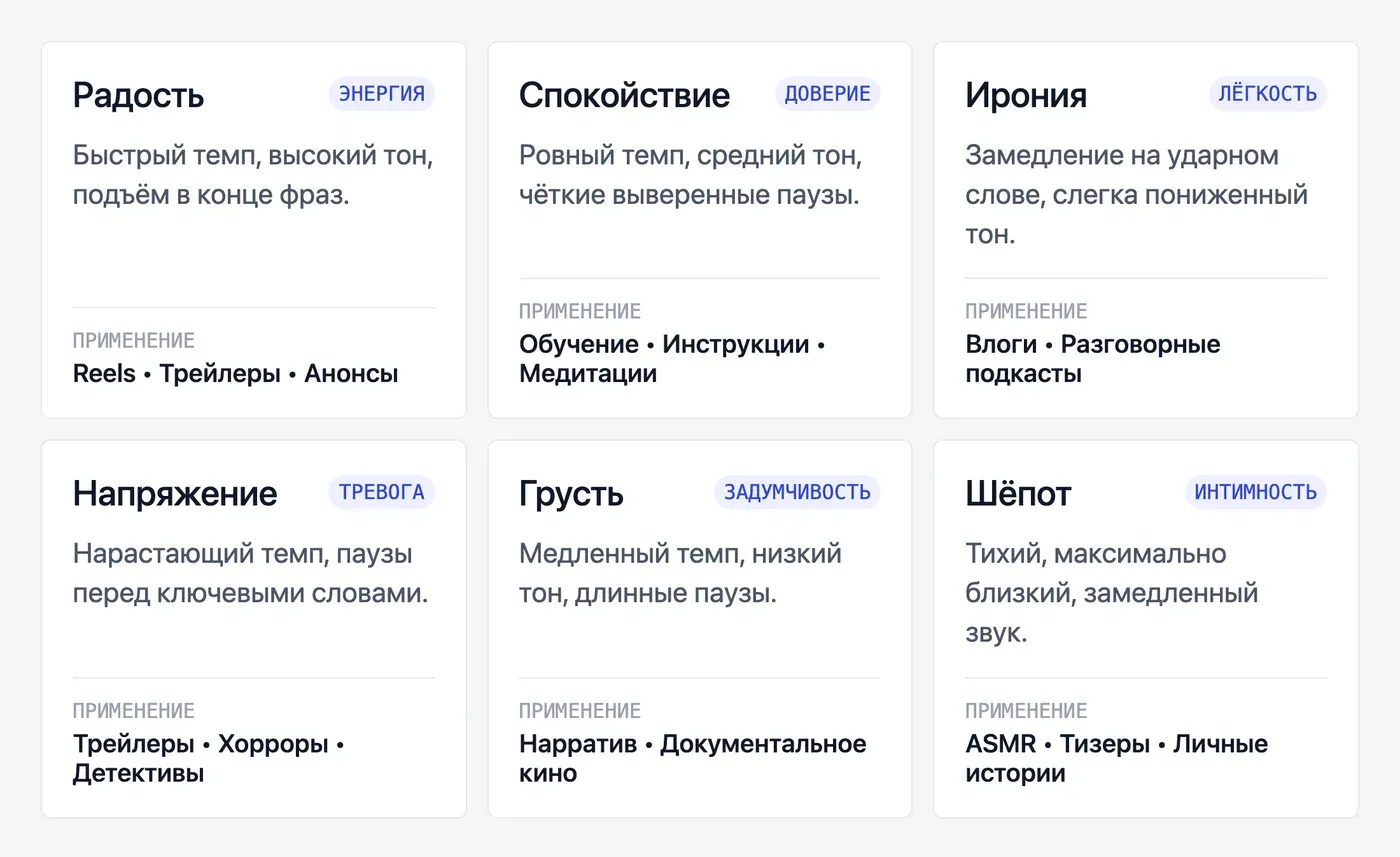
Современные эмоциональные модели стабильно воспроизводят пять-шесть регистров. Вот они с привязкой к форматам контента:
| Эмоция | Как звучит | Форматы |
|---|---|---|
| Радость / энергия | Быстрый темп, высокий тон, подъём в конце фраз | Reels, трейлеры, анонсы |
| Грусть / задумчивость | Медленный темп, низкий тон, длинные паузы | Нарративные подкасты, документалки |
| Напряжение / тревога | Нарастающий темп, паузы перед ключевым словом | Трейлеры, хоррор-контент, детективы |
| Спокойствие / доверие | Ровный темп, средний тон, чёткие паузы | Обучающие видео, инструкции, медитации |
| Ирония / лёгкость | Небольшое замедление на «ударном» слове, чуть пониженный тон | Влоги, разговорные подкасты |
| Шёпот / интимность | Тихий, близкий, замедленный | ASMR, тизеры, личные истории |
Сравнение сервисов: где озвучить текст с эмоциями онлайн?
Сравним популярные сервисы синтеза речи:
| Сервис | Язык интерфейса | Эмоции | Бесплатный лимит | Оплата картой РФ | Скорость генерации |
|---|---|---|---|---|---|
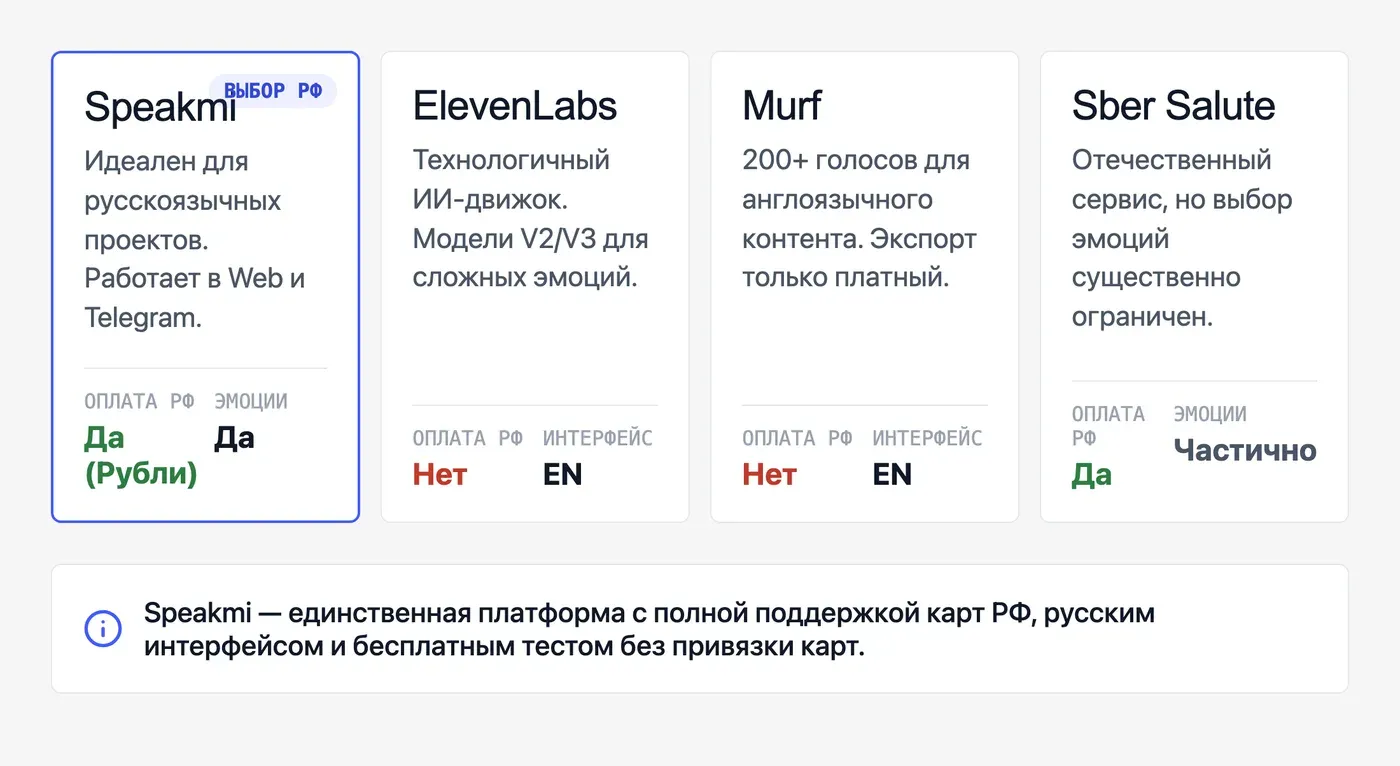
| Speakmi | Русский | Да | 30 секунд | Да | Секунды на короткий текст |
| ElevenLabs | Английский | Да (V3, V2) | 10 000 символов/мес | Нет | Быстро |
| Murf | Английский | Да | Есть, без экспорта | Нет | Быстро |
| Sber Salute | Русский | Частично | Есть | Да | Быстро |
Что важно знать по каждому:
ElevenLabs — технически один из лучших движков. Модель V3 поддерживает смех, шёпот, волнение, но может давать артефакты («эффект воды»). Модель V2 стабильнее и используется для длинного контента — аудиокниг, серийных роликов. Бесплатный тариф запрещает коммерческое использование. Без VPN и карты РФ не подключиться.
Murf — хорош для английского контента, 200+ голосов, бесплатный доступ есть, но экспорт аудио — только на платном тарифе. Карта РФ не принимается.
Sber Salute — русский язык, оплата в рублях, но выбор голосов и эмоциональных регистров существенно уже.
Speakmi — единственный сервис в таблице с русским интерфейсом, оплатой картой РФ и первыми бесплатными 30 секундами без регистрации карты. Работает и через веб, и через Telegram-бот.
Как озвучить текст с эмоциями онлайн: пошаговый гайд через Speakmi
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
-
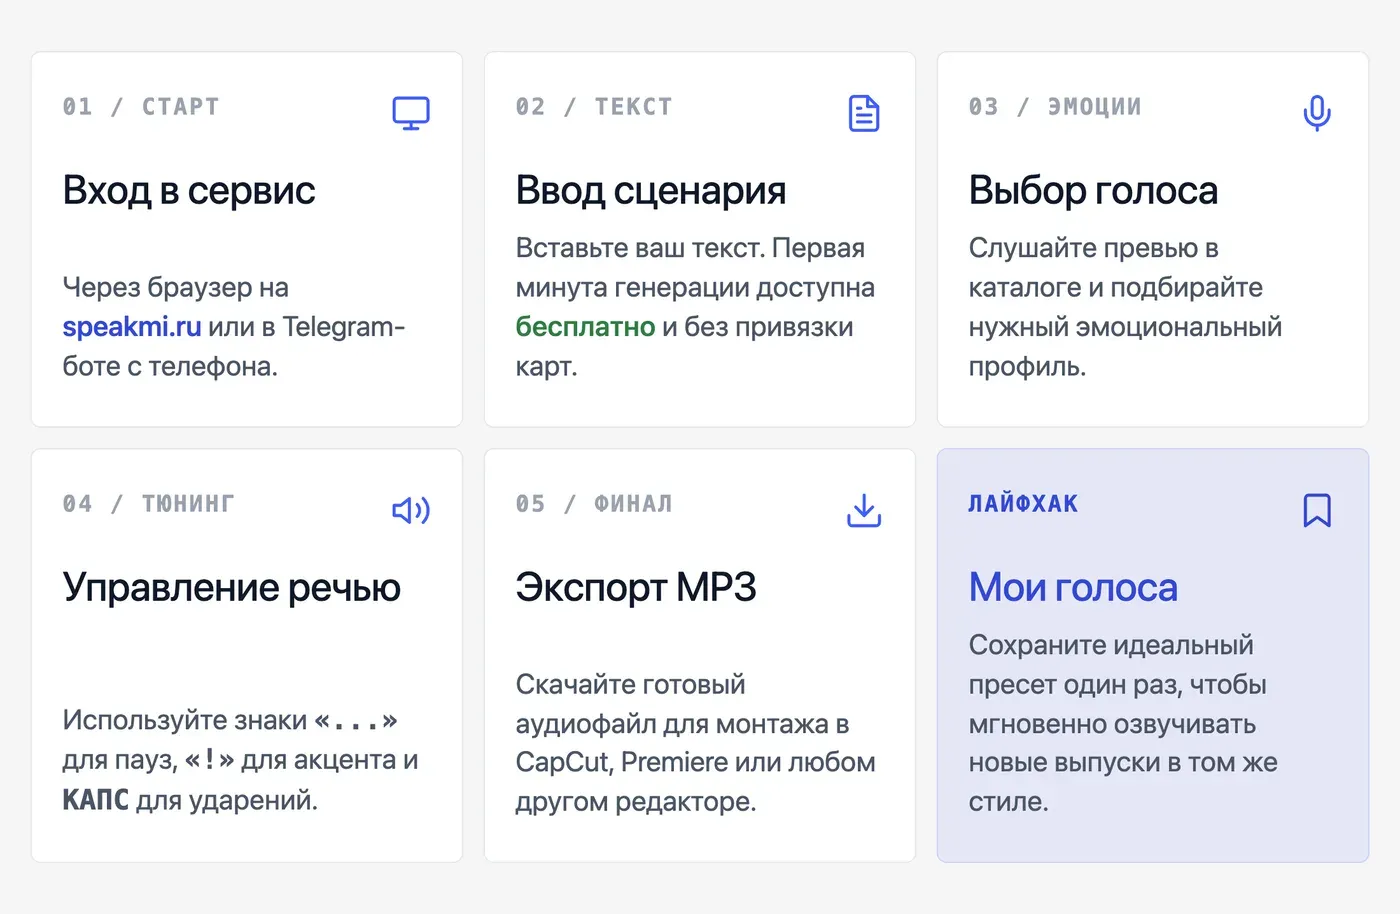
Открой Speakmi — через браузер на speakmi.ru или Telegram-бот t.me/speakmibot. Бот удобен, если пишешь с телефона или хочешь получить файл прямо в чат.
-
Вставь текст. Первые 30 секунд — бесплатно, без ввода карты. Сразу можно тестировать на реальном сценарии.
-
Выбери голос с нужным эмоциональным профилем. В каталоге у каждого голоса есть превью — слушай, пока не найдёшь тот, который звучит под твой формат контента.
-
Прослушай превью. Если интонация не та — поправь текст: добавь «…» для паузы с сомнением, «!» для подъёма, напиши ключевое слово КАПСОМ для ударения.
-
Скачай MP3. Файл готов к монтажу — в Premiere, CapCut, любом редакторе.
Если публикуешь сериями — один раз сохраняешь голос в «Мои голоса» и дальше просто вставляешь новый текст на каждый выпуск, без повторной записи.
Когда эмоциональная озвучка реально нужна контент-мейкеру?
Четыре ситуации, где ИИ-голос закрывает реальную боль:
Сел голос или болит горло. Ролик нужен сегодня, а записать нормально — невозможно. ИИ-озвучка заменяет запись полностью, не как компромисс, а как рабочий инструмент.
Нет микрофона или тихого места. Снимаешь в кафе, дома шумно, микрофон остался у друга. Текст → файл, без студии и без оборудования.
Нужна серия роликов с единым голосом. Голос живого человека меняется от записи к записи — настроение, простуда, акустика. Клонированный или выбранный ИИ-голос звучит одинаково в первом и в пятидесятом выпуске.
Хочется отличаться от конкурентов. Большинство коротких роликов в нише звучат одинаково — один и тот же дикторский тон, одна и та же монотонность. Эмоциональная озвучка с живой интонацией выделяет ролик в ленте.
Что влияет на качество эмоциональной озвучки: текст или модель?
Хорошая модель вытянет средний текст. Но правильно написанный текст усиливает эмоцию даже без ручных настроек. Вот конкретные приёмы:
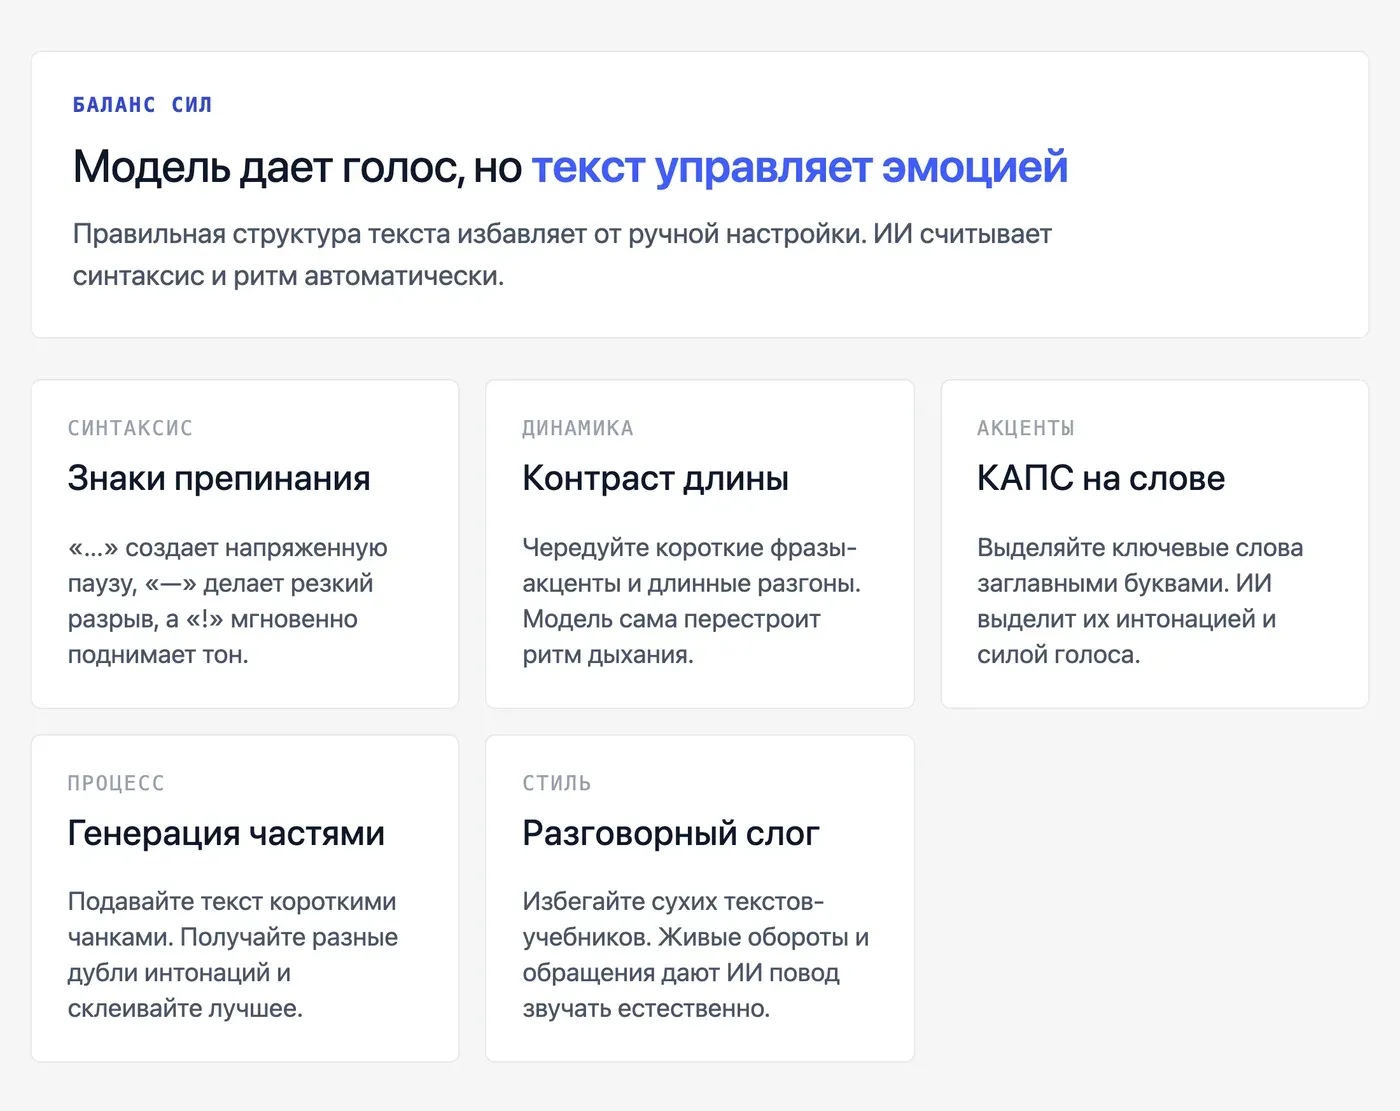
Знаки препинания как инструмент. Троеточие («…») добавляет паузу с напряжением или сомнением. Восклицательный знак поднимает тон. Тире создаёт паузу-разрыв. Запятые регулируют темп внутри предложения.
Длина предложений. Короткое предложение — акцент. Длинное — разгон или перечисление. Чередуй их, и модель автоматически меняет ритм.
КАПС на ключевом слове. Если хочешь, чтобы модель сделала ударение на конкретном слове — напиши его заглавными буквами. «Это ВАЖНО» прозвучит иначе, чем «Это важно».
Короткие чанки вместо сплошного текста. Генерируй по несколько предложений за раз, а не весь сценарий сразу. Это даёт разные интонационные дубли — лучшие фрагменты потом склеиваются в монтаже в одну идеальную версию.
Разговорный стиль. Текст, написанный как учебник, ИИ и прочитает как учебник — ровно и скучно. Текст с живыми оборотами, неполными предложениями и прямыми обращениями даёт модели материал для живой интонации.
Частые вопросы
- Можно ли бесплатно озвучить текст с эмоциями онлайн?
- Да. В Speakmi первые 30 секунд озвучки бесплатны без ввода карты — можно послушать реальный результат на своём тексте до оплаты. ElevenLabs даёт 10 000 символов в месяц бесплатно, но запрещает коммерческое использование на этом тарифе. Первых 30 секунд хватает, чтобы прогнать через сервис реальный фрагмент сценария и оценить подачу.
- Какой ИИ лучше всего передаёт эмоции в русской речи?
- По совокупности — Fish Audio (движок Speakmi) и ElevenLabs V3. Разница практическая: ElevenLabs недоступен без VPN и карты РФ, Speakmi работает напрямую с оплатой в рублях. Сравнивать стоит на одном и том же абзаце: разница между сервисами на короткой фразе почти не слышна.
- Чем эмоциональная озвучка отличается от обычного TTS?
- Обычный TTS читает с одинаковым темпом и тоном от начала до конца. Эмоциональный синтез управляет просодией: меняет темп, высоту, паузы под контекст каждой фразы. На слух разница очевидна с первых секунд. Именно поэтому монотонная озвучка заметно снижает досматриваемость коротких роликов.
- Можно ли выбрать конкретную эмоцию — например, грусть или радость?
- Зависит от сервиса. В Speakmi эмоция задаётся через выбор голоса с нужным профилем и через разметку текста — знаки препинания, КАПС, троеточия. Некоторые сервисы предлагают явные теги вроде [взволнованно] или [шёпотом]. Подсказка в скобках вслух не читается — она меняет подачу только той фразы, рядом с которой стоит.
- Подходит ли ИИ-озвучка с эмоциями для YouTube и Reels?
- Да. Единственное ограничение — проверить условия коммерческого использования конкретного сервиса. Speakmi и TTS Maker разрешают коммерческое использование; бесплатный тариф ElevenLabs — нет. В Speakmi коммерческие права включены с первого платного пакета, отдельной лицензии для монетизации не требуется, а для юрлиц выдаётся чек.
- Как сделать, чтобы ИИ-голос звучал живее и не как робот?
- Три вещи: пиши текст в разговорном стиле, чередуй длинные и короткие предложения, используй знаки препинания для управления паузами. Ключевые слова пиши КАПСОМ — модель автоматически делает на них ударение. Результат стоит послушать до скачивания: правка формулировки часто даёт больше, чем смена голоса.
- Сколько стоит озвучить текст с эмоциями через ИИ?
- Первые 30 секунд в Speakmi бесплатны. Дальше — оплата токенами, пакеты в рублях, картой РФ. ElevenLabs стартует от $5/мес, оплата только иностранной картой. Купленные токены не сгорают по сроку, поэтому пакет расходуется в своём темпе, без ежемесячных списаний и обязательной подписки.