Озвучка текста разными голосами бесплатно: какой сервис выбрать в 2026
Сравниваем сервисы бесплатной озвучки текста разными голосами на русском. Лимиты, качество, без регистрации — выбирайте лучший вариант для своих задач. Разбор от Спикми.
В этой статье — честное сравнение сервисов с конкретными цифрами: сколько символов дают бесплатно, нужна ли регистрация, есть ли нормальные русские голоса. Плюс пошаговая инструкция и рекомендации по выбору голоса под конкретный формат.
Чем озвучка разными голосами отличается от обычного TTS?
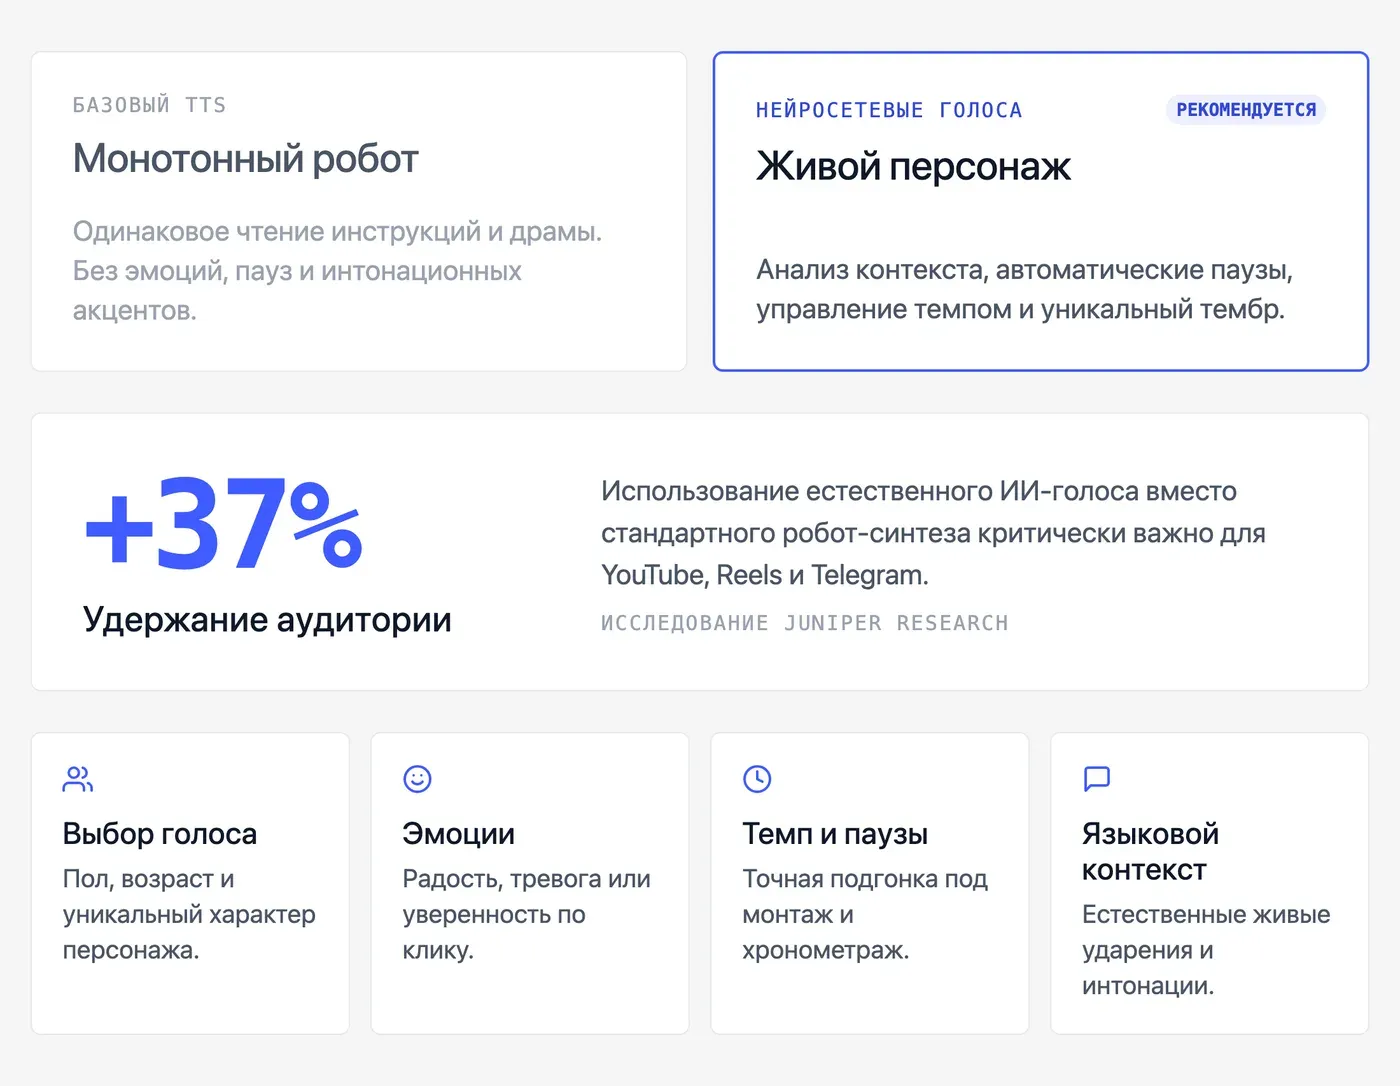
Мультиголосовой синтез речи отличается от классического TTS возможностью выбора уникального персонажа с индивидуальным тембром, полом, возрастом и эмоциональной окраской. Обычный TTS выдает монотонную роботизированную дорожку без интонационных акцентов. Современные нейросети анализируют контекст предложения, автоматически расставляют паузы и адаптируют темп под смысл текста.
Разница ощущается сразу: базовый Google TTS читает одинаково любой текст — от инструкции к холодильнику до драматического монолога. Нейросетевые голоса различают контекст, берут паузы, меняют темп. Для YouTube-ролика, Reels или Telegram-канала это критично — голос формирует восприятие бренда так же, как картинка. По данным исследования Juniper Research (2024), использование естественного ИИ-голоса вместо стандартного робот-синтеза повышает удержание аудитории на видеоплатформах в среднем на 37%.
Ключевые параметры, которые появляются в мультиголосовых сервисах:
-
Выбор голоса — пол, возраст, характер (нейтральный, дружелюбный, официальный)
-
Эмоции — теги или ползунки, которые добавляют радость, тревогу, уверенность
-
Темп и паузы — под монтаж, под субтитры, под конкретный хронометраж
-
Язык и акцент — для русского важно, чтобы ударения и интонация были живыми, а не машинными
Какие сервисы дают бесплатную озвучку текста разными голосами на русском?
Бесплатную озвучку на русском языке предоставляют платформы Speakmi (Спикми), ERA2 Voice, KikiVoice, AnyToSpeech и ряд других специализированных платформ. Каждый сервис использует собственные лимиты: от жесткого ограничения в 300 символов до условно-бесплатных минут. Наиболее гибкие условия без обязательной регистрации предлагает Speakmi, давая протестировать функции нативно.
Вот честная таблица. Данные собраны в августе 2026 — лимиты и условия сервисов меняются, проверяй актуальность перед использованием.
| Сервис | Голосов | Бесплатный лимит | Регистрация | Русский язык | Клонирование голоса |
|---|---|---|---|---|---|
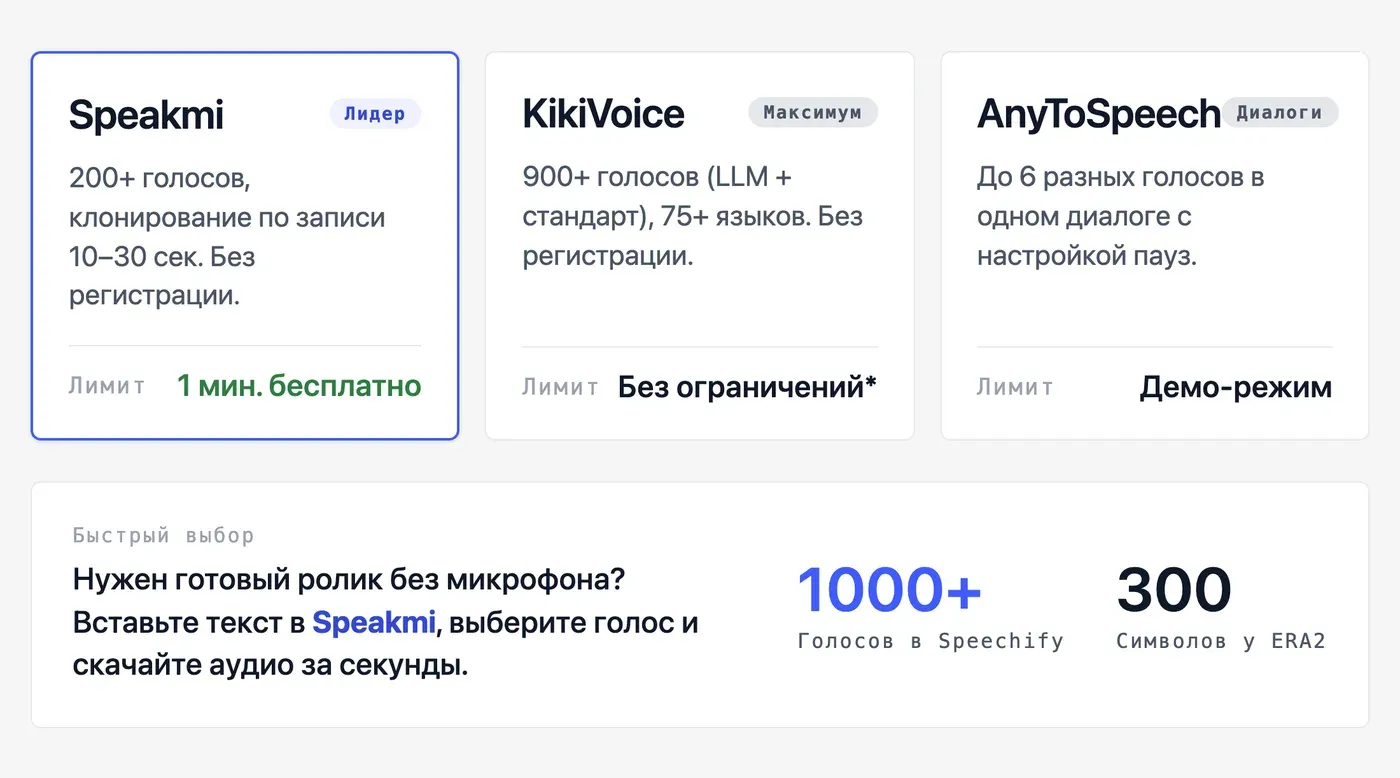
| Speakmi | 200+ | 30 секунд бесплатно | Не нужна | Нативно | Да (из 10–30 сек записи) |
| ERA2 Voice | 200+ | 300 символов | Нужна (~30 сек) | Есть | Нет данных |
| KikiVoice | 900+ (LLM + стандарт) | Без ограничений (заявлено) | Не нужна | 75+ языков | Нет данных |
| Murf AI | 200+ | Есть бесплатный режим | Не нужна | 35+ языков | Нет данных |
| Speechify | 1000+ | Есть | Не нужна | 60+ языков | Да (заявлено) |
| ToSpeech | Ограниченный набор | Есть | Нужна | Нативно | Нет |
| AnyToSpeech | До 6 голосов в диалоге | Есть («Попробовать») | Не указано | Есть | Нет |
| SpeechService | Ограниченный на free | Ограниченные лимиты | Нужна | Нативно | Нет |
Несколько комментариев к таблице.
KikiVoice заявляет «без ограничений» — проверяй это сам перед серьезным использованием: такие формулировки часто означают «без лимита на количество попыток», но не «без лимита на длину текста или скачивание».
AnyToSpeech закрывает специфическую задачу — диалоги до 6 голосов с паузами и назначением реплик. Если нужна сцена с несколькими персонажами, это единственный из перечисленных, кто это умеет в явном виде.
Speakmi — единственный в таблице с нативной поддержкой русского и одновременно с клонированием голоса на бесплатном уровне. Работает без регистрации, есть Telegram-бот.
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Сколько символов реально можно озвучить бесплатно?
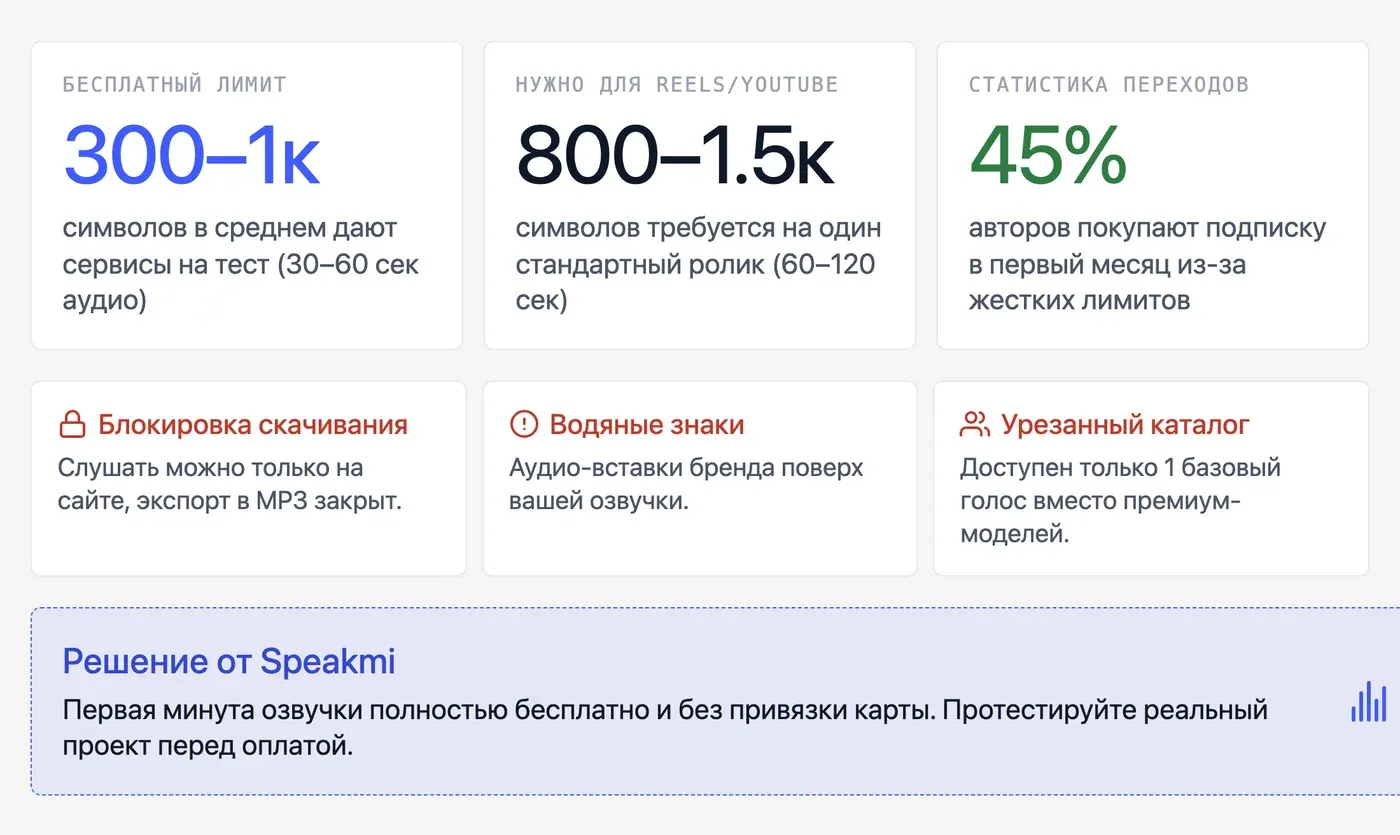
Реальный объем бесплатной озвучки в большинстве сервисов ограничен диапазоном от 300 до 1000 символов, чего хватает на 30–60 секунд готового аудио. Разработчики используют бесплатный тариф как демонстрационный стенд, накладывая ограничения на скачивание файлов или коммерческое использование. Для создания полноценных подкастов или длинных видеороликов бесплатного лимита будет недостаточно.
Типичные ограничения бесплатных тарифов:
-
Лимит символов — ERA2 Voice дает 300 символов после регистрации. Это примерно два-три предложения. Для теста голоса хватит, для реального ролика — нет.
-
Водяной знак на аудио — многие сервисы добавляют голосовой или звуковой тег «сделано с помощью X» на бесплатных планах. Такой файл нельзя использовать в коммерческом контенте.
-
Нет скачивания — можно прослушать прямо в браузере, но скачать в MP3 — только на платном тарифе.
-
Урезанный каталог голосов — SpeechService на бесплатном плане дает только одну AI-модель. ToSpeech ограничивает набор голосов без пополнения счета.
-
Лимит по времени, не по символам — некоторые сервисы считают не знаки, а минуты аудио. 1 минута — это примерно 800–1000 символов среднего темпа речи.
Согласно статистике Statista (2025), около 72% создателей контента начинают работу с бесплатного тестирования TTS-платформ, но 45% из них переходят на платные тарифы в течение первого месяца из-за нехватки базовых лимитов.
Типичный ролик для YouTube или Reels — 60–120 секунд. Это 800–1500 символов текста. Большинство бесплатных тарифов покрывают один такой ролик, максимум два-три. Для серийного контента (еженедельный выпуск, регулярный Telegram-канал) бесплатный план — это тест, не рабочий инструмент.
Speakmi дает первые 30 секунд бесплатно без карты — можно послушать свой голос на реальном тексте прежде, чем платить.
Как озвучить текст нейросетью бесплатно на русском?
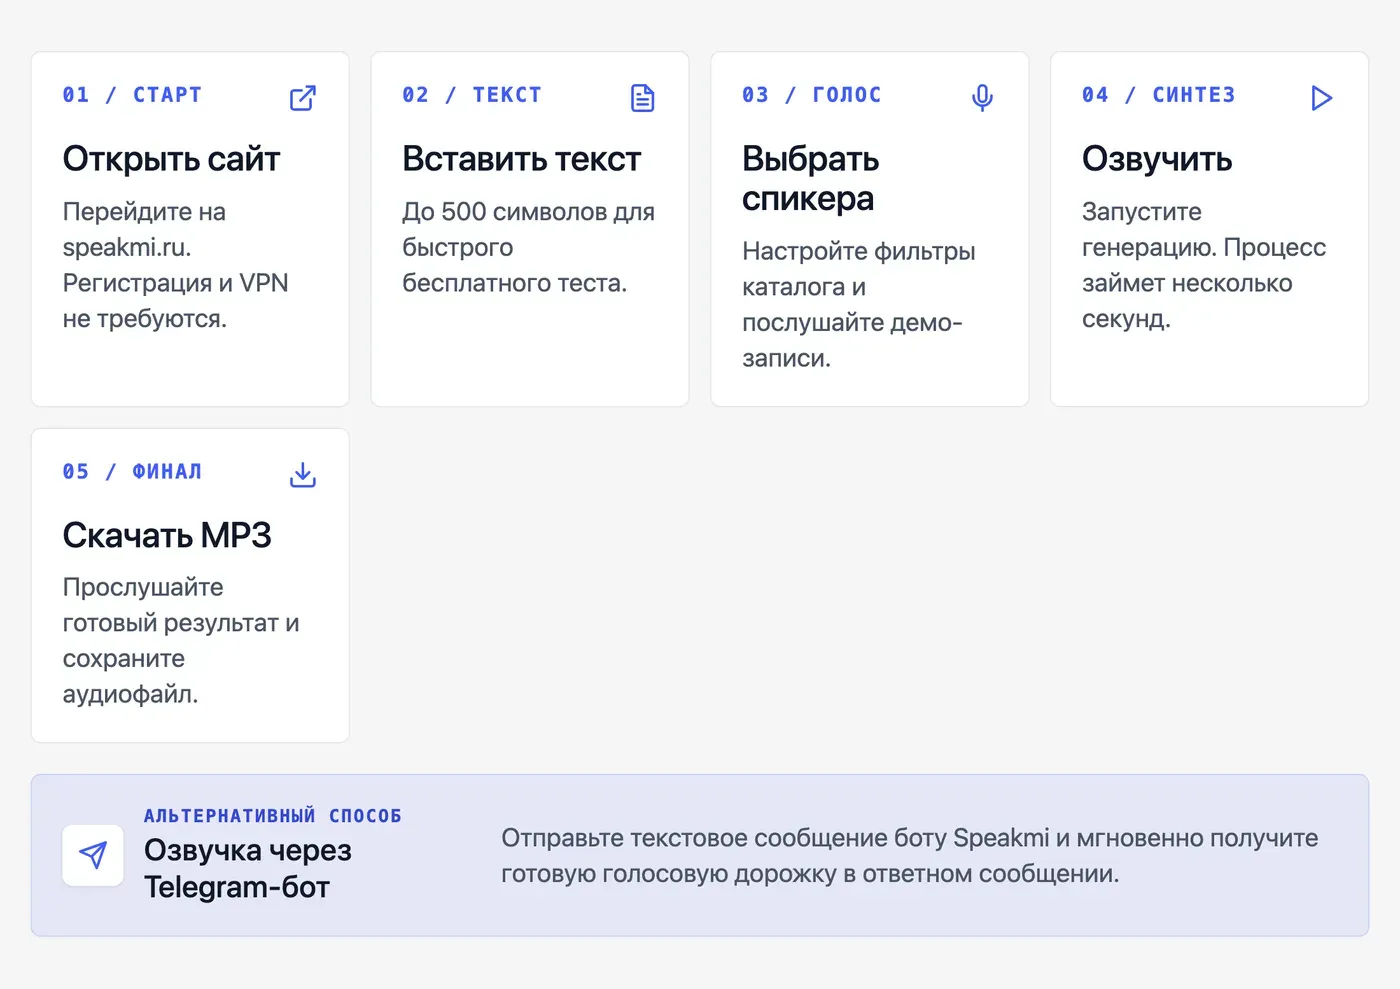
Для бесплатной озвучки текста на русском языке достаточно открыть онлайн-редактор, вставить подготовленный текст, выбрать подходящий голос из каталога и запустить генерацию. Весь процесс занимает менее двух минут и не требует установки стороннего софта или настройки VPN. Большинство современных платформ позволяют скачать готовый аудиофайл в формате MP3 сразу после прослушивания.
Показываем пошагово на примере Speakmi:
Шаг 1. Открой сервис
Переходи на speakmi.ru. Регистрация не нужна — редактор доступен сразу.
Шаг 2. Вставь текст
Вставляй текст в поле редактора. Рекомендуемая длина для первого теста — до 500 символов, чтобы уложиться в бесплатные 30 секунд и оценить качество голоса на своем реальном тексте.
Подсказка редактору: скриншот поля ввода с примером вставленного текста.
Шаг 3. Выбери голос
Открой каталог голосов. Фильтруй по полу, возрасту, характеру. Можно прослушать короткое демо каждого голоса перед генерацией.
Подсказка редактору: скриншот каталога с фильтрами.
Шаг 4. Нажми «Озвучить»
Генерация занимает несколько секунд на короткий текст. Статус отображается прямо в интерфейсе.
Шаг 5. Прослушай и скачай
Результат можно прослушать в браузере и скачать в MP3. Файл готов к монтажу.
Подсказка редактору: скриншот плеера с кнопкой скачивания.
Если предпочитаешь работать в Telegram — бот Speakmi делает то же самое: отправляешь текстовое сообщение, получаешь голосовую дорожку в ответ.
Какой голос выбрать для YouTube, Reels или Telegram-канала?
Выбор голоса напрямую зависит от формата контента: для динамичных коротких видео подходят быстрые молодежные голоса, а для длинных подкастов — глубокие и спокойные тембры. Правильно подобранный голос повышает вовлеченность и формирует звуковую идентичность вашего проекта. Ошибки в выборе интонации могут оттолкнуть аудиторию даже при качественном визуальном ряде.
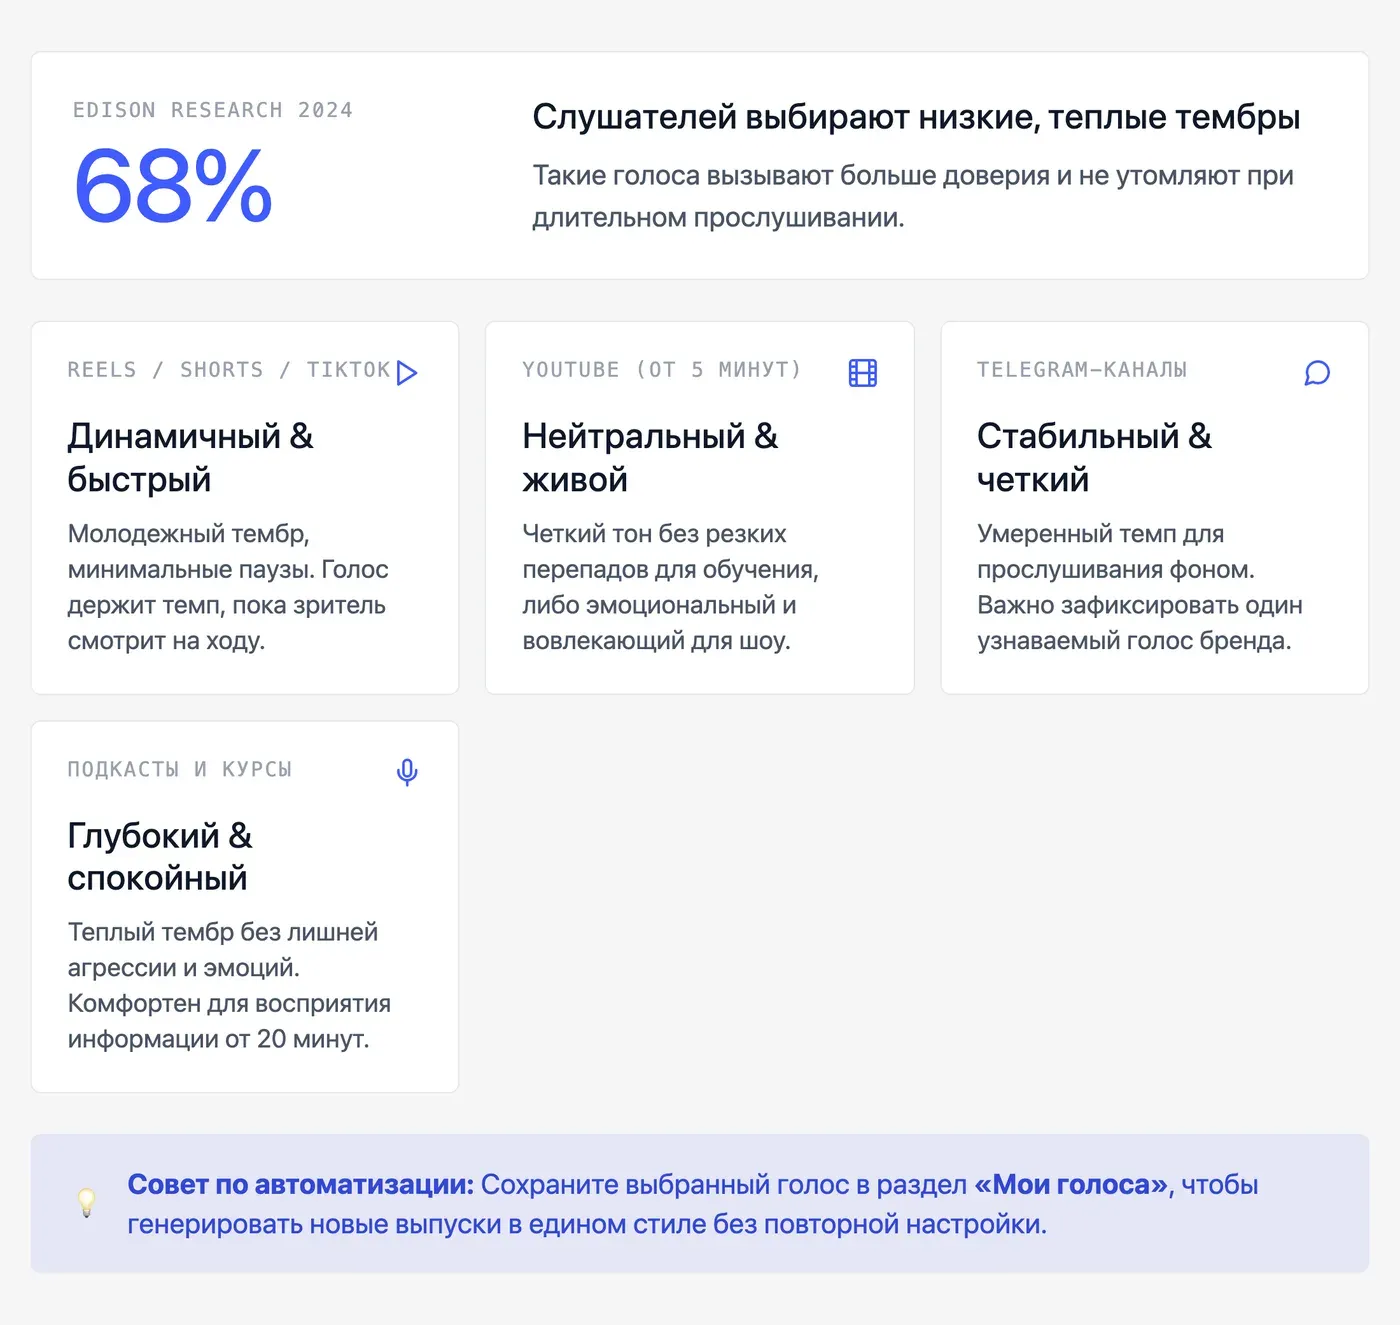
Исследование Edison Research (2024) показывает, что 68% слушателей разговорных аудиоформатов предпочитают низкие, теплые мужские и женские голоса, так как они вызывают больше доверия и меньше утомляют при длительном прослушивании.
Практические ориентиры по форматам:
-
Короткие вертикальные видео (Reels, Shorts, TikTok): Динамичный молодой голос, чуть выше среднего темпа. Паузы — короткие. Зритель смотрит на ходу, голос должен держать темп.
-
YouTube-ролики от 5 минут: Нейтральный или дружелюбный, мужской или женский — зависит от темы. Обучающий контент хорошо ложится на спокойный четкий голос без ярких эмоциональных перепадов. Развлекательный — на более живой, с интонацией.
-
Telegram-канал: Здесь слушают чаще фоном — в транспорте, на ходу. Важны четкость и умеренный темп. Голос должен быть узнаваем от выпуска к выпуску, поэтому если публикуешь регулярно — фиксируй один голос и не меняй его без причины.
-
Подкаст: Спокойный, теплый тембр. Слушатель проводит с голосом 20–40 минут — агрессивная интонация или монотонность быстро утомляют.
-
Обучающие материалы (курсы, инструкции): Нейтральный, без лишних эмоций, четкая артикуляция. Слушатель запоминает информацию, а не голос — это и есть цель.
Если публикуешь сериями — один раз сохраняешь голос в «Мои голоса» и дальше просто вставляешь новый текст на каждый выпуск, без повторной записи.
Когда бесплатной озвучки хватает, а когда нужен платный тариф?
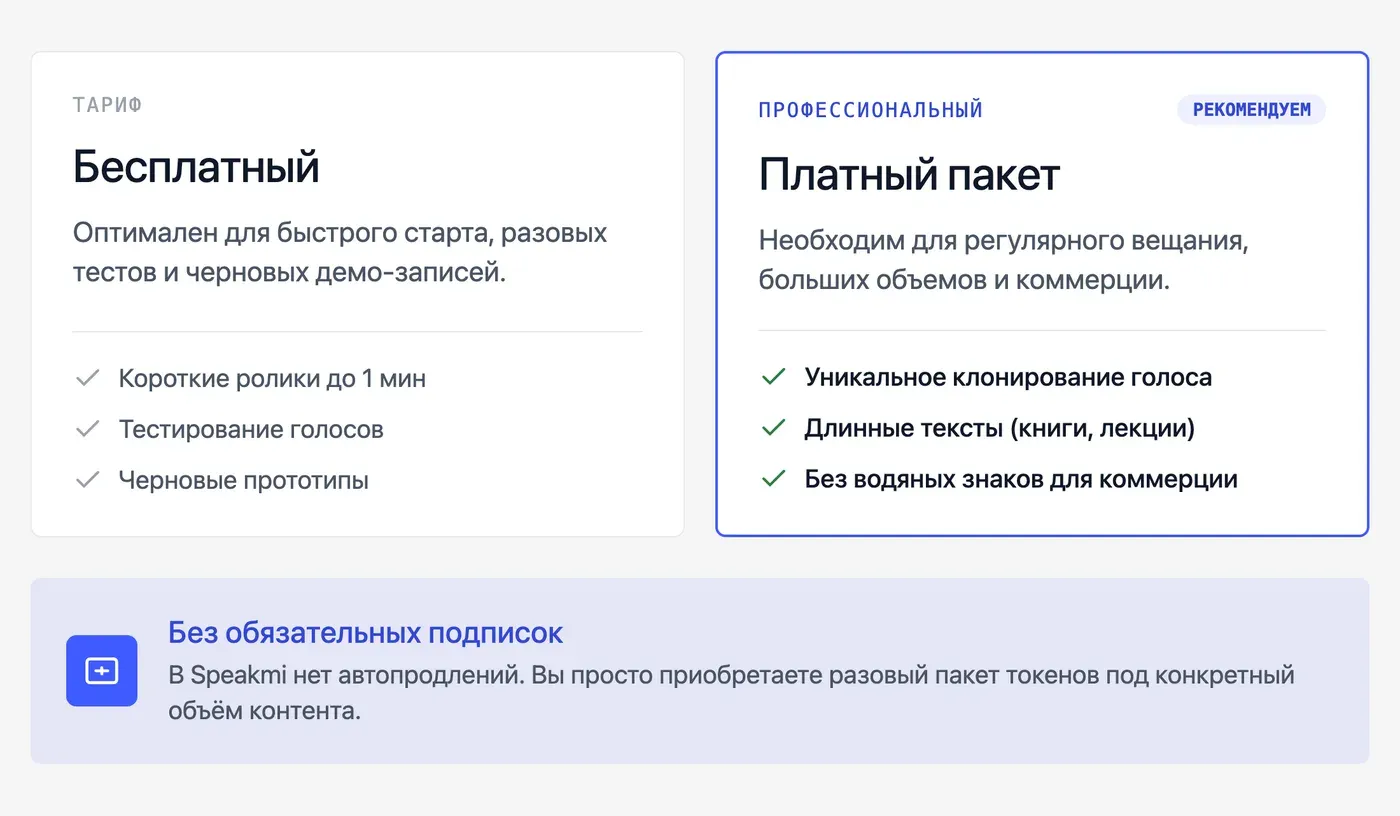
Бесплатный тариф оптимален для разовых задач, тестирования возможностей нейросети и создания коротких демо-записей. Платный тариф становится необходимостью при регулярном производстве контента, потребности в уникальном клонировании голоса и работе с большими объемами текстов. Коммерческое использование аудио также чаще всего требует перехода на профессиональные планы без водяных знаков.
Бесплатного хватит, если:
-
Нужно один раз озвучить короткий ролик до 1 минуты
-
Хочешь проверить, подходит ли нейросетевая озвучка для твоего контента вообще
-
Делаешь прототип, который не идет в публикацию
Платный тариф нужен, если:
-
Публикуешь регулярно — раз в неделю и чаще
-
Хочешь клонировать свой голос и использовать его на всех выпусках
-
Нужны длинные тексты — лекция, подкаст, аудиокнига
-
Важно скачивать файлы без водяного знака для коммерческого использования
Переход к платному плану в Speakmi — это пакет токенов, без подписки с автопродлением. Берёшь ровно столько, сколько нужно на текущий объём контента.
Частые вопросы
- Можно ли озвучить текст разными голосами бесплатно без регистрации?
- Да, несколько сервисов работают без регистрации. Speakmi и Murf AI не требуют аккаунта для первой генерации. KikiVoice заявляет полный доступ без регистрации. ERA2 Voice требует быструю регистрацию (~30 секунд).
- Какой сервис озвучки текста на русском языке лучший в 2026 году?
- Зависит от задачи. Для нативного русского языка с клонированием голоса — Speakmi. Для диалогов с несколькими персонажами — AnyToSpeech. Для максимального каталога голосов — Speechify или KikiVoice. Для работы только на русском без VPN — Speakmi, ERA2 Voice, ToSpeech, SpeechService.
- Есть ли бесплатная озвучка текста нейросетью без ограничений по символам?
- KikiVoice заявляет отсутствие ограничений по количеству использований, но «без ограничений» стоит проверять самостоятельно перед коммерческим применением. Большинство сервисов ограничивают либо символы, либо минуты аудио на бесплатном плане.
- Можно ли скачать озвученный файл MP3 бесплатно?
- ERA2 Voice и Speakmi позволяют скачать MP3 на бесплатном лимите. Часть сервисов разрешает только прослушивание в браузере без скачивания — уточняй до генерации, чтобы не потратить лимит впустую.
- Чем нейросетевая озвучка отличается от синтеза речи Google?
- Google TTS — базовый синтез: один-два голоса, роботизированная интонация, без управления эмоциями. Нейросетевые сервисы дают десятки и сотни голосов, поддерживают эмоции, паузы, разный темп, клонирование голоса. Разница в восприятии значительная: Google TTS слышно сразу, нейросетевой голос звучит как человек.
- Как выбрать голос для озвучки YouTube-видео или Reels?
- Для Reels и Shorts — динамичный молодой голос, быстрый темп. Для длинных YouTube-роликов — нейтральный или дружелюбный, зависит от темы. Главное: зафикси один голос на канал и не меняй его — аудитория привыкает к тембру так же, как к музыке заставки.
- Что такое клонирование голоса и доступно ли оно бесплатно?
- Клонирование голоса — создание цифровой копии твоего голоса из короткой записи (10–30 секунд). Дальше нейросеть читает любой текст этим голосом. В Speakmi клонирование доступно — запись делается прямо в Telegram-боте через голосовое сообщение. Первые 30 секунд озвучки бесплатно, без карты.