Сайт где озвучивают текст: как сделать озвучку нейросетью за 2 минуты
Ищете сайт, где озвучивают текст? Спикми (Speakmi) превращает любой текст в речь за 2 минуты. Примеры озвучки, типы голосов и пошаговая инструкция — внутри.
Если ролик нужен сегодня — заходишь в Speakmi (Спикми), вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Что такое озвучка текста нейросетью и чем она отличается от диктора?
Нейросетевая озвучка — это когда текст читает не человек, а модель, обученная на тысячах часов живой речи. Результат — естественные интонации, паузы, ударения. Не идеально, но узнаваемо.
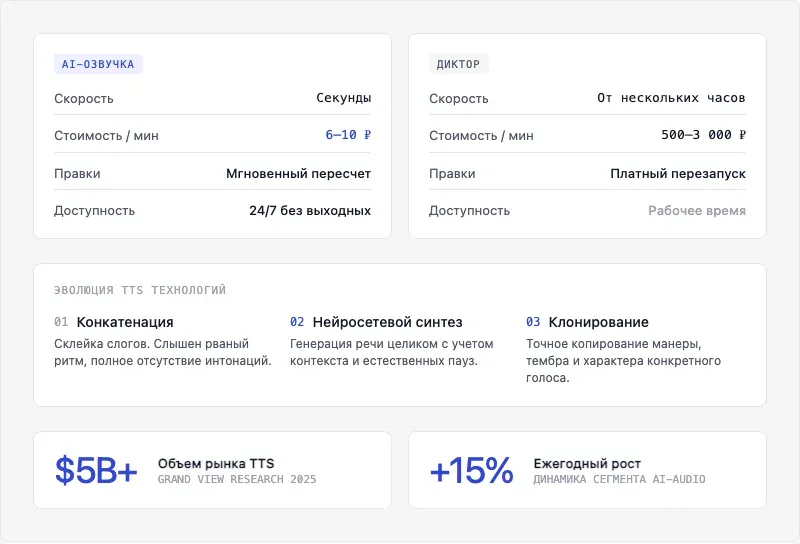
Разница с живым диктором — в скорости и цене:
| Параметр | Нейросеть | Живой диктор |
|---|---|---|
| Время готовности | Секунды — минуты | От нескольких часов |
| Стоимость 1 минуты | 6–10 ₽ | 500–3 000 ₽ |
| Правка готовой дорожки | Меняешь текст и переозвучиваешь | Переписываешь и перезаписываешь |
| Работа ночью/выходные | Да | Нет |
| Узнаваемость голоса | Зависит от типа (см. ниже) | Всегда чужой голос |
TTS (text-to-speech) прошёл три поколения. Конкатенативный синтез — старый метод: модель собирала речь из заранее записанных слогов. Слышно сразу: рваный ритм, нет интонации. Нейросетевой синтез — модель генерирует речь целиком, с учётом контекста предложения. Клонированный голос — отдельный случай: модель обучается на твоей записи и воспроизводит именно твою манеру речи.
По данным Grand View Research (2025), мировой рынок TTS-технологий превысил 5 млрд долларов и продолжает расти на 14–15% в год — это один из самых быстрорастущих сегментов AI-аудио. Сейчас в сервисах класса Speakmi работает нейросетевой синтез на базе движка Fish Audio — это тот же уровень, что у топовых зарубежных платформ, с поддержкой русского языка и оплатой картой РФ без VPN.
Fish Audio — товарный знак его правообладателя. Мы не являемся его представителем или партнёром; используем API Fish Audio как поставщика технологии синтеза речи.
Какие типы речи бывают в тексте и какой выбрать для своего проекта?
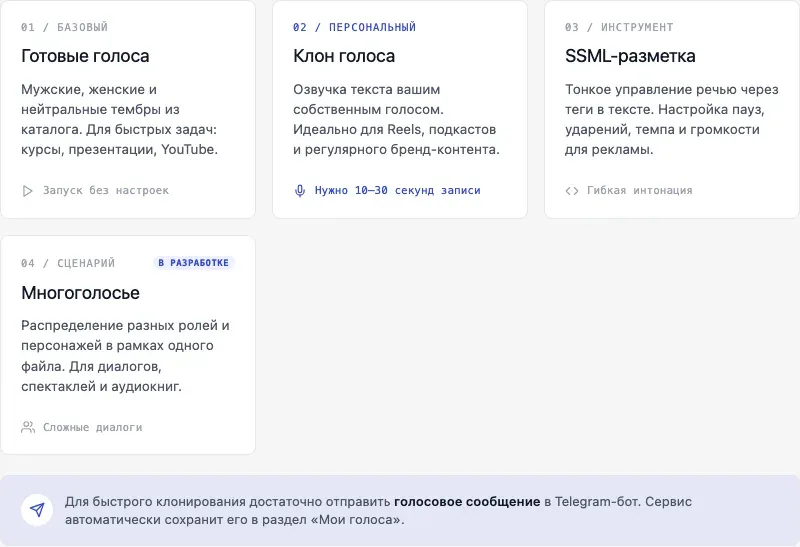
Четыре типа — четыре задачи. Выбор зависит от того, что ты делаешь: разовое видео или регулярный контент, нужен твой голос или подойдёт любой.
Нейросетевая речь (готовый голос из каталога)
Берёшь один из готовых голосов — мужской, женский, нейтральный. Подходит для большинства задач: YouTube-ролики, обучающие курсы, озвучка слайдов. Быстро, без настройки.
Клонированный голос
Загружаешь запись своего голоса на 10–30 секунд — сервис делает клон. Дальше этот голос читает любой текст так, будто говоришь ты. Хорошо для подкастов, Reels, серийного контента — аудитория привыкла к твоей подаче, и голос должен быть узнаваем.
SSML-разметка (управление интонацией)
Специальные теги прямо в тексте: пауза, ударение, скорость, громкость. Нужна там, где стандартная интонация не работает — реклама, обучение, диалоги. Не отдельный тип голоса, а инструмент управления любым голосом.
Многоголосая озвучка
Разные персонажи — разные голоса в одном файле. Для сторителлинга, диалогов, аудиокниг. В Speakmi эта функция в разработке.
Если публикуешь сериями — один раз сохраняешь голос в «Мои голоса» и дальше просто вставляешь новый текст на каждый выпуск, без повторной записи.
Свой голос клонируется из записи на 10–30 секунд — в Telegram-боте это просто отправленное голосовое сообщение, без загрузки файлов и настройки студии.
Примеры речи в тексте: как звучит нейросеть на реальных задачах?
Нейросеть справляется по-разному в зависимости от типа текста. Вот четыре реальных сценария — и что важно учесть в каждом.
Новостной текст
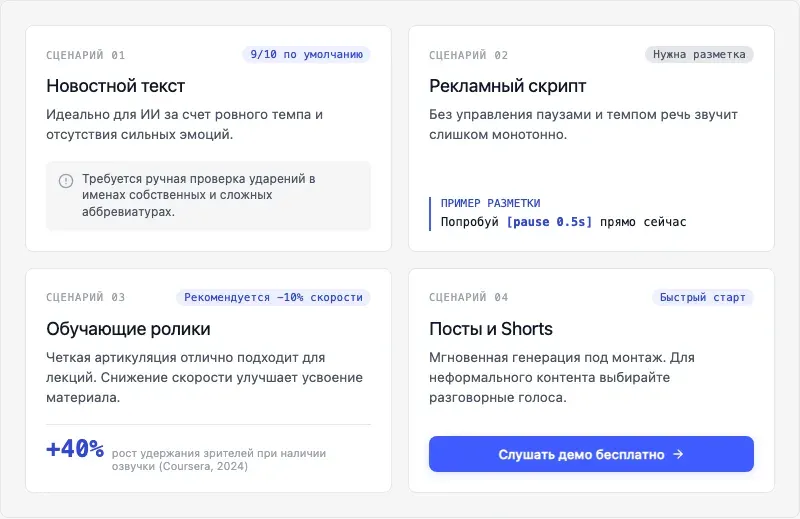
Нейтральный темп, ровная интонация. Нейросеть читает хорошо — нет резких эмоциональных перепадов, которые здесь и не нужны. Главное: проверить ударения в именах и аббревиатурах.
Рекламный скрипт
Тут важна интонация. Без SSML-тегов речь выйдет монотонной. Добавляешь паузы перед ключевым словом, меняешь темп — результат заметно лучше. Пример: «Попробуй [pause 0.5s] прямо сейчас» звучит живее, чем без паузы.
Обучающий ролик
Средний темп, чёткая артикуляция — нейросеть справляется с этим форматом хорошо. Можно замедлить речь на 10–15% через параметр скорости и получить комфортный темп для восприятия сложного материала. По данным исследования Coursera (2024), видео с профессиональной озвучкой досматривают на 40% чаще, чем ролики с фоновой музыкой без голоса — аудиодорожка напрямую влияет на удержание.
Telegram-пост или короткое видео
Короткий текст — самый простой случай. Генерация занимает секунды, файл сразу готов к монтажу. Если голос звучит слишком официально — попробуй другой голос из каталога, более разговорный.
Демо-записи на реальных текстах — на главной странице Speakmi, без регистрации.
Как озвучить текст на сайте Speakmi: пошаговая инструкция
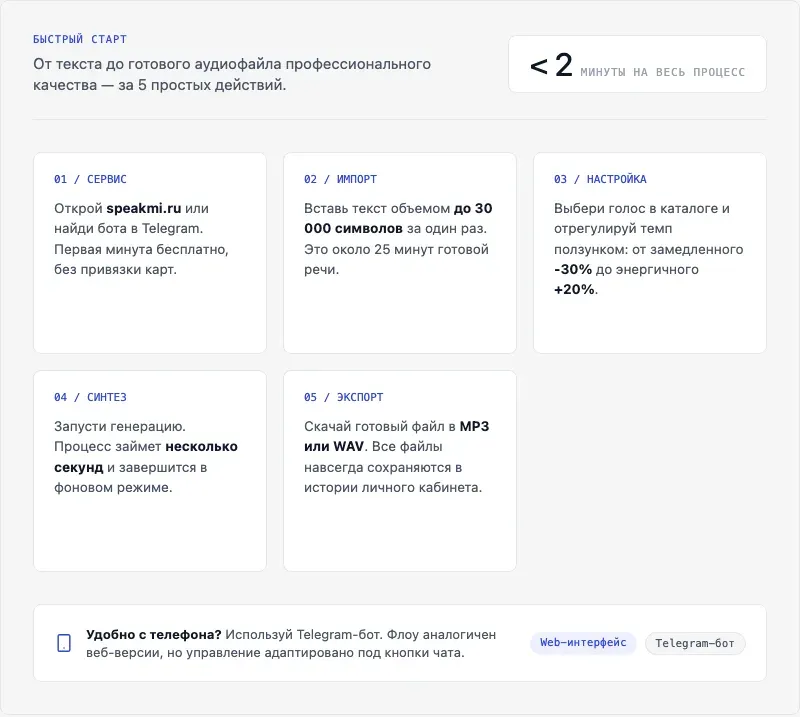
Весь процесс — пять шагов, меньше двух минут на короткий текст.
-
Открой сервис. Веб-версия — speakmi.ru, Telegram-бот — найди по названию в поиске Telegram. Первые 30 секунд бесплатно, карта не нужна.
-
Вставь текст. До 30 000 символов в одной генерации — это примерно 20–25 минут готовой речи. Можно вставить скрипт целиком, не разбивать на части.
-
Выбери голос и скорость. В каталоге — готовые голоса с прослушкой; скорость регулируй ползунком: -30% для обучения, стандарт для нейтрального контента, +20% если нужен энергичный темп.
-
Запусти генерацию. Для текста на минуту процесс занимает несколько секунд и идёт в фоне — можно сразу переходить к следующему делу.
-
Скачай MP3 или WAV. Файл сразу готов к монтажу. История генераций сохраняется — можно вернуться к старым файлам без повторной озвучки.
В Telegram-боте флоу тот же, только интерфейс — кнопки в чате. Удобно, когда работаешь с телефона: отправил текст → выбрал голос кнопкой → получил аудиофайл.
Сайт где озвучивают текст бесплатно vs платно: что реально получаешь?
Честная таблица — включая то, где Speakmi проигрывает.
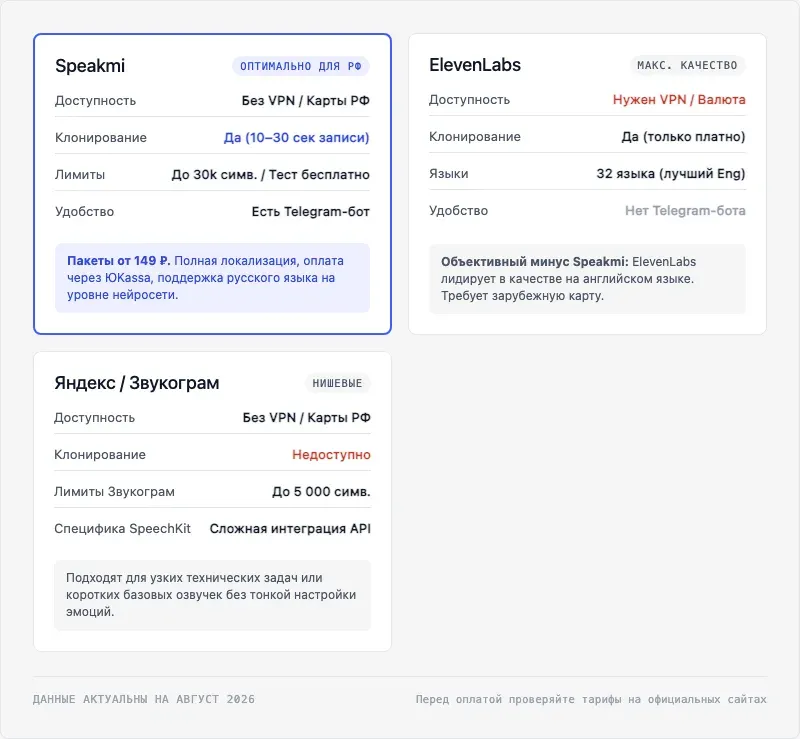
| Параметр | Speakmi Free | Speakmi (пакет от 149 ₽) | ElevenLabs | Яндекс SpeechKit | Звукограм |
|---|---|---|---|---|---|
| Язык | Русский + другие | Русский + другие | 32 языка | Русский | Русский + другие |
| Лимит символов | Первые 30 секунд бесплатно | До 30 000 за генерацию | Зависит от плана | По API-запросам | До 5 000 (бесплатно) |
| Качество голоса | Нейросетевое | Нейросетевое | Очень высокое | Высокое | Нейросетевое |
| Клонирование голоса | Нет | Да (10–30 сек записи) | Да (платно) | Нет | Нет |
| Оплата картой РФ | — | Да, ЮKassa | Нет (нужен VPN + валюта) | Да | Не проверяли |
| Без VPN | Да | Да | Нет | Да | Да |
| Скорость генерации | Секунды | Секунды | Секунды | Секунды | Секунды |
| Telegram-бот | Да | Да | Нет | Нет | Нет |
Где Speakmi проигрывает: ElevenLabs объективно даёт более высокое качество голоса на английском и сложных текстах. Если работаешь с международной аудиторией и готов разбираться с оплатой через VPN — это рабочий вариант. Для русскоязычного контента с оплатой из РФ разница в качестве менее заметна.
Данные по конкурентам — на август 2026. Тарифы меняются, проверяй актуальность на сайтах сервисов.
Сколько стоит озвучить текст нейросетью и как считаются токены?
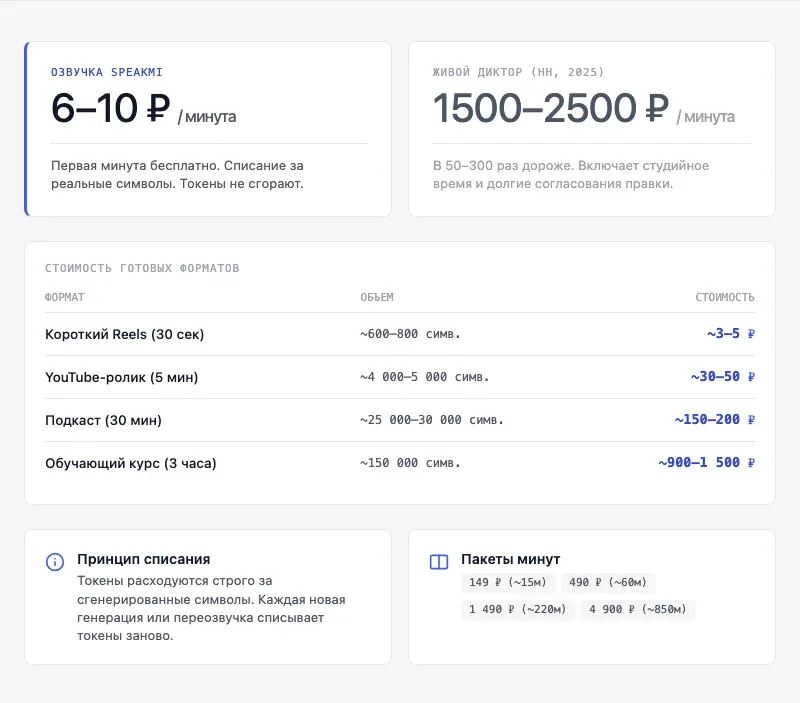
Одна минута готовой речи в Speakmi стоит 6–10 ₽. Для сравнения: живой диктор берёт 500–3 000 ₽ за минуту — это в 50–300 раз дороже. По данным HeadHunter (2025), средняя ставка профессионального диктора в России составляет 1 500–2 500 ₽ за готовую минуту озвучки с учётом студийного времени.
Единица списания — токены. Токены списываются за реально сгенерированные символы, не за время на сайте. Не понравился результат, хочешь переозвучить — это новая генерация, снова списываются токены за те же символы.
Сколько стоит реальный контент:
| Задача | Примерный объём | Ориентир стоимости |
|---|---|---|
| Короткий Reels-скрипт (30 сек) | ~600–800 символов | ~3–5 ₽ |
| YouTube-ролик (5 мин) | ~4 000–5 000 символов | ~30–50 ₽ |
| Подкаст (30 мин) | ~25 000–30 000 символов | ~150–200 ₽ |
| Обучающий курс (3 часа) | ~150 000 символов | ~900–1 500 ₽ |
Пакеты: 149 ₽ (~15 минут), 490 ₽ (~60 минут), 1 490 ₽ (~220 минут), 4 900 ₽ (~850 минут). Токены не сгорают — списывается только то, что реально озвучил.
Первые 30 секунд — бесплатно, без карты: можно послушать свой голос на реальном тексте прежде, чем платить.
Частые ошибки при озвучке текста и как их исправить за 30 секунд
-
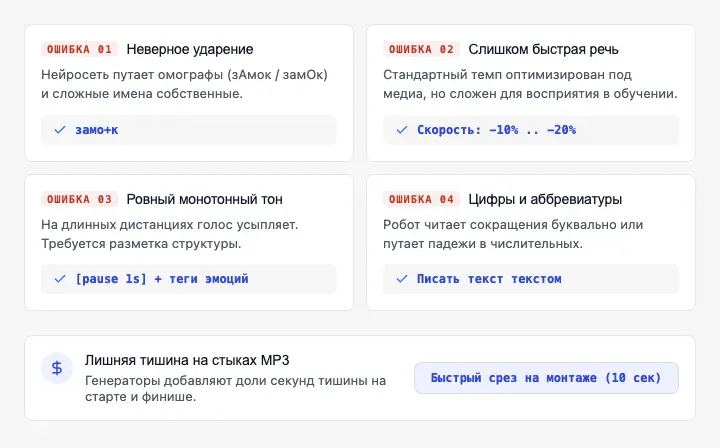
Неправильное ударение. Нейросеть читает «зАмок» вместо «замОк» или путается в именах собственных. Решение: добавь тег ударения прямо в тексте — большинство сервисов поддерживают синтаксис типа
замо+кили SSML-тег<emphasis>. В Speakmi — через теги эмоций и пауз. -
Слишком быстрая речь. Стандартный темп нейросети оптимизирован под нейтральный контент. Для обучения или объяснений сложных вещей это быстро. Решение: снизь скорость на 10–20% в настройках перед генерацией.
-
Монотонность на длинном тексте. Нейросеть держит ровную интонацию — через 3–4 минуты это начинает звучать как чтение вслух. Решение: раздели текст на смысловые блоки, добавь паузы между ними
[pause 1s], попробуй другой голос — более разговорный или с выраженной подачей. Эмоции и паузы задаются тегами прямо в тексте — не ползунками, поэтому интонацию можно поправить за одну правку, а не пересводить всё заново. -
Озвучка аббревиатур и цифр. «РФ» нейросеть может прочитать побуквенно или как слово. «2024» — как «две тысячи двадцать четыре» или «двадцать двадцать четыре». Решение: пиши так, как хочешь услышать — «Россия» вместо «РФ», «две тысячи двадцать четыре года» вместо «2024».
-
Скачал MP3, а в монтаже не то. Нейросеть добавляет небольшую тишину в начале и конце файла. Решение: обрезай в любом редакторе или прямо в монтажной программе — это займёт 10 секунд.
Частые вопросы
- Какой сайт озвучивает текст на русском языке бесплатно?
- Speakmi даёт первые 30 секунд бесплатно без регистрации карты. Из бесплатных без лимита по времени — FreeTTS.ru и Speecher.org, но качество там заметно ниже нейросетевого уровня.
- Чем нейросетевая озвучка отличается от обычного синтеза речи?
- Старый синтез собирал речь из заранее записанных слогов — слышно по рваному ритму и отсутствию интонации. Нейросеть генерирует речь целиком, с учётом контекста: паузы, ударения, эмоциональный окрас появляются сами, не из заготовок.
- Можно ли озвучить текст своим голосом через нейросеть?
- Да. Speakmi клонирует голос из записи на 10–30 секунд — подходит голосовое сообщение в Telegram. Дальше этот голос читает любой текст. Результат — узнаваемо похоже, не идеальная копия.
- Сколько символов можно озвучить бесплатно на Speakmi?
- Первые 30 секунд — бесплатно, около 400 символов текста в зависимости от темпа речи. Карта при этом не нужна.
- Какой формат файла получается после озвучки — MP3 или WAV?
- Speakmi отдаёт оба формата на выбор. MP3 — меньше весит, подходит для большинства задач. WAV — без сжатия, нужен если дальше будешь обрабатывать звук в профессиональном редакторе.
- Как поставить правильное ударение в озвучке текста?
- Проще всего — написать слово так, как хочешь его услышать, или добавить знак ударения прямо в текст. Например, «замо́к» вместо «замок». Большинство нейросетевых движков понимают символ ударения над гласной.
- Можно ли использовать озвученный текст в коммерческих видео на YouTube?
- Да, если голос из каталога сервиса — лицензия это разрешает для коммерческого использования. Если использовал клонированный голос — права на него твои, ограничений нет. Уточняй в оферте конкретного сервиса перед публикацией.