Спокойный голос для сна и ASMR: озвучка нейросетью
Как создать мягкий, тихий и приятный голос для сна или ASMR-контента без микрофона — выбор голоса, настройка темпа и готовый результат через ИИ за 5 минут.
Что делает голос «приятным для сна»: тембр, темп и интонация
Три параметра отвечают за то, засыпает ли человек под голос или нет.
Тембр — это «окраска» звука. Низкие голоса воспринимаются как более безопасные: они меньше нагружают нервную систему. Тембр можно сравнить с температурой — высокий голос ощущается холодным и бодрящим, низкий — тёплым и обволакивающим.
Темп важнее тембра. Нормальная разговорная речь — 120–150 слов в минуту. Для засыпания нужно 80–100: это темп, при котором мозг перестаёт ждать следующего слова и начинает «уплывать». В Speakmi достаточно поставить скорость 0,85–0,9 от стандарта.
Интонация — ровная, без восклицаний и резких подъёмов. Не монотонная (это утомляет), а плавная: небольшие понижения к концу фраз, как будто человек сам расслабляется по ходу речи.
Ни один из этих параметров не настраивается ползунком «сделать голос для сна». Результат зависит от выбора голоса и структуры самого текста — об этом дальше.
Чем ASMR-голос отличается от обычного спокойного голоса?
Оба формата помогают расслабиться, но работают по-разному.
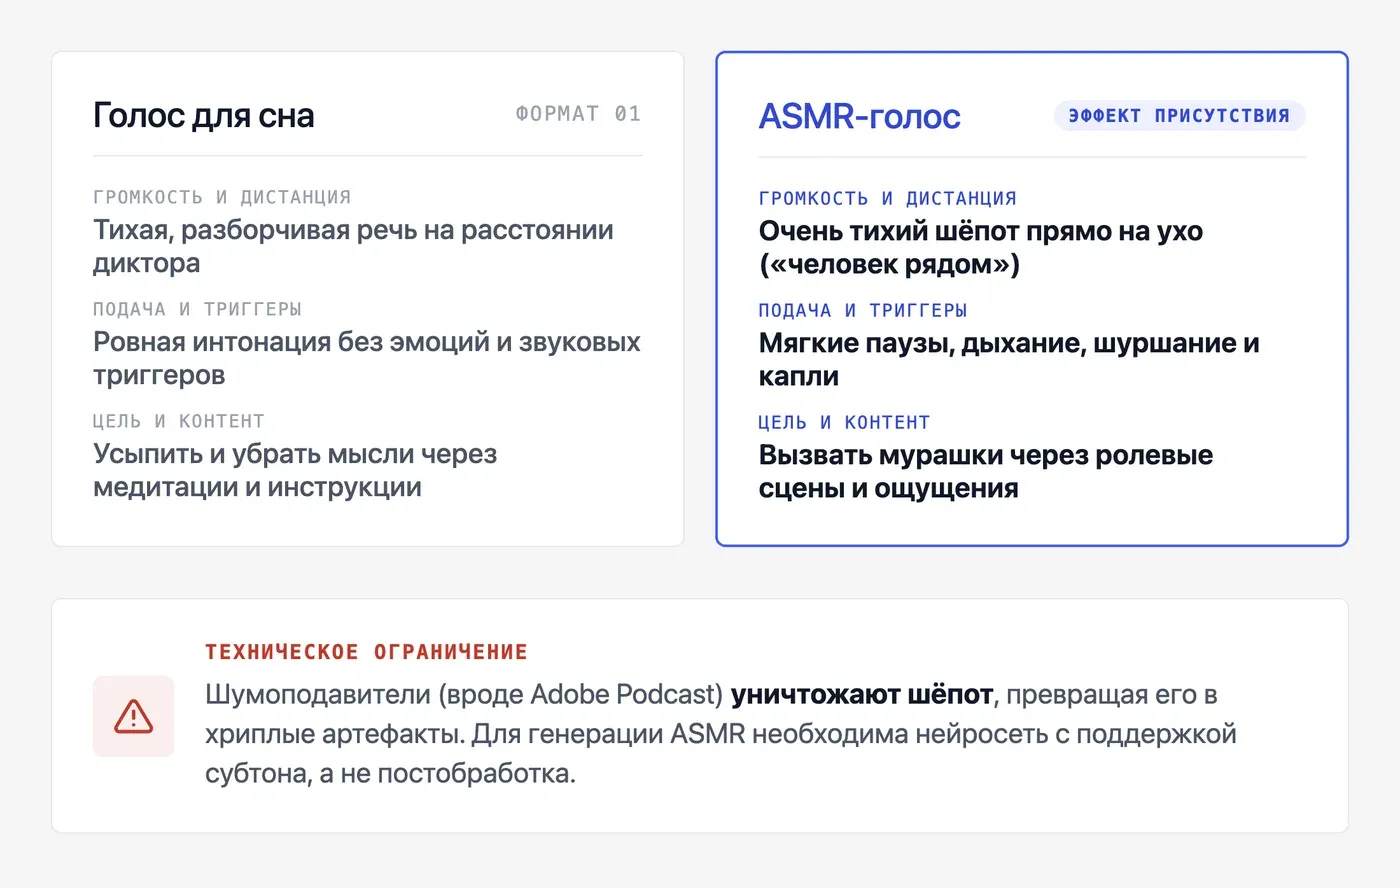
| Параметр | Спокойный голос для сна | ASMR-голос |
|---|---|---|
| Громкость | Тихая, но разборчивая | Очень тихая, почти шёпот |
| Расстояние | Обычное — как диктор | Близкое — эффект «человек рядом» |
| Интонация | Ровная, без эмоций | Мягкая, с мини-паузами между словами |
| Триггеры | Нет | Есть: шуршание, дыхание, капли |
| Задача | Убрать мысли, усыпить | Вызвать покалывание и расслабление |
| Текст | Медитация, рассказ, инструкция | Ролевая сцена, перечисление ощущений |
Adobe Podcast и другие нейросети для улучшения голоса плохо работают с шёпотом — алгоритм распознаёт только обычную речь и превращает шёпот в хриплый артефакт. Для генерации шёпота нужна нейросеть для озвучки с поддержкой субтона, а не инструмент постобработки. Про технику шёпотной озвучки — отдельная статья.
Если ты делаешь медитацию или плейлист для сна — достаточно спокойного голоса. Если хочешь ASMR-канал с триггерами — читай дальше про написание текста.
Какой голос выбрать в Speakmi для сна и ASMR: мужской, женский, шёпот?
В каталоге Speakmi 942 голоса. Для сна и расслабления подходит примерно десяток — остальные слишком бодрые, дикторские или с ярко выраженными эмоциями. Фильтруй по тегам «спокойный» и «нежный», прослушивай демо, сохраняй понравившийся в «Мои голоса».
Конкретные голоса под задачи:
-
Медитация, рассказ перед сном — «Спокойный женский голос», «Женский Спокойный». Ровная интонация, без театральности.
-
ASMR, близкий тёплый голос — «Нежная девушка», «Нежный женский голос». Мягче и тише, ощущение присутствия.
-
Нейтральный фоновый нарратив — «Спокойный», «Спокойный Русский Голос», «Спокойной голос».
-
Детский контент, сказки на ночь — «Милый Голос».
Мужской голос для сна работает так же хорошо, если он низкий и медленный. В каталоге ищи теги «спокойный» — там есть мужские варианты.
Если хочешь, чтобы ASMR звучал именно твоим голосом — клонируй его: запись-образец 10–30 секунд, и Спикми создаёт твой персональный голос. Подробнее — в разделе про инструкцию ниже.
Как написать текст для ASMR-озвучки: структура и примеры фраз
Нейросетевой голос звучит неестественно не из-за движка — из-за текста. Большинство проблем с интонацией (ровность пропадает, ударения съезжают) возникают, когда текст написан «для глаз»: длинные предложения, причастные обороты, союзы «несмотря на то что». Такой текст сложно прочитать даже человеку, и нейросеть это «слышит».
Правила текста для озвучки:
-
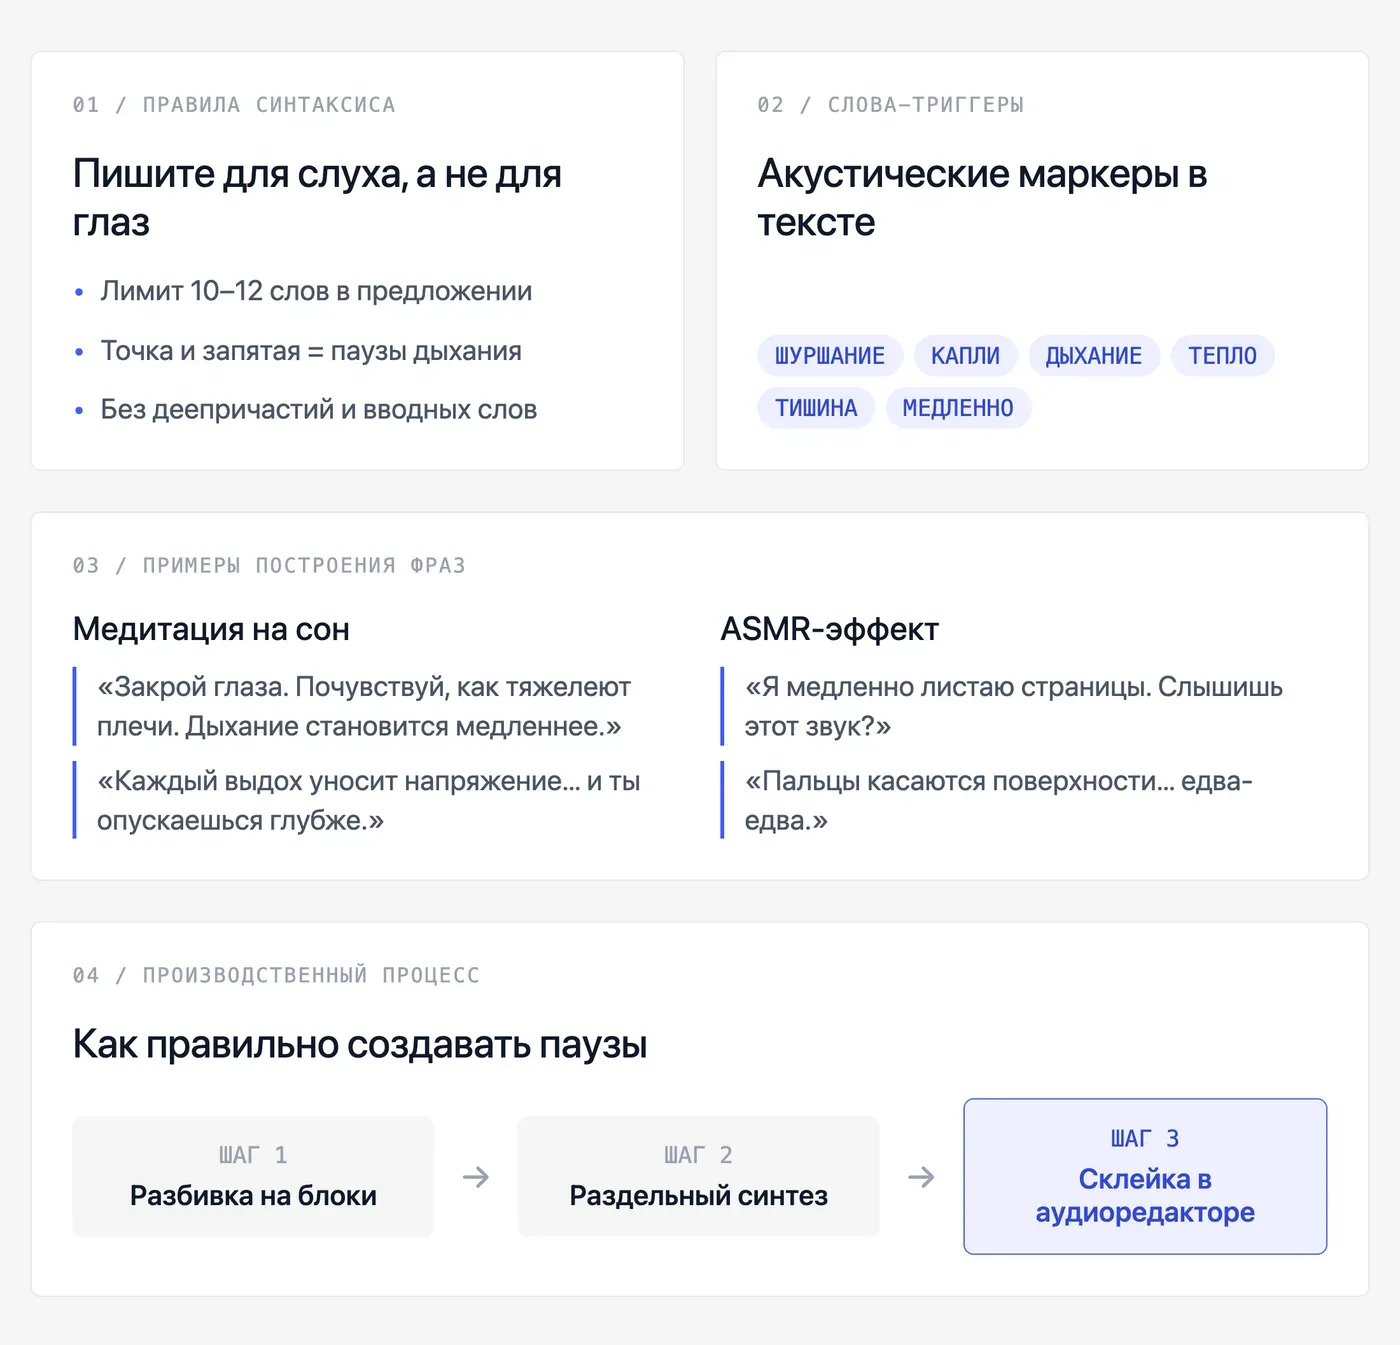
Короткие предложения — до 10–12 слов. Точка = пауза.
-
Запятые там, где реально нужна пауза дыхания.
-
Многоточие — для длинной паузы между образами.
-
Никаких деепричастных оборотов и вводных конструкций.
-
Слова-триггеры для ASMR: шуршание, капли, дыхание, тепло, тишина, мягко, медленно.
Примеры фраз для медитации на сон:
-
«Закрой глаза. Почувствуй, как тяжелеют плечи. Дыхание становится медленнее.»
-
«Ты слышишь тишину. Она мягкая. Она тёплая.»
-
«Каждый выдох уносит напряжение… и ты опускаешься глубже.»
Примеры фраз для ASMR:
-
«Я медленно листаю страницы. Слышишь этот звук?»
-
«Пальцы касаются поверхности… едва-едва.»
-
«Шёпот. Тихий. Почти неслышимый.»
Паузы между репликами настраиваются разбивкой текста на отдельные короткие блоки — каждый блок генерируется отдельно, потом склеивается в аудиоредакторе. Это удобнее, чем пытаться вставить паузу внутри одного длинного файла.
Как озвучить текст спокойным голосом через Speakmi: пошаговая инструкция
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Через сайт:
-
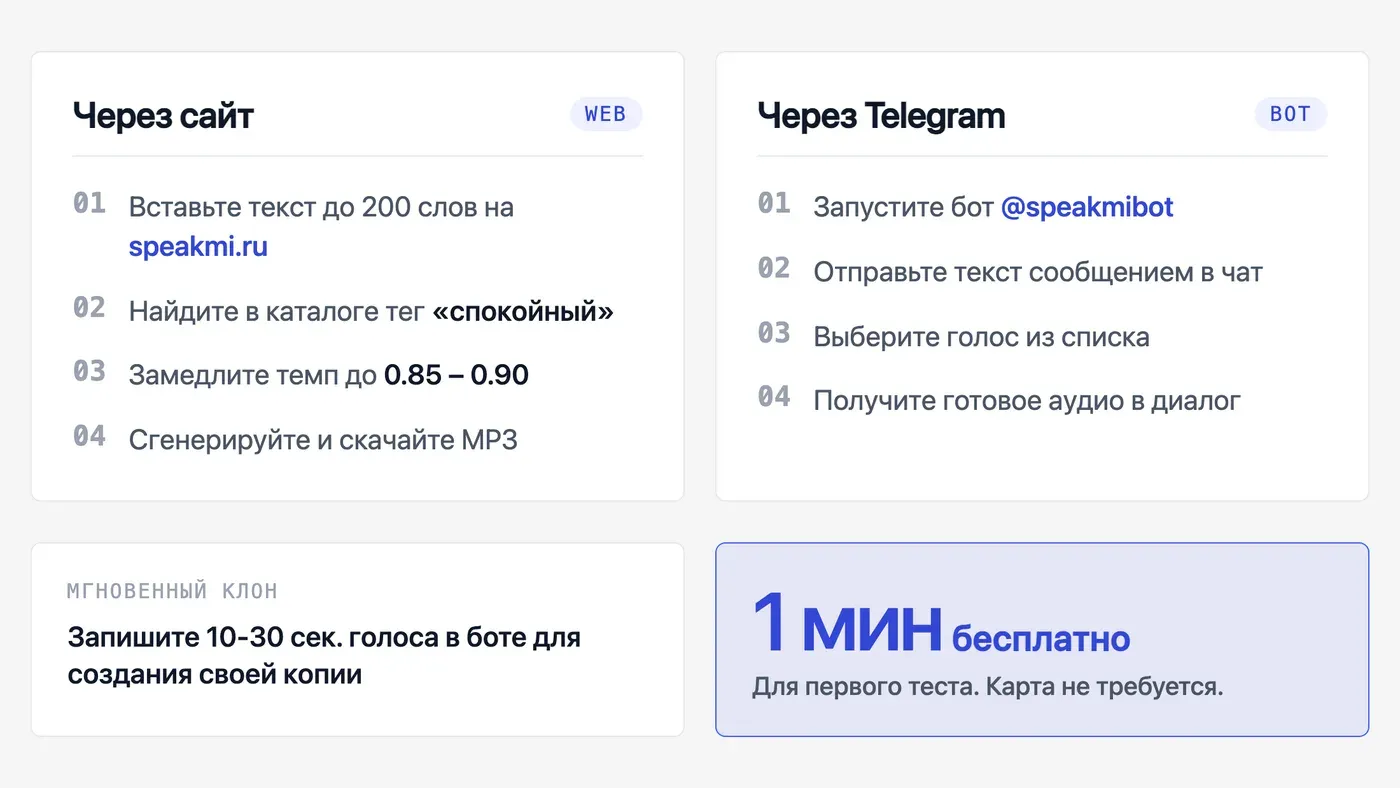
Открой speakmi.ru.
-
Вставь текст в поле. Рекомендуемый объём для первого теста — 100–200 слов.
-
Нажми «Выбрать голос», введи в поиск тег «спокойный» или «нежный».
-
Прослушай демо двух-трёх голосов, выбери подходящий.
-
Поставь скорость 0,85–0,90. Это замедляет темп без понижения тона.
-
Нажми «Сгенерировать», послушай превью.
-
Скачай MP3.
Через Telegram-бот:
-
Открой @speakmibot.
-
Отправь текстовое сообщение с нужным текстом.
-
Выбери голос из предложенного списка.
-
Получи аудиофайл прямо в чат.
Если хочешь клонировать свой голос — в боте это проще всего: отправь голосовое сообщение 10–30 секунд, Speakmi создаёт мгновенный клон. Для постоянного использования голос сохраняется в «Мои голоса».
Первые 30 секунд озвучки — бесплатно, без карты.
Где использовать готовое аудио: YouTube, подкасты, Telegram-канал для сна
Сгенерированный MP3 — обычный аудиофайл, который работает везде, где принимают звук.
YouTube. Видео для сна и медитации — один из самых стабильных форматов на платформе. Стандартная схема: статичная картинка или простая анимация + голосовая дорожка + фоновый звук (белый шум, дождь). Монтаж занимает 10–15 минут в любом редакторе.
Подкасты и аудио на Яндекс Музыке. Медитации и сторис для сна хорошо заходят как подкасты — формат длинный, аудитория лояльная, конкуренция ниже, чем в видео.
Telegram-канал. Голосовые сообщения с медитацией или ASMR-чтением — рабочий формат для небольшого канала. Подписчики слушают прямо в мессенджере, без перехода на другую платформу.
Reels и Shorts. Короткий ASMR-ролик — 15–60 секунд голоса + визуал. Для видео с физическими ASMR-триггерами (разрушение, текстуры) нейросети вроде Luma Dream Machine генерируют 6-секундные ролики по текстовому промпту — это отдельный конвейер, но голосовую дорожку к нему делает тот же Speakmi.
Сторис. Озвучить сторис текстом «голосом бренда» — без записи, без шума с улицы, без «сел голос в пятницу вечером».
«Раньше на один контентный блок уходило 4 часа ручной работы. Написала скрипт — вставляешь данные, получаешь результат за 5,5 минут.» — Лиза Наговицына, сооснователь Speakmi
Свой голос клонируется из записи на 10–30 секунд — в Telegram-боте это просто отправленное голосовое сообщение, без загрузки файлов и настройки студии.
Сколько стоит сделать ASMR-озвучку нейросетью: ИИ против живого диктора
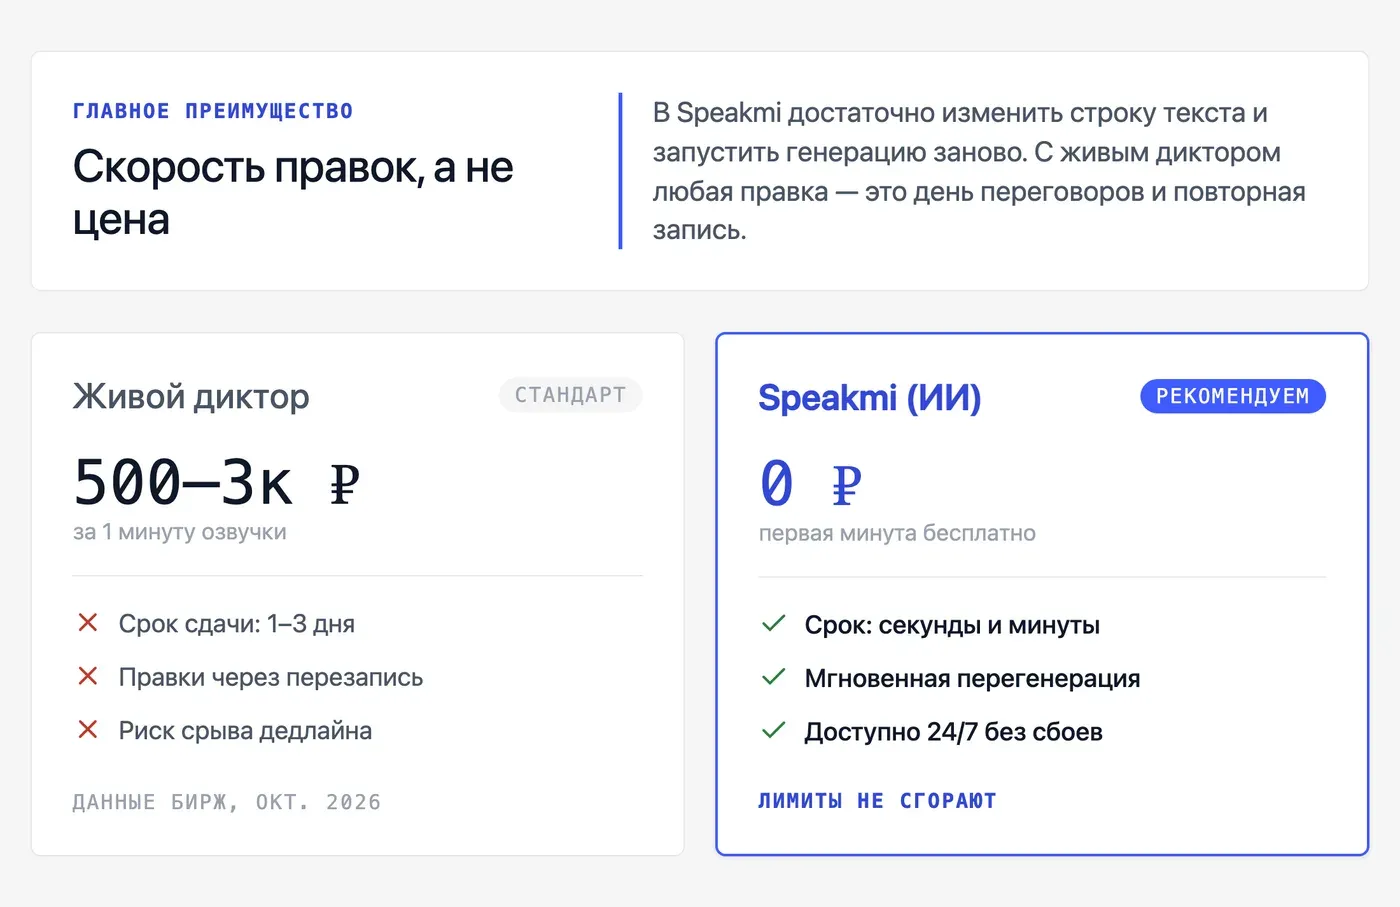
| Параметр | Живой диктор | Speakmi (ИИ) |
|---|---|---|
| Стоимость 1 минуты | 500–3 000 ₽ | первые 30 секунд бесплатно |
| Срок | 1–3 дня | секунды–минуты |
| Правка интонации | переозапись + ожидание | изменил текст — сгенерировал заново |
| Нужна ли запись | да | нет |
| Ночная запись | невозможна | без ограничений |
| Голос «сел» | срыв дедлайна | не актуально |
Цифры по диктору — рыночные ставки на биржах озвучки, октябрь 2026.
Главное преимущество ИИ-озвучки — не цена, а скорость правок. Если после первого прослушивания понял, что нужно замедлить темп или поменять паузу — меняешь одну строку текста и генерируешь заново. С живым диктором это день переговоров и повторная запись.
Пакеты токенов в Спикми не сгорают — купил, использовал в удобном темпе. Актуальные цены — на speakmi.ru.
Частые вопросы
- Можно ли сделать настоящий ASMR-голос нейросетью или это звучит как робот?
- Качество зависит от двух вещей: выбора голоса и структуры текста. Стандартный TTS без поддержки субтона действительно звучит механически на ASMR-материале. Speakmi работает на движке Fish Audio, который поддерживает мягкую и нежную речь — голоса «Нежная девушка» и «Нежный женский голос» дают результат, узнаваемо похожий на живую тихую речь, а не на автоответчик. Главное — писать текст короткими фразами с паузами, а не длинными предложениями. Fish Audio — товарный знак его правообладателя. Speakmi не является его представителем или партнёром; использует API Fish Audio как поставщика технологии генерации речи.
- Какой темп речи лучше всего подходит для аудио на засыпание?
- Для засыпания оптимально 80–100 слов в минуту — это примерно 0,85–0,90 от стандартного темпа в Speakmi. Обычная разговорная речь — 120–150 слов в минуту, она держит мозг в активном режиме. При 80–100 слов в минуту мозг перестаёт «ждать» следующего слова и начинает отключаться.
- Можно ли использовать ИИ-озвучку для сна на YouTube без нарушения авторских прав?
- Аудио, сгенерированное в Speakmi из твоего текста, принадлежит тебе — публикуй на YouTube, в подкастах, в Telegram без ограничений. Единственное условие: текст должен быть твоим или использоваться с разрешением автора. Чужие тексты, песни или книги без лицензии — нарушение авторских прав вне зависимости от того, кто озвучивает, человек или ИИ.
- Как добавить паузы и тишину в ИИ-озвучку для ASMR?
- Два способа. Первый — разбить текст на короткие блоки и генерировать каждый отдельно, потом склеить в аудиоредакторе с нужными промежутками тишины между ними. Второй — поставить многоточие или несколько запятых подряд в тексте: нейросеть читает их как паузу дыхания. Первый способ точнее — ты контролируешь длину паузы в секундах.
- Нужен ли микрофон, чтобы сделать ASMR-контент с нейросетью?
- Нет. Спикми генерирует голосовую дорожку из текста — микрофон не нужен вообще. Если хочешь добавить фоновые звуки (дождь, белый шум, треск костра) — они накладываются поверх готового MP3 в любом аудиоредакторе. Это отдельный слой, не часть генерации.
- Можно ли клонировать свой голос, чтобы ASMR звучал как я?
- Да, клонирование голоса — рабочая функция в Speakmi прямо сейчас. В Telegram-боте @speakmibot достаточно отправить голосовое сообщение 10–30 секунд — создаётся мгновенный клон. Для постоянного использования голос сохраняется в «Мои голоса» и доступен в один клик на каждый новый текст. Клонировать можно только свой голос или с письменного согласия человека.
- Сколько символов входит в бесплатные 30 секунд озвучки?
- Одна минута звучания — примерно 700–900 символов текста, в зависимости от темпа и голоса. При скорости 0,85 это около 750–800 символов. Первые 30 секунд в Speakmi бесплатны, карта не нужна — можно проверить свой текст на реальном голосе до покупки пакета.