Сценарий для озвучки: как написать и озвучить ИИ
Как написать сценарий для озвучки и сразу озвучить его нейросетью. Структура текста, топ ИИ-инструментов и пошаговый алгоритм — от идеи до готового аудио.
Что такое сценарий для озвучки и чем он отличается от обычного текста?
Статья может начинаться с «В 2026 году рынок озвучки вырос на 34%» — и это нормально для чтения. Но нейросеть прочитает «2026» как «два тысячи двадцать шесть» или «двадцать двадцать шесть» в зависимости от движка. Сценарий требует: «в две тысячи двадцать шестом году».
Три главных отличия:
-
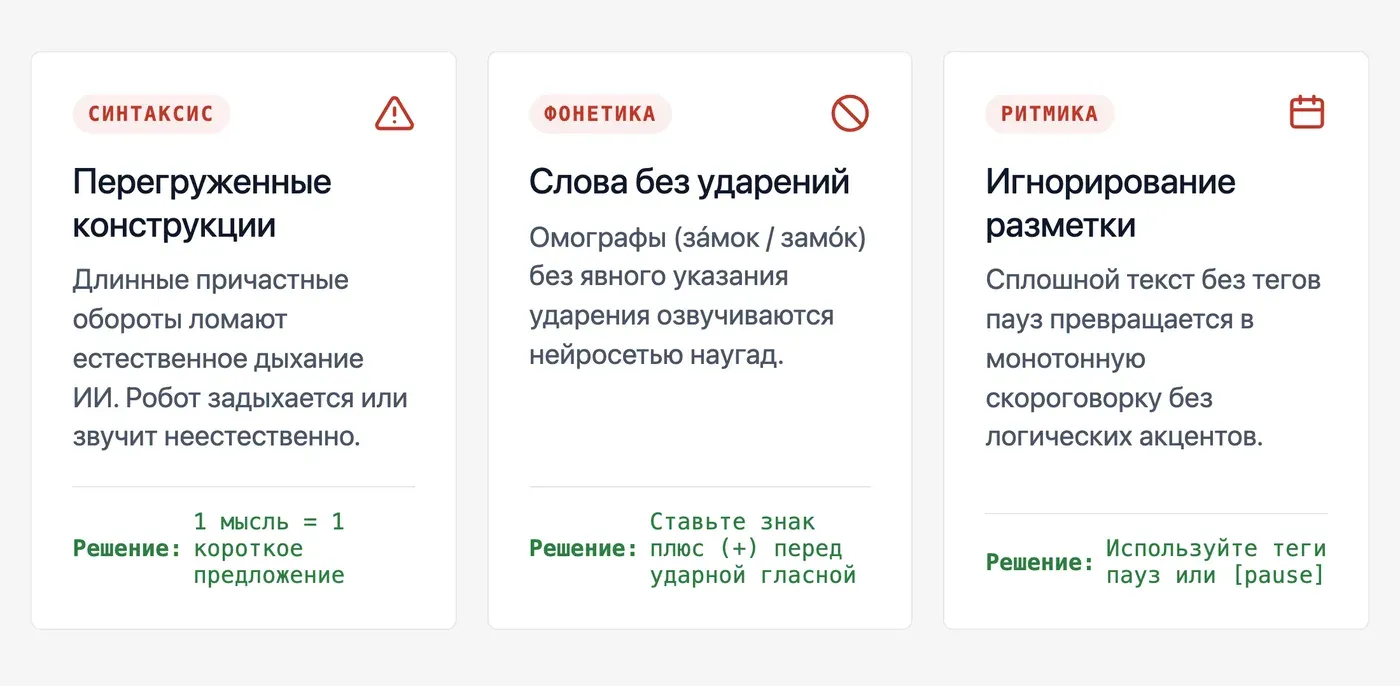
Предложения короткие. 10–15 слов — комфортный максимум. Длинные конструкции со вставными оборотами нейросеть читает монотонно.
-
Числа и аббревиатуры расписаны. «ИИ» — «искусственный интеллект», «5 мин» — «пять минут», «30°C» — «тридцать градусов».
-
Паузы заложены в структуру. Там, где живой диктор сделал бы паузу — точка, многоточие или тег эмоции.
Хороший сценарий сокращает постобработку до минимума. Плохой — даёт роботизированный монотонный результат даже при качественном движке.
Как написать сценарий для озвучки: пошаговая структура
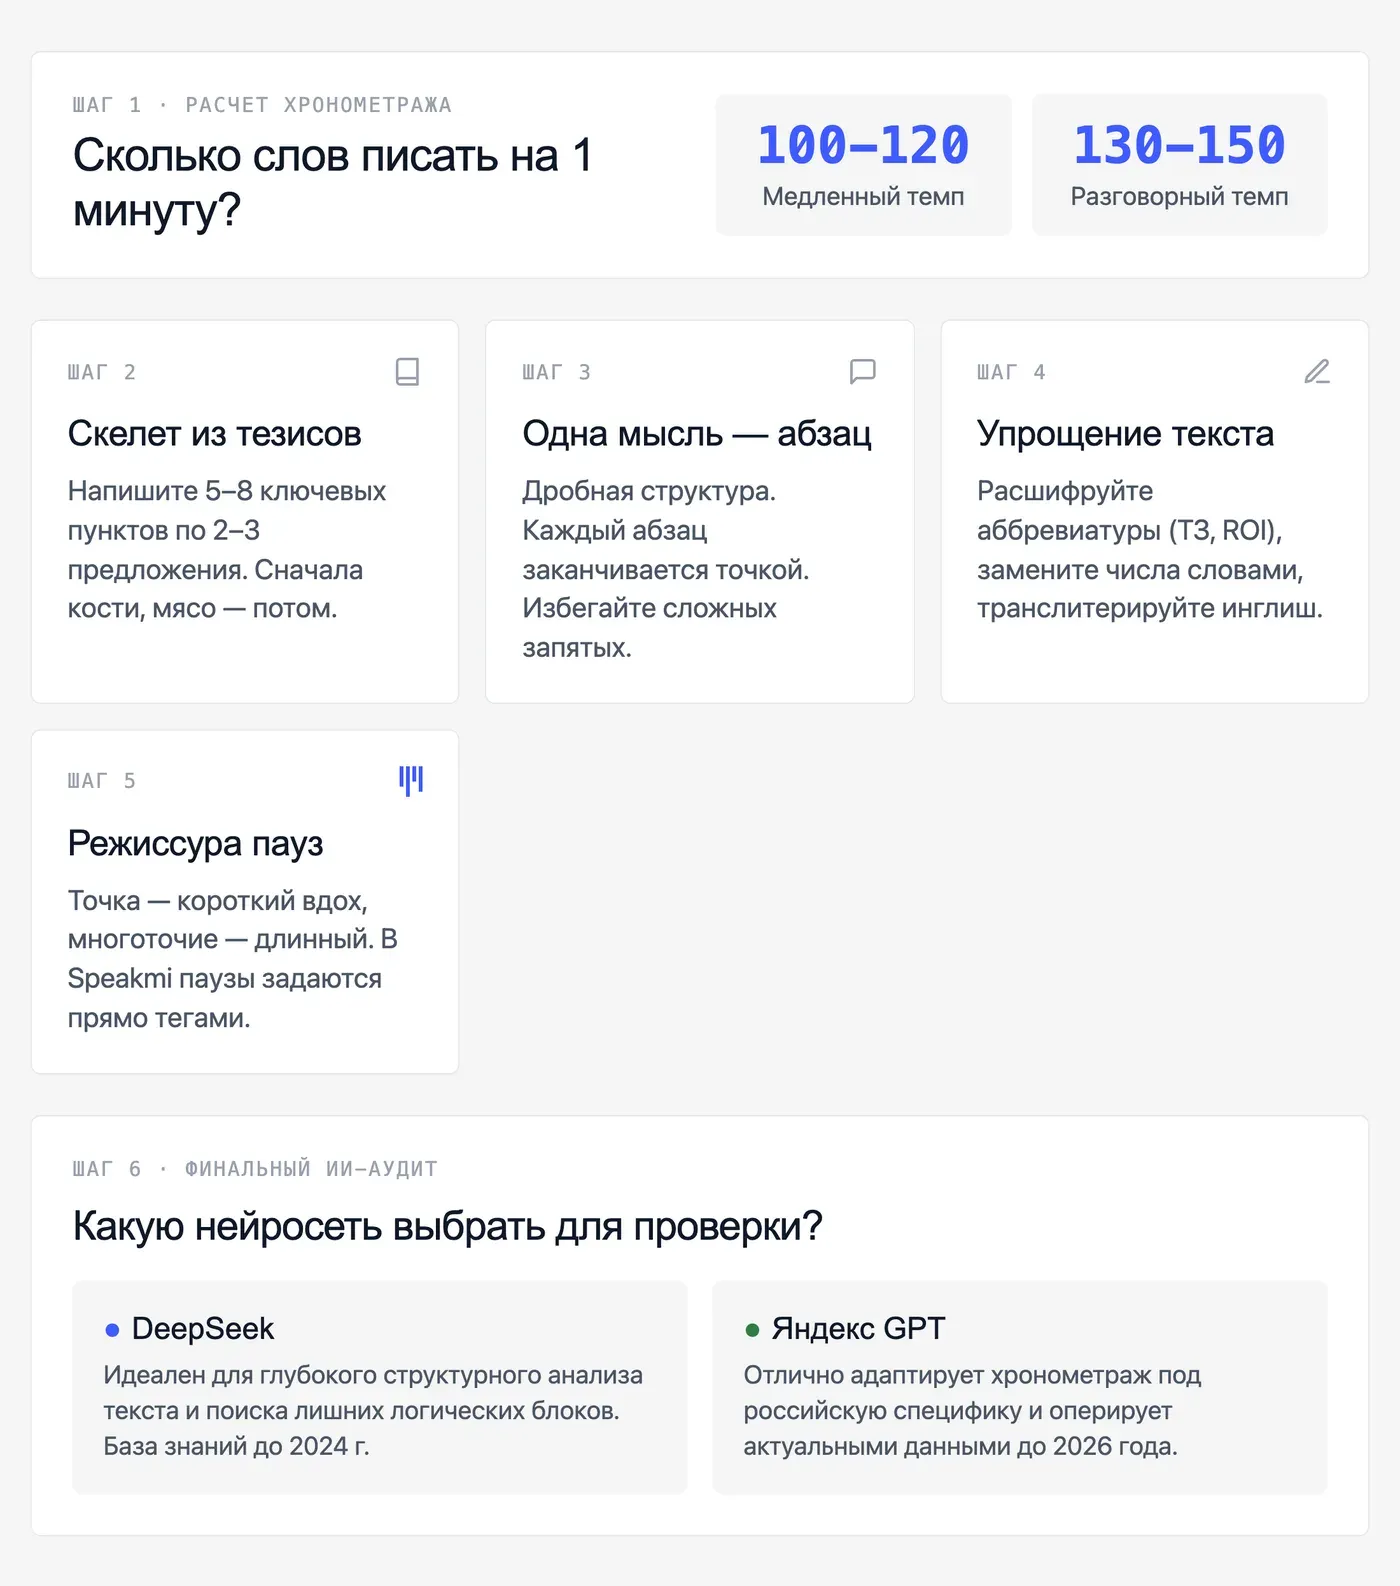
Шаг 1. Определи формат и хронометраж
Сначала — сколько секунд или минут аудио нужно на выходе. Ориентир: 1 минута озвучки ≈ 130–150 слов для разговорного темпа, 100–120 слов для медленного дикторского. Ролик на 3 минуты — это 400–450 слов текста.
Шаг 2. Напиши «кости» — скелет из тезисов
Не пиши сразу полный текст. Сначала — 5–8 пунктов, что должен услышать зритель. По 2–3 предложения на каждый. Это метод «кости и мясо»: сначала скелет, потом наращиваешь детали. Так легче держать хронометраж и не уходить в сторону.
Шаг 3. Разверни каждый тезис в абзац
Одна мысль — один абзац. Абзац заканчивается точкой, не запятой. Если мысль сложная — дели на два абзаца, не на одно длинное предложение.
Шаг 4. Проверь числа, аббревиатуры, иностранные слова
Прочитай текст вслух сам — именно так, как его прочитает голос. «ТЗ», «СЕО», «ROI» — расшифруй или убери. Числа — словами или с пояснением. Иностранные термины — транслитерацией или переводом.
Шаг 5. Расставь паузы
Точка — короткая пауза. Многоточие — длинная. Если нужна пауза внутри предложения — тире или двоеточие. В Speakmi паузы и эмоции задаются тегами прямо в тексте: не нужно ползунков и пересводить всё заново — поправил тег, перегенерировал один абзац.
Шаг 6. Прогони через DeepSeek или Яндекс GPT
Загрузи черновик и спроси прямо: «Какие блоки лишние и уводят от темы?» и «Что добавить, чтобы дотянуть хронометраж до нужной длины?». DeepSeek хорош для структурного анализа, Яндекс GPT лучше понимает российскую специфику и актуальные данные до 2026 года — у DeepSeek база ограничена 2024-м.
Какие нейросети лучше всего озвучивают сценарий на русском?
Для нового контент-мейкера главный критерий — не «самая качественная», а «работает без VPN, принимает оплату картой РФ, есть русский язык». По этому фильтру список сужается быстро.
| Сервис | Русский язык | VPN нужен | Клонирование голоса | Бесплатный уровень |
|---|---|---|---|---|
| Speakmi | Да, основной | Нет | Да (10–30 сек образца) | Первые 30 секунд бесплатно |
| CapCut | Да | Нет | Нет | Есть |
| Google AI Studio | Да (9 языков) | Нет | Нет | Есть |
| QWEN 3TTS | Да | Нет (через Google Collab) | Да | Есть (лимит 12 ч/сессия) |
| Minimax Audio | Частично | Нет | Нет | Есть |
Спикми — выбор, если нужны 970 голосов на выбор, клонирование своего голоса и работа без настройки кода. Подходит для YouTube, Reels, подкастов, курсов.
CapCut — встроенный бесплатный генератор голоса для тех, кто монтирует там же. Голосов мало, клонирования нет, но для простых задач хватает.
Google AI Studio — хорошо расставляет ударения в русском тексте, есть готовый список дикторов. Клонирования нет. Подходит, если нужен быстрый результат без регистрации.
QWEN 3TTS — новая библиотека с высоким уровнем интонаций и возможностью клонирования. Запускается через Google Collab: скачивается модель ~4 гигабайта, бесплатная сессия работает 12 часов. Подходит для тех, кто не боится поработать с кодом. Нюанс: для лучшего результата эмоции лучше прописывать на английском (например, happy, sad).
Minimax Audio — подходит для базовой озвучки на старте, когда нужно быстро услышать, как звучит текст, до финальной генерации.
Как адаптировать сценарий под ИИ-голос: что убрать, что добавить?
Три вещи, которые портят результат независимо от качества движка:
Убрать:
-
Длинные предложения с тремя придаточными. Дели на три коротких.
-
Скобки и тире внутри предложения — нейросеть делает паузу там, где не нужно.
-
Списки через запятую без союзов: «красный, синий, зелёный, жёлтый» читается слитно. Лучше: «красный, синий и зелёный».
-
Сокращения: «т.е.», «и т.д.», «пр.», «кг», «руб.» — расшифровывай или пиши словами.
Добавить:
-
Паузы через точки там, где нужна интонационная остановка.
-
Расшифровку чисел там, где важна точность произношения: «в 2026 году» → «в две тысячи двадцать шестом году».
-
Тег эмоции, если нужен акцент: в Speakmi это пишется прямо в тексте, не через отдельный интерфейс.
-
Транскрипцию иностранных слов: «YouTube» → «ЮТуб», если голос читает неправильно.
Один неочевидный приём: если клонируешь свой голос, добавь в образец ту же интонацию, которую хочешь в готовой озвучке. Спокойный ровный тон в образце — спокойная озвучка на выходе.
Как озвучить готовый сценарий через Speakmi: пошаговый гайд
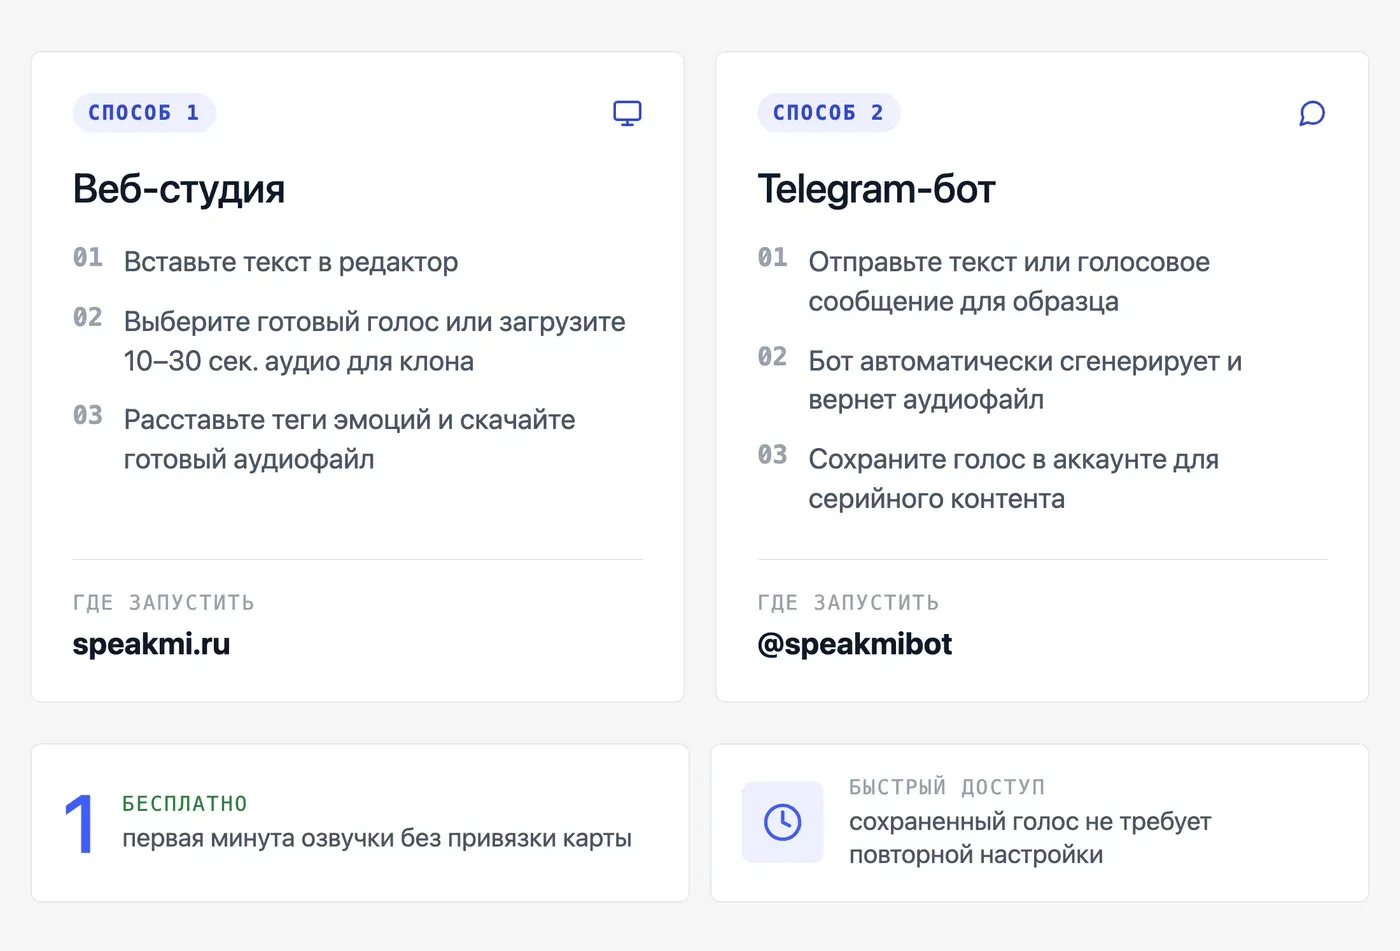
Два способа — веб-студия и Telegram-бот. Результат одинаковый, путь разный.
Через веб-студию на speakmi.ru:
-
Открой редактор, вставь подготовленный текст.
-
Выбери голос: фильтруй по полу, возрасту, манере (дикторская или разговорная), прослушай демо.
-
Если нужен свой голос — перейди в раздел «Мои голоса» / «Клонирование», отправь запись 10–30 секунд с чёткой речью и текстом-транскриптом того, что в записи. Мгновенный клон готов сразу; сохранённый голос доступен для повторного использования в любой момент.
-
Расставь теги эмоций там, где нужна интонация.
-
Нажми «Сгенерировать» — получи аудиофайл.
Через Telegram-бот @speakmibot:
-
Напиши текст в бот или отправь голосовое сообщение — оно станет образцом для клона.
-
Бот сгенерирует аудио и вернёт файл.
-
Для серийного контента — один раз сохрани голос в «Мои голоса», дальше просто вставляй новый текст на каждый выпуск.
Первые 30 секунд озвучки — бесплатно, без карты. Можно послушать свой голос на реальном тексте прежде, чем платить.
Если публикуешь регулярно — сохранённый голос экономит время: не нужно каждый раз выбирать и настраивать заново.
Какие ошибки в сценарии портят озвучку нейросетью?
Пять ошибок, которые встречаются в большинстве первых попыток:
1. Скопировали статью без адаптации. Статья написана для глаз, сценарий — для ушей. Длинные абзацы, сложные конструкции, списки через запятую — всё это даёт монотонный результат.
2. Оставили аббревиатуры. «ИИ», «ТЗ», «SEO» — нейросеть читает их по буквам или не так, как ожидаешь. Расшифровывай при первом упоминании.
3. Нет пауз между смысловыми блоками. Переход от одного тезиса к другому без паузы звучит как одна длинная фраза. Ставь точку или абзац там, где диктор сделал бы вдох.
4. Слишком длинный образец для клонирования. Оптимум — 3–10 секунд чёткой речи с транскриптом. Образец 30–40 секунд увеличивает риск артефактов в голосе.
5. Написали промпт один раз и ждут идеального результата. Озвучка нейросетью — итеративный процесс. Первый результат — черновик. Поправил тег, поправил текст, перегенерировал. Обычно 2–3 итерации дают рабочий результат.
Сколько стоит озвучить сценарий ИИ против живого диктора?
Прямое сравнение по типичному проекту — ролик 3 минуты, 400–450 слов:
| Способ | Стоимость | Время | Правки |
|---|---|---|---|
| Генерация в Speakmi | Первые 30 секунд бесплатно; далее — пакет токенов | 1–2 минуты генерации | Бесплатно, мгновенно |
| Живой диктор (фриланс) | 500–2 000 ₽ за минуту готового аудио | 1–3 дня | Платно или лимит правок |
| Агентство / студия | от 3 000 ₽ за минуту + монтаж | 3–7 дней | По договору |
Для сравнения: создание превью для YouTube у дизайнера стоит в среднем 1 000 ₽ за штуку; монтаж одного длинного ролика у монтажёра — от 10 000 ₽. Озвучка через ИИ укладывается в тот же бюджет на весь месяц контента, что один ролик у студии.
Где ИИ уступает живому диктору: сложная авторская интонация, актёрская игра, нестандартный речевой темп. Где выигрывает: скорость, стоимость правок, возможность переозвучить один абзац без пересъёмки всего.
Цены на услуги дикторов — данные на сентябрь 2026 года, фриланс-рынок.
Частые вопросы
- Как написать сценарий для озвучки видео с нуля?
- Определи хронометраж: 1 минута ≈ 130–150 слов. Напиши 5–8 тезисов по 2–3 предложения — это скелет. Разверни каждый тезис в короткий абзац. Расшифруй все числа и аббревиатуры. Расставь паузы через точки. Прогони через DeepSeek или Яндекс GPT, чтобы убрать лишнее и проверить хронометраж. Итого — 20–30 минут на текст для ролика 3 минуты.
- Какой длины должен быть сценарий для 1 минуты озвучки?
- 130–150 слов для разговорного темпа, 100–120 слов для медленного дикторского. Если сценарий на 3 минуты — 400–450 слов. Это ориентир: конкретный голос и темп могут немного смещать цифру, поэтому после первой генерации сверяй хронометраж и корректируй объём.
- Можно ли озвучить сценарий нейросетью бесплатно?
- Да. В Спикми первые 30 секунд бесплатно — без карты и регистрации через платёжную систему. Google AI Studio и CapCut тоже дают бесплатный доступ к готовым голосам. QWEN 3TTS через Google Collab работает бесплатно до 12 часов в сессии — потом нужно дать системе отдохнуть несколько часов, и лимит возобновляется.
- Какая нейросеть лучше всего озвучивает русский текст?
- Зависит от задачи. Speakmi — 970 голосов, клонирование, работа без VPN, оплата картой РФ, подходит для серийного контента. Google AI Studio — хорошо расставляет ударения, не требует настройки, но голосов мало. QWEN 3TTS — высокое качество интонаций и клонирование, но нужно запускать через Google Collab. CapCut — подходит, если монтируешь там же и нужна базовая озвучка без лишних шагов.
- Как расставить паузы и интонации в тексте для ИИ-озвучки?
- Точка — короткая пауза. Многоточие — длинная. Тире или двоеточие — пауза внутри предложения. В Спикми эмоции задаются тегами прямо в тексте: пишешь тег в нужном месте, перегенерируешь один абзац — не нужно пересводить всё. В QWEN 3TTS эмоции лучше прописывать на английском: happy, sad, whisper — модель реагирует точнее.
- Чем сценарий для YouTube отличается от сценария для рекламного ролика?
- YouTube-сценарий строится на удержании: первые 15 секунд — крючок, дальше — нарастающий интерес, вывод в конце. Оптимальная длина — 10–20 минут для экспертного формата, 3–5 минут для обучающего. Рекламный ролик — 30–60 секунд, структура «проблема → решение → призыв», каждое слово стоит денег. В рекламе паузы короче, темп выше, текст плотнее.
- Сколько символов помещается в одну минуту озвучки?
- Примерно 700–900 символов с пробелами для разговорного темпа. Для дикторского — 600–750 символов. Точная цифра зависит от голоса и темпа: после первой генерации посмотри хронометраж файла и скорректируй объём текста пропорционально.
- Можно ли озвучивать большие тексты нейросетью?
- Да. Speakmi и большинство сервисов генерации принимают длинные тексты — ограничения зависят от пакета. Для больших проектов (аудиокниги, курсы) удобнее делить текст на главы или разделы и генерировать отдельными файлами: так легче переозвучить один фрагмент без пересъёмки всего.