Скачать ИИ-голос: как получить готовый MP3 с нужным голосом
Как получить аудиофайл с ИИ-голосом: выбрать голос, записать текст нейросетью и скачать MP3. Форматы, ограничения бесплатных сервисов и пошаговая инструкция.
Что значит «скачать ИИ-голос»: файл с записью или модель голоса
«Скачать ИИ-голос» — это почти всегда одно и то же: сгенерировать аудиодорожку из текста и сохранить её как MP3 или WAV. Готовый файл — и есть то, что большинство людей ищут под этим запросом.
Скачать саму модель голоса (её веса, нейронную сеть целиком) — другая история. Это доступно только через open-source инструменты вроде локально запускаемых TTS-моделей, требует технических знаний и мощного компьютера. Ни один обычный веб-сервис — включая Speakmi — модель в виде файла не отдаёт. Это не недостаток, просто другой продукт.
Поэтому дальше разбираем первый сценарий: выбираешь голос в сервисе, вводишь текст, получаешь аудиофайл.
Какие форматы ИИ-голоса можно получить: MP3, WAV и голосовое сообщение
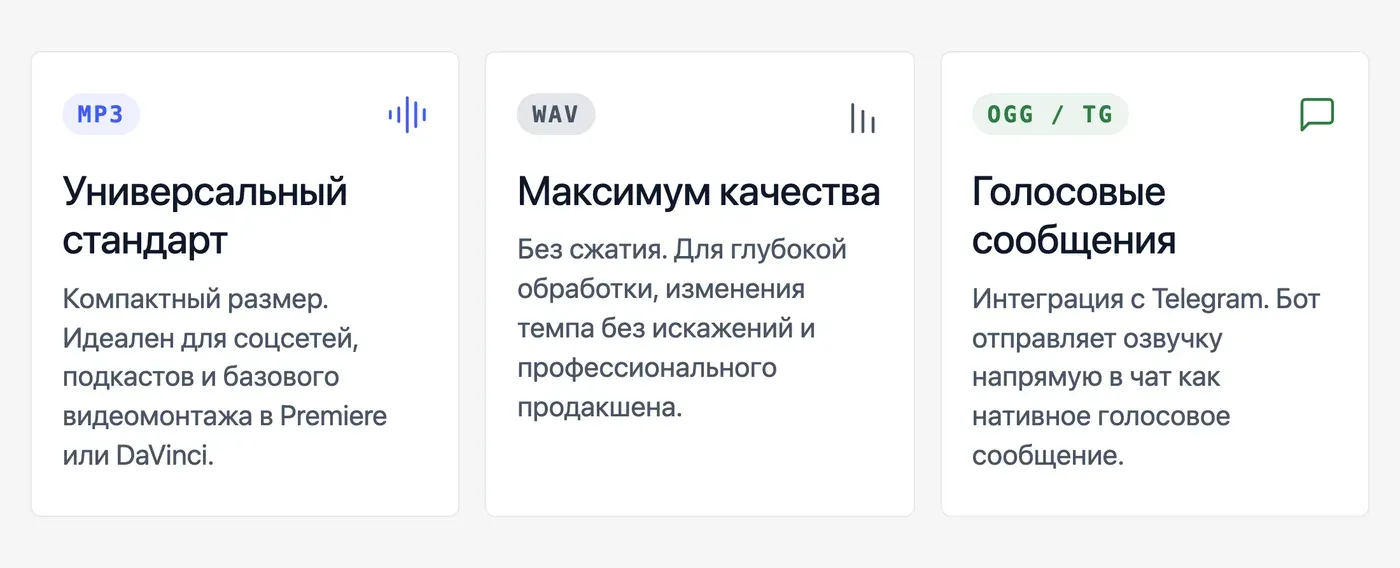
Формат зависит от задачи. Вот три основных варианта и когда каждый нужен:
-
MP3 — универсальный формат для большинства задач: видеомонтаж в Premiere Pro или DaVinci, подкасты, публикация в соцсетях. Файл небольшой, воспроизводится везде. Speakmi отдаёт именно MP3.
-
WAV — несжатый формат, нужен для профессионального монтажа, когда важно сохранить исходное качество без потерь. Файл в 5–10 раз тяжелее MP3 при том же хронометраже. Если планируешь обрабатывать дорожку в Adobe Audition или изменять темп — WAV предпочтительнее: изменение скорости MP3-файла напрямую в Premiere даёт роботизированный звук, а в WAV через Audacity эффект «Изменить темп» работает чисто.
-
OGG / голосовое сообщение — формат для Telegram. Если нужно отправить готовую нейроозвучку как голосовое в мессенджере, бот Speakmi (@speakmibot) отправит файл прямо в чат в нужном формате.
Если нужен скачать голос робота MP3 для нестандартного персонажа — в каталоге Спикми есть голоса с характерным звучанием, подходящим для игровых или анимационных проектов.
Как записать текст голосом ИИ онлайн: пошаговая инструкция
Путь от текста до скачанного файла занимает 3–5 минут при первом использовании, меньше минуты — при повторном.
-
Открой сервис. Зайди на speakmi.ru или открой Telegram-бот speakmibot. Регистрация нужна для веб-студии, в боте достаточно нажать «Старт».
-
Вставь текст. Не стоит генерировать весь длинный текст за один раз — первые 2–3 минуты звучат хорошо, дальше качество падает. Лучше делить на смысловые куски по 500–800 символов.
-
Выбери голос. В каталоге Speakmi 914 голосов (на ноябрь 2026). Фильтруй по полу, возрасту и манере (дикторская или разговорная), прослушивай демо. Понравившийся сохрани в «Мои голоса» — дальше он будет одним кликом.
-
Выбери модель — ровная S2.1 Pro или эмоциональная Drama 3. Подробнее о разнице — в разделе ниже.
-
Нажми «Сгенерировать». Короткий текст озвучивается за 1,5–3 секунды на Drama 3, 4–5 секунд на S2.1 Pro.
-
Прослушай и скачай MP3. Если интонация не та — просто запусти новую генерацию: поправить одно слово в готовой записи нельзя, файл переделывается целиком.
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Как скачать ИИ-голос в Speakmi: пошаговая инструкция
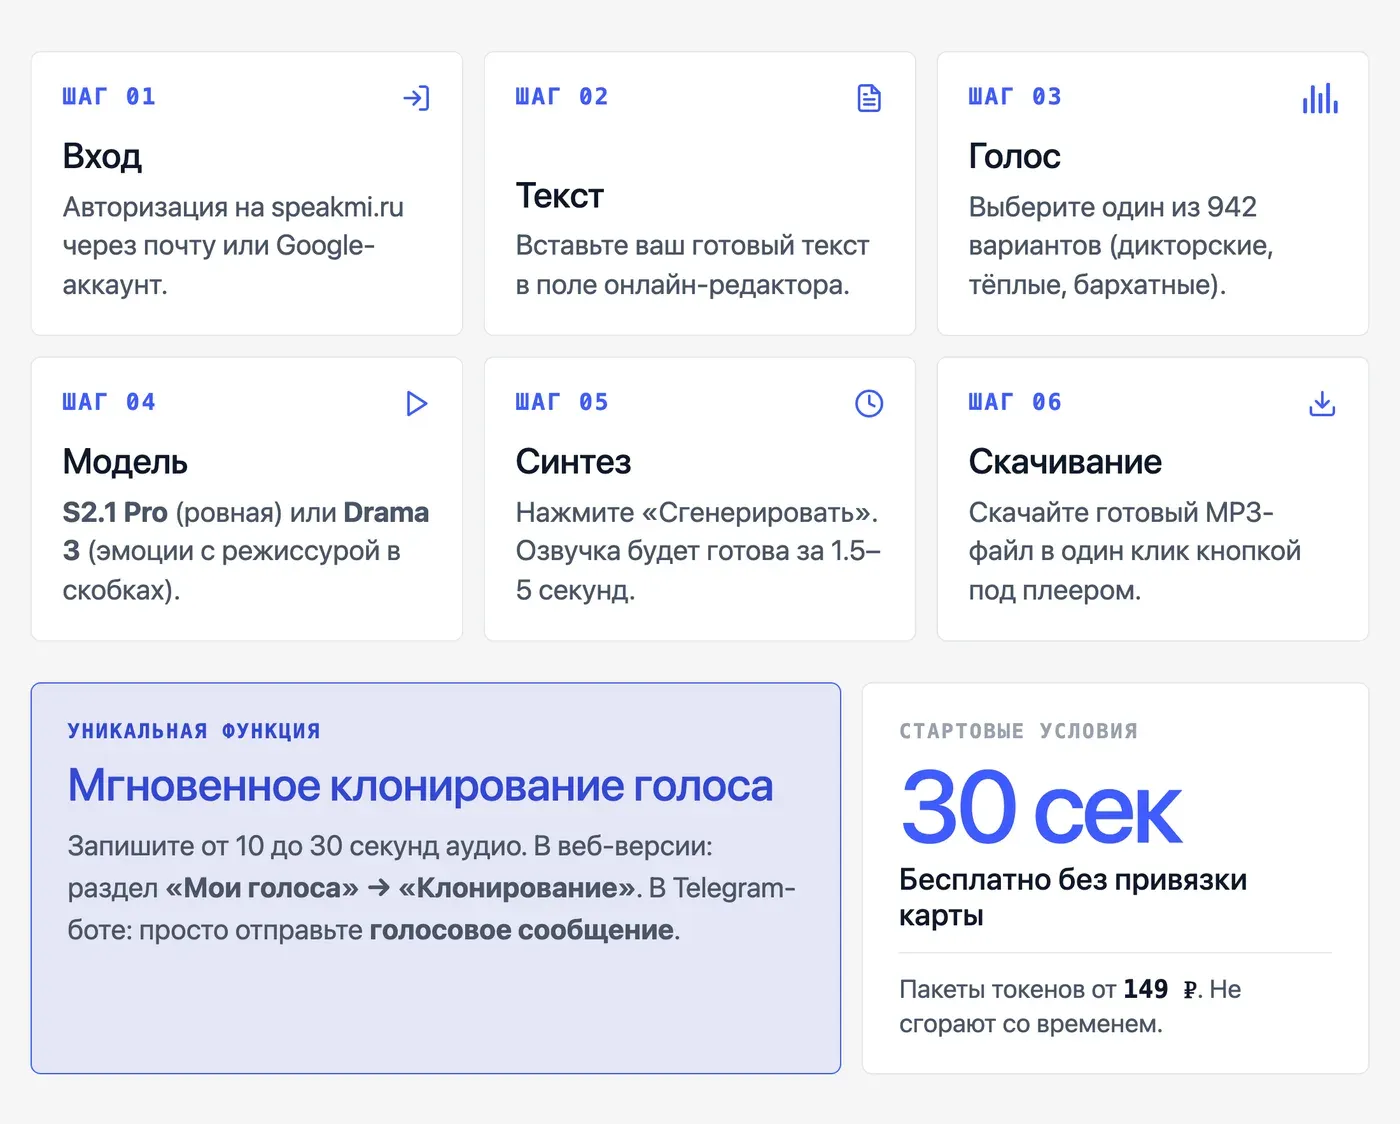
Speakmi — сервис ИИ-озвучки текста и клонирования голоса на русском (веб-студия и Telegram-бот): вставляешь текст, выбираешь голос и модель, генерируешь и скачиваешь MP3, первые 30 секунд бесплатно без карты.
-
Зарегистрируйся на speakmi.ru — почта или Google-аккаунт.
-
Вставь текст в редактор.
-
Выбери голос из каталога — 914 вариантов: дикторские («Новостной диктор», «Телевизионный диктор»), тёплые («Тёплый женский»), низкие («Низкий мужской», «Бархатный мужской»). Прослушай демо, сохрани в «Мои голоса».
-
Выбери модель: S2.1 Pro — ровная, Drama 3 — эмоциональная с режиссурой в квадратных скобках (
[едва сдерживая смех] Это невероятно). -
Нажми «Сгенерировать» — дорожка готова за 1,5–5 секунд.
-
Скачай MP3 кнопкой под плеером.
Хочешь озвучивать контент своим голосом — клонирование работает из записи 10–30 секунд: в веб-студии это раздел «Мои голоса» → «Клонирование», в Telegram-боте достаточно отправить голосовое сообщение. Пакеты токенов начинаются от 149 ₽ и не сгорают. Speakmi озвучивает текст и клонирует голос; приложения для практики английского с похожим названием — другой продукт.
Бесплатно скачать ИИ-голос: что реально доступно без оплаты
Бесплатная озвучка есть у большинства TTS-сервисов, но с ограничениями — и они сильно различаются:
-
Лимит длины — самое частое ограничение. ERA2 Voice даёт 300 символов без карты, Speakmi — 30 секунд готового аудио. Для пробы хватает, для реального ролика — нет.
-
Водяной знак — часть сервисов добавляет голосовой или звуковой водяной знак в бесплатные файлы. Такой MP3 нельзя использовать в публичном контенте.
-
Ограниченный каталог — на бесплатном уровне бывает доступно 5–10 голосов из сотен. Нужный под задачу может оказаться за платным барьером.
-
Требование регистрации — у части сервисов даже пробная генерация требует создать аккаунт и подтвердить почту.
Speakmi на бесплатном уровне: 30 секунд, без карты, все 914 голосов доступны для прослушивания демо, скачать можно результат до 30 секунд без водяного знака. Озвучка голосом персонажей бесплатно — без регистрации через Telegram-бот.
Запись своим голосом остаётся лучшим вариантом, если тебе нужен живой эфир в реальном времени или импровизация. Для всего остального — нейроозвучка сэкономит время: вместо настройки студии, ожидания тишины и нескольких дублей получаешь дорожку за несколько секунд.
Первые 30 секунд озвучки — бесплатно, без карты: можно послушать свой голос на реальном тексте прежде, чем платить.
Ровный или эмоциональный голос: какую модель выбрать под задачу
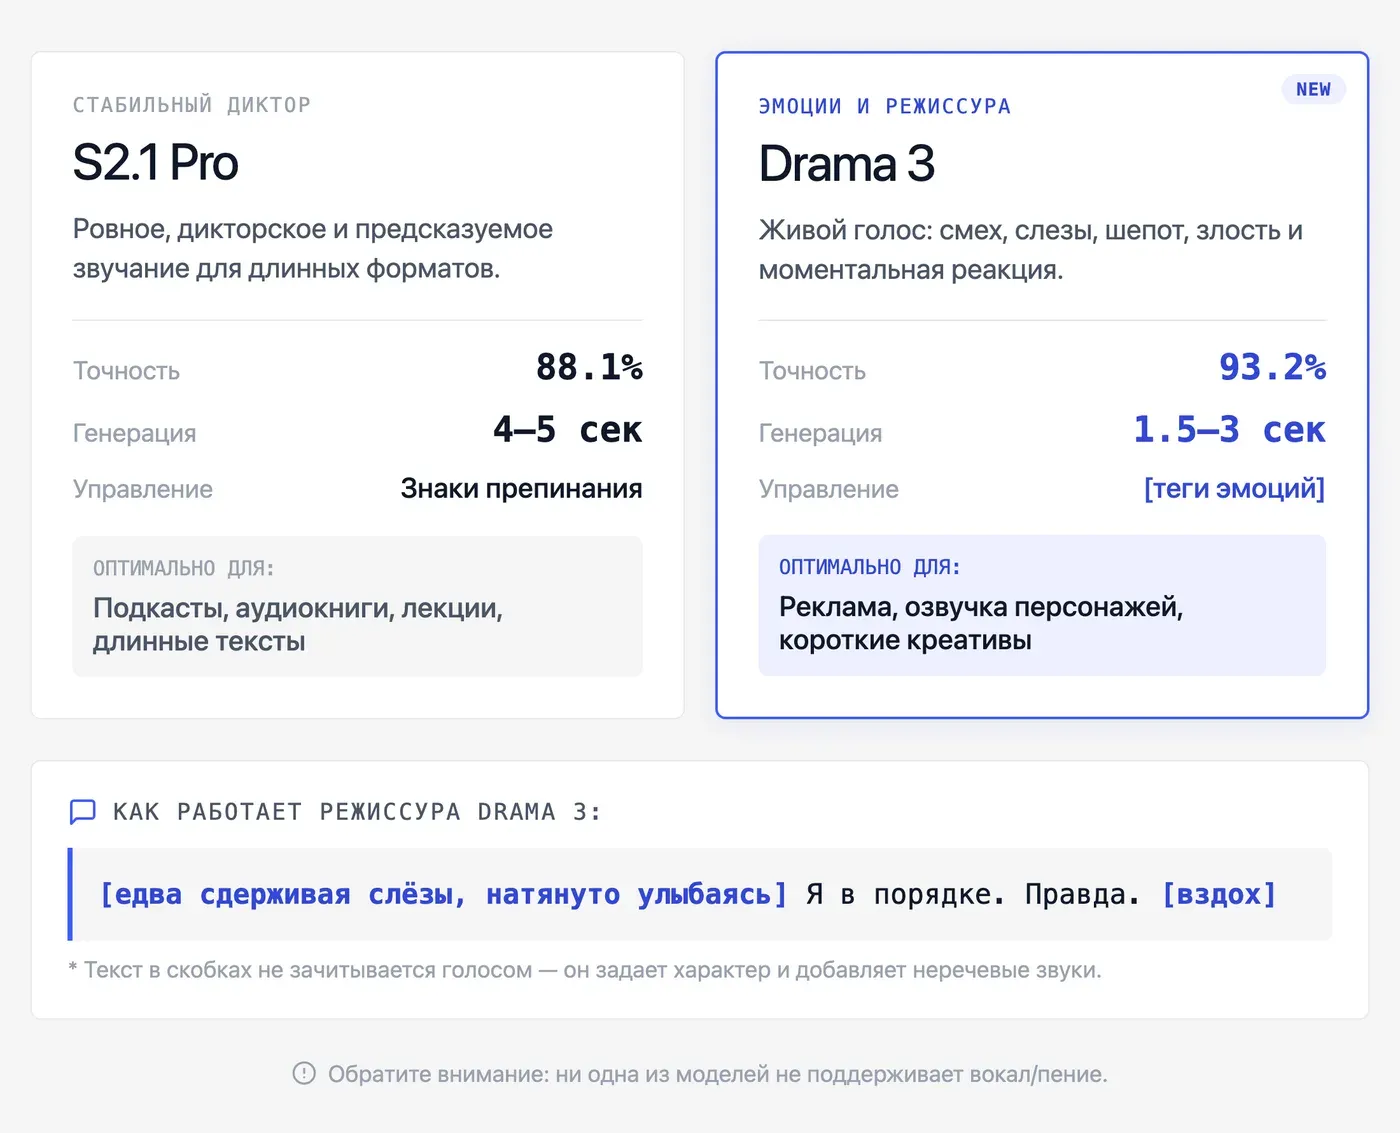
В Спикми две модели генерации речи (не путать с генерацияом): S2.1 Pro и Drama 3 (Fish Audio, в Speakmi с 14.10.2026). Вот честное сравнение по одинаковым критериям:
| Критерий | S2.1 Pro | Drama 3 |
|---|---|---|
| Звучание | Ровное, дикторское, стабильное | Эмоциональное: плачет, злится, смеётся, шепчет |
| Управление эмоциями | Знаки препинания, капслок на акцентах | Режиссура в [квадратных скобках] • метки на словах |
| Стабильность дублей | Высокая — дубли похожи друг на друга | Дубли сильнее отличаются; неудачный просто переделывают |
| Точность сложных слов | 88,1% (тест Artificial Analysis) | 93,2% (тест Artificial Analysis) |
| Скорость генерации | 4–5 с на короткой фразе | 1,5–3 с на короткой фразе |
| Подходит для | Длинные тексты, дикторская озвучка, подкасты, обучающие видео | Короткие ролики, персонажи, сценки, реклама, аудиоспектакли |
| Цена (на октябрь 2026) | Стандартная | До 12 ноября 2026 — как обычная озвучка |
Режиссура в Drama 3 работает просто: перед фразой в квадратных скобках пишешь, как её сыграть — [едва сдерживая слёзы, натянуто улыбаясь] Я в порядке. Правда. Пометки вслух не читаются, только меняют подачу. Звуки ставишь туда, где они должны прозвучать: [вздох], [тихий смешок]. Включается переключателем модели в редакторе или кнопкой «🎭 Модель» в Telegram-боте.
Пение ни одна из моделей не поддерживает.
Почему скачанный ИИ-голос звучит не так, как ожидалось: частые проблемы
Разочарование от результата почти всегда объясняется одной из трёх причин — и каждую можно исправить до скачивания.
-
Монотонность. Стандартная модель (S2.1 Pro) читает ровно — это её суть, а не баг. Для эмоционального контента переключайся на Drama 3 и добавляй режиссуру в квадратных скобках. Ещё быстрый приём: расставь знаки препинания, пиши важные слова КАПСОМ для акцента, добавь троеточие там, где нужна пауза с сомнением.
-
Неправильные ударения. Нейросеть иногда ошибается на редких словах или именах. Решение: написать слово так, как оно должно звучать фонетически, или расставить дефисы для управления паузами. В некоторых сервисах есть таблица произношения — туда вписываешь слово и его транскрипцию.
-
Нестабильность между дублями. Это известная особенность эмоциональных моделей — Google AI Studio с Gemini и Drama 3 ведут себя похоже: при тех же настройках каждый новый дубль звучит немного иначе. Решение, которое используют опытные контент-мейкеры: генерировать текст небольшими кусками по несколько предложений, выбирать лучший дубль каждого куска и склеивать дорожку на монтаже. Это убирает монотонность и делает речь живее.
-
Короткий файл на бесплатном тарифе. Если сгенерировал 60 секунд, а скачалось 30 — это лимит бесплатного уровня, не ошибка сервиса.
Если звук всё равно кажется «глухим» после скачивания — попробуй добавить лёгкую реверберацию или едва заметный фоновый шум в редакторе: это убирает ощущение записи в вакууме. Для изменения темпа без искажений: импортируй WAV в Audacity, примени «Изменить темп» (без сохранения высоты тона не трогай), экспортируй обратно. Изменить голос онлайн нейросетью — отдельная тема, если нужна постобработка.
Частые вопросы
- Что такое Speakmi?
- Speakmi — сервис ИИ-озвучки текста и клонирования голоса на русском, работает как веб-студия на speakmi.ru и Telegram-бот @speakmibot. Движок — Fish Audio. Новым пользователям 30 секунд бесплатно без карты; пакеты токенов от 149 ₽, не сгорают. Распознавания речи и публичного API у Speakmi нет.
- Можно ли скачать ИИ-голос бесплатно без регистрации?
- Через Telegram-бот speakmibot — да: нажимаешь «Старт», отправляешь текст, получаешь MP3 без создания аккаунта. Лимит — 30 секунд готового аудио. Для более длинных файлов нужна регистрация на сайте и пакет токенов от 149 ₽.
- В каком формате скачивается аудиофайл — MP3 или WAV?
- Speakmi отдаёт MP3. Для большинства задач — видеомонтаж, подкасты, соцсети — этого достаточно. Если нужен WAV для профессиональной постобработки без потерь, скачай MP3 и конвертируй в Audacity (бесплатно): качество исходной генерации при этом не ухудшится.
- Можно ли скачать голос конкретного персонажа или знаменитости?
- В каталоге Speakmi 914 голосов (на ноябрь 2026), среди них есть узнаваемые. Клонировать чужой голос без согласия правообладателя нельзя — ни технически через Спикми, ни юридически: это нарушение в большинстве стран СНГ. Клонирование работает только для своего голоса или с подтверждёнными правами.
- Как скачать ИИ-голос для игры или видеомонтажа?
- Для игры нужен WAV или MP3 без водяного знака — Speakmi даёт чистый MP3 уже на бесплатном уровне (до 30 секунд). Для монтажа: генерируй кусками по 500–800 символов, скачивай каждый отдельно, склеивай в редакторе. Если темп нужно поменять — делай это через Audacity эффектом «Изменить темп», не напрямую в Premiere: иначе голос звучит роботизированно.
- Можно ли отредактировать одно слово в готовой записи?
- Нет — ни в Speakmi, ни в большинстве TTS-сервисов. Правка одного слова означает новую генерацию всего фрагмента. Поэтому удобнее делить текст на короткие смысловые куски: переделать один абзац быстро, а переделывать пятиминутный монолог из-за одной ошибки — нет.
- Сколько текста можно озвучить и скачать бесплатно?
- В Speakmi — 30 секунд готового аудио без карты. ERA2 Voice даёт 300 символов (около 20–25 секунд речи) без регистрации. Luvvoice позиционирует себя как бесплатный инструмент без лимита, но качество на русском стоит проверять отдельно — движки у сервисов разные, и не все одинаково хорошо справляются с русским текстом.