Текст в голос: превратить написанное в аудио за минуту
Как преобразовать текст в голос онлайн на русском: выбор модели, подготовка текста, скачивание MP3. Спикми (Speakmi) — 30 секунд бесплатно, без карты.
Если микрофона под рукой нет, а ролик нужен сегодня — заходишь в Speakmi, вставляешь текст, выбираешь голос из каталога и получаешь дорожку за секунды на короткий текст.
Что значит «текст в голос»: как работает генерация речи за кадром
TTS (text-to-speech, начитка текста голосом) — технология, при которой нейросеть анализирует текст, расставляет ударения, определяет интонационные границы и генерирует аудиоволну. На выходе — файл MP3 или WAV, который звучит как человеческая речь.
Процесс внутри делится на три шага: сначала модель разбирает текст на фонемы (это минимальные звуки речи, вроде «б», «о», «т»), потом строит интонационный контур, потом генерирует аудио по голосовой модели. Именно на первых двух шагах ломаются дешёвые движки: они не умеют ставить ударение в зависимости от контекста («за́мок» против «замо́к»), плохо справляются с числами, аббревиатурами и именами.
Качество результата определяет движок, а не только голос. Speakmi работает на базе Fish Audio — одном из немногих движков с нативной поддержкой русской фонетики. Это и объясняет, почему каталог в 914 голосов звучит иначе, чем похожие по объёму каталоги у сервисов на движках, заточенных под английский.
Какую модель выбрать под твою задачу?
В Спикми доступны две модели. Выбор зависит от задачи: одни сценарии требуют ровной дикторской подачи, другие — живой эмоции.
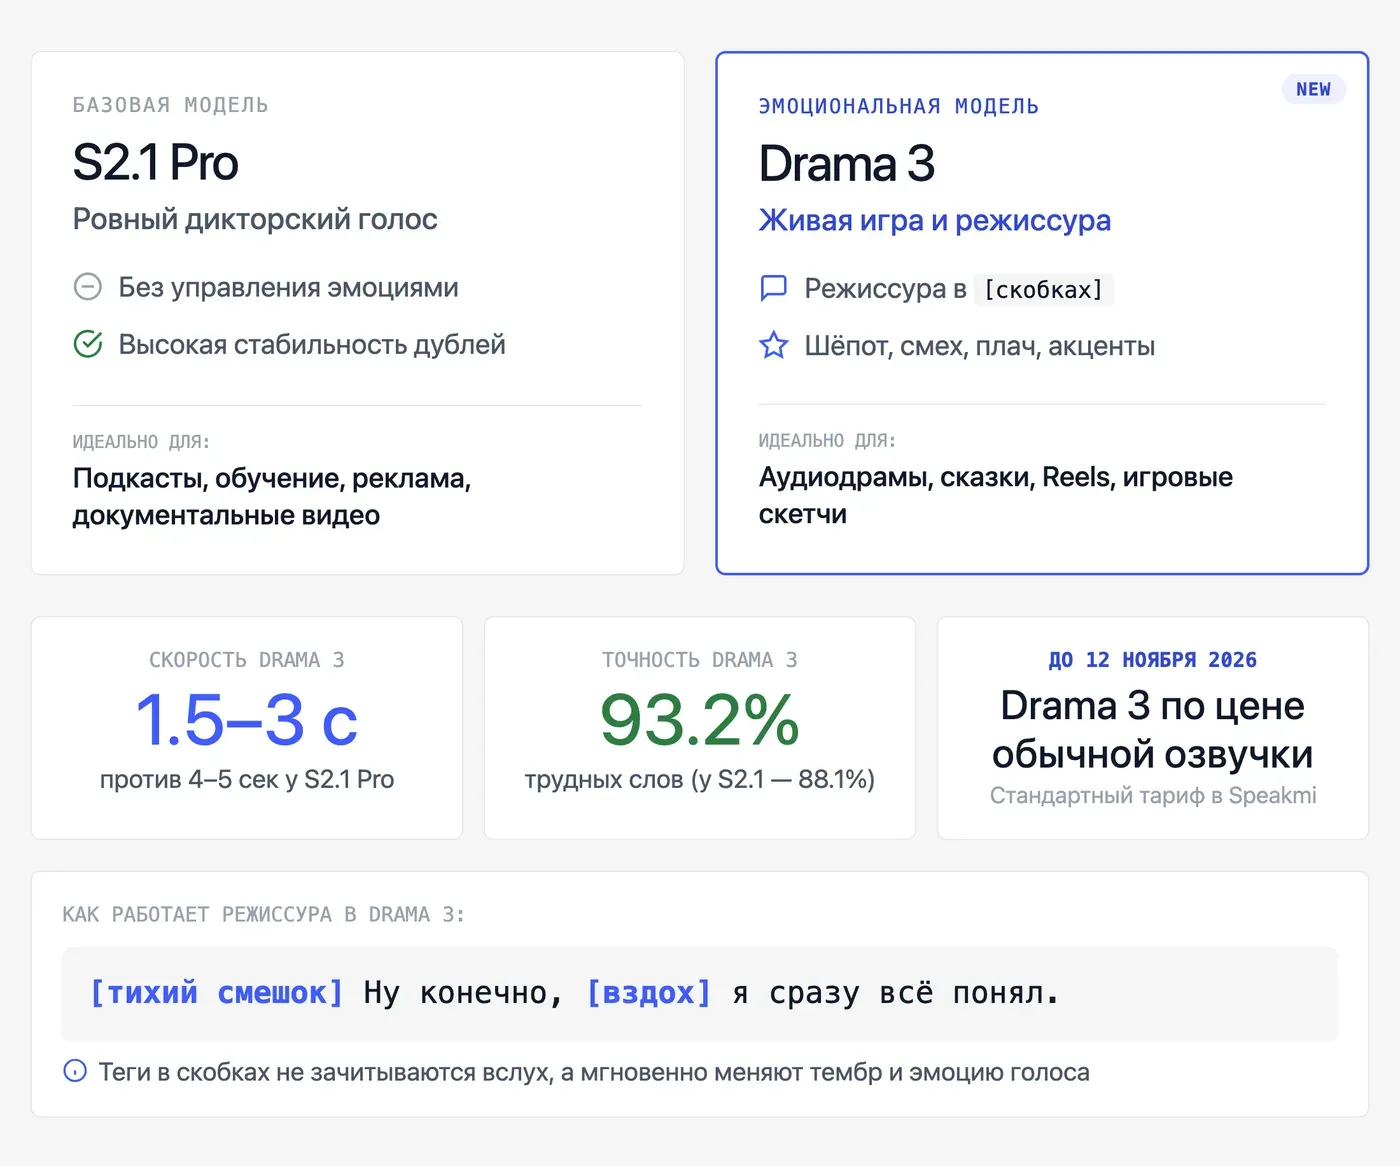
| Критерий | S2.1 Pro | Drama 3 |
|---|---|---|
| Подача | Ровная, дикторская | Эмоциональная: плачет, злится, смеётся, шепчет |
| Управление подачей | Нет отдельных инструментов | Режиссура в [квадратных скобках]: [едва сдерживая слёзы] Я в порядке. |
| Метки на словах | — | Шёпот, акцент, мягко, медленнее, с нажимом — только для выделенного куска |
| Точность трудных слов | 88,1% (Artificial Analysis) | 93,2% (Artificial Analysis) |
| Скорость на короткой фразе | 4–5 с | 1,5–3 с (наш замер) |
| Стабильность дублей | Высокая | Дубли заметно отличаются друг от друга — неудачный просто переделывают |
| Цена (на октябрь 2026) | Стандартная | До 12 ноября 2026 — как обычная озвучка |
| Лучшие сценарии | Подкаст, обучающее видео, реклама, документалка | Аудиодрама, сказка, рекламный скетч, Reels с характером |
Drama 3 вышла 13 октября 2026 года от Fish Audio и появилась в Speakmi на следующий день. Режиссура работает просто: перед фразой в квадратных скобках пишешь, как её сыграть — [вздох], [тихий смешок], [дрожащий вдох]. Эти пометки вслух не читаются, они меняют подачу только с этого места.
Подробнее о том, как управлять эмоциями и паузами через пометки — в статье про эмоциональную озвучку в Drama 3.
Как подготовить текст перед озвучкой: паузы, ударения и длина фрагмента
Нельзя поправить одно слово в готовой записи — только новая генерация целиком. Поэтому текст лучше проверить до нажатия кнопки. Вот порядок действий:
-
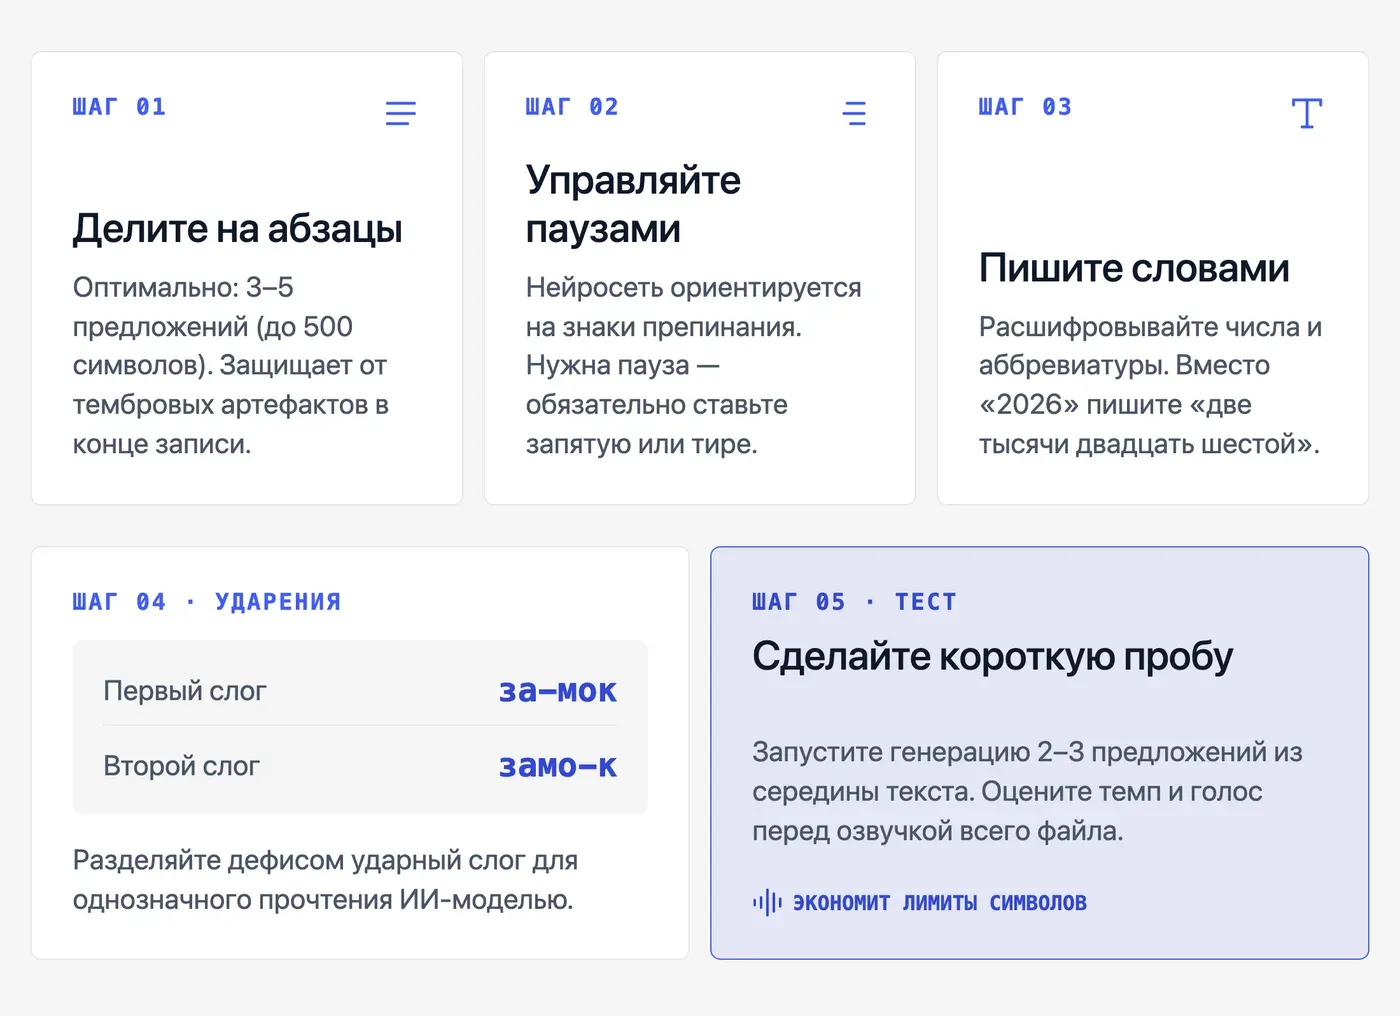
Разбейте текст на абзацы. Один абзац — одна мысль, примерно 3–5 предложений. Слишком длинный фрагмент (более 500–700 символов) иногда даёт артефакты ближе к концу: пользователи замечали, что Google-движки «к концу длинной речи вносят в тембр высокочастотные артефакты» — у Fish Audio это редкость, но абзацный подход всё равно надёжнее.
-
Расставьте запятые там, где нужна пауза. Нейросеть делает паузы по знакам препинания. Нет запятой — нет паузы. Если предложение сложное, а пауза важна — поставьте запятую или тире.
-
Проверьте аббревиатуры и числа. «ООО», «РФ», «2026» — модель читает их по-разному в зависимости от контекста. Если хотите предсказуемый результат — напишите словами: «общество с ограниченной ответственностью», «Российская Федерация», «две тысячи двадцать шестой».
-
Укажите ударение через дефис, если слово неоднозначное. Формат:
за-мок(ударение на первый слог) илизамо-к(на второй). Это работает в большинстве TTS-сервисов с русской поддержкой, включая Speakmi. Пользователи в комментариях к обзорам называют неправильные ударения главной болью — проверяйте заранее. -
Первая проба — на коротком фрагменте. Возьмите 2–3 предложения из середины текста, послушайте, как звучит голос и темп. Если устраивает — озвучивайте целиком.
Как преобразовать текст в голос в Speakmi: пошаговая инструкция
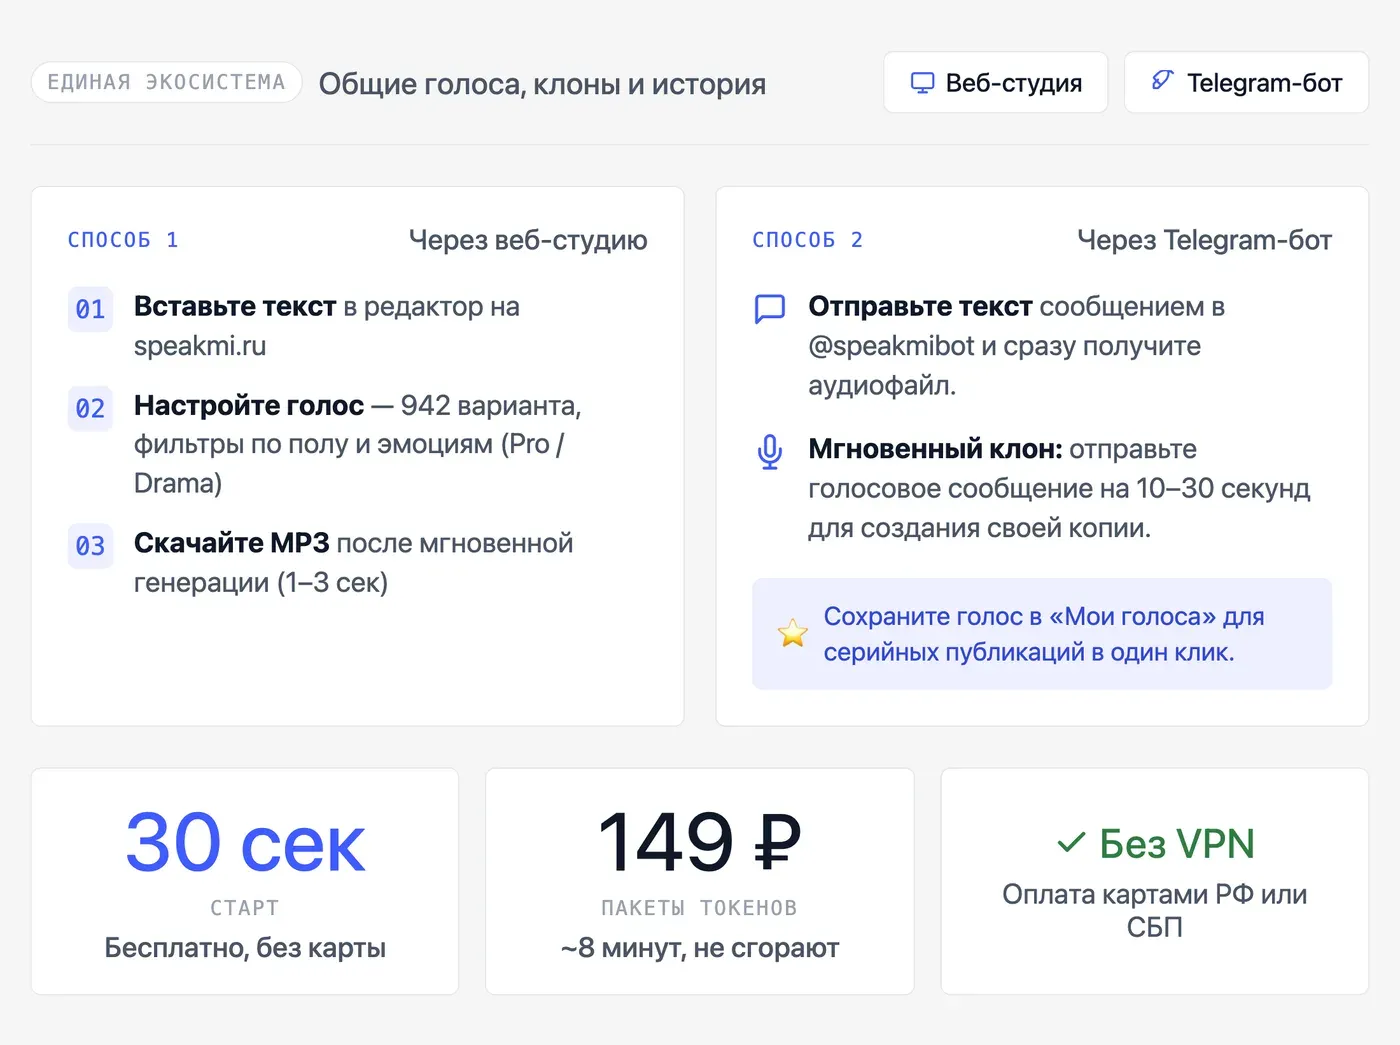
Два входа на одну базу: веб-студия на speakmi.ru и Telegram-бот. Голоса, клоны и история генераций — общие.
Через веб-студию:
-
Зайдите на speakmi.ru — регистрация занимает меньше минуты, карта не нужна.
-
Нажмите «Создать» → «Озвучка».
-
Вставьте подготовленный текст в поле редактора.
-
Выберите голос из каталога (914 голосов на ноябрь 2026): фильтруйте по полу, возрасту, манере — дикторская или разговорная. Прослушайте демо, сохраните понравившийся в «Мои голоса».
-
Выберите модель: S2.1 Pro для ровной подачи или Drama 3 для эмоций.
-
Нажмите «Сгенерировать». Короткая фраза появляется за 1–3 секунды.
-
Прослушайте результат. Если что-то не так — поправьте текст и сгенерируйте заново (одно слово поправить нельзя, только весь фрагмент).
-
Скачайте MP3.
Через Telegram-бот:
Откройте @speakmibot, отправьте текстовое сообщение — бот вернёт аудио. Клонировать свой голос можно прямо там: просто отправьте голосовое сообщение длиной 10–30 секунд, и мгновенный клон готов.
Первые 30 секунд озвучки — бесплатно, без карты. Платные пакеты токенов — от 149 ₽ (около 8 минут озвучки), токены не сгорают. Оплата картой РФ или СБП, без VPN.
Если публикуешь сериями — один раз сохраняешь голос в «Мои голоса» и дальше просто вставляешь новый текст на каждый выпуск, без повторной записи.
Текст в голос бесплатно: что реально доступно без оплаты
Бесплатный доступ у большинства TTS-сервисов ограничен. Вот реальные условия:
-
Speakmi — 30 секунд новым пользователям, без карты. Это примерно 4–5 коротких предложений. Хватает, чтобы проверить голос на реальном тексте прежде, чем платить.
-
Типичный зарубежный сервис — 300–500 символов в день (ERA2 Voice, Freepik) или 2 000 символов без лимита по времени (Speechma). На русском у большинства зарубежных сервисов 1–2 голоса, остальные — английские.
-
Сервисы с большими бесплатными лимитами (например, Speechma — около 2 минут аудио бесплатно) часто компенсируют это качеством: в обзорах пишут, что «в Clipchamp и TTS Maker голоса слишком роботизированные, качество так себе, изменением тона и темпа это не исправить».
Что стоит учитывать: бесплатный лимит у Speakmi не возобновляется — это разовый порог для новых пользователей. Дальше — пакеты токенов от 149 ₽, которые не сгорают. Для книги или длинного курса бесплатного порога ни у одного сервиса не хватит — это честно.
Подробный разбор условий — в статье про бесплатные тарифы ИИ-озвучки.
Частые проблемы при озвучке текста: почему голос звучит неестественно
Большинство проблем решаются правкой текста перед генерацией, а не после.
-
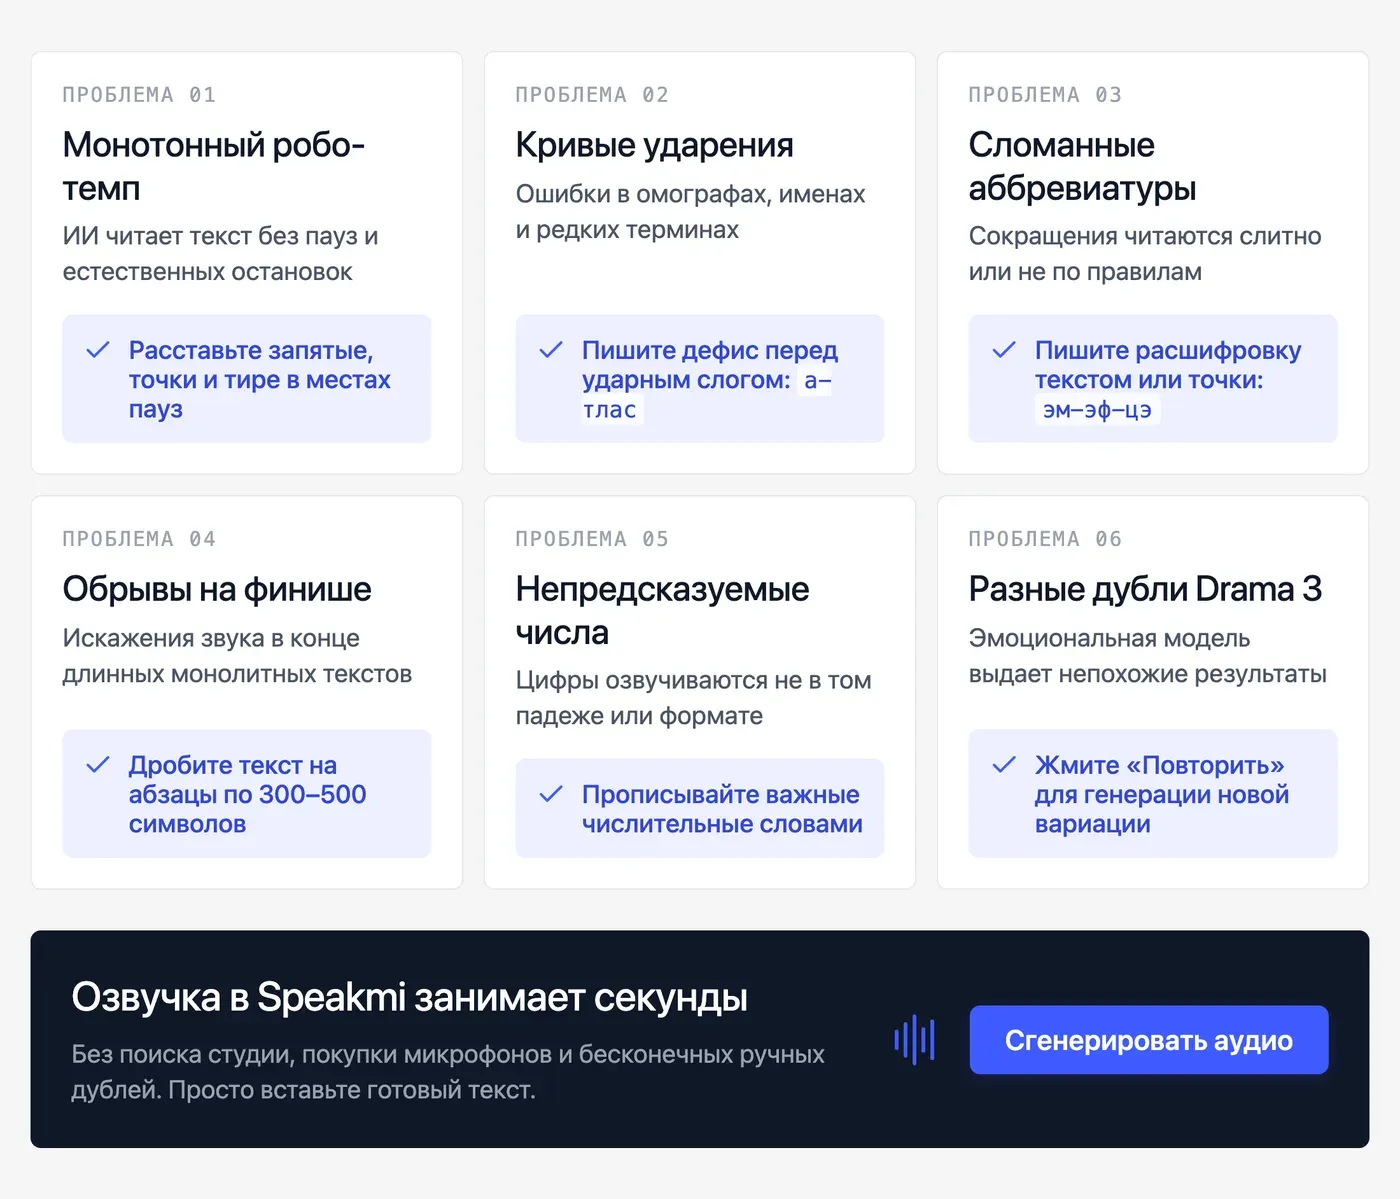
Монотонность без пауз. Причина: нет знаков препинания. Нейросеть не знает, где остановиться. Решение: расставить запятые, точки, тире в нужных местах.
-
Неверное ударение. Самая частая жалоба в комментариях к обзорам сервисов. Причина: слово с несколькими вариантами ударения («а́тлас» / «атла́с»), имена собственные, редкие термины. Решение: написать слово с дефисом перед ударным слогом (
а-тлас) или заменить на транскрипцию. -
Аббревиатуры читаются побуквенно или как слово. «МФЦ» может прозвучать как «мфц» или «мфц» вместо «эм-эф-цэ». Решение: написать расшифровку или расставить точки между буквами.
-
Обрыв или артефакт в конце длинного фрагмента. Причина: слишком длинный кусок текста. Решение: разбить на абзацы по 300–500 символов.
-
Числа читаются неожиданно. «2026» может прозвучать как «две тысячи двадцать шесть» или «двадцать двадцать шесть» — зависит от контекста. Решение: написать словами там, где важна точность.
-
Дубли Drama 3 сильно отличаются. Это особенность эмоциональной модели: она вариативна. Неудачный дубль просто переделывают заново — кнопка «Повторить» в Истории открывает тот же текст.
Записать голос для озвучки руками требует микрофона, тишины и нескольких дублей. Тот же результат в Speakmi — вставляешь текст, выбираешь «Тёплый женский» или «Низкий мужской», получаешь дорожку за секунды. Запись своим голосом остаётся, если нужен живой эфир или импровизация на ходу.
Когда ИИ-озвучка не заменит живого диктора: честные ограничения
ИИ-озвучка справляется с большинством задач контент-мейкера: подкаст, обучающее видео, реклама, сказка, Reels. Но есть сценарии, где лучше нанять диктора или записать голос самому.
Когда ИИ не подойдёт:
-
Живой эфир или реальное время. Генерация занимает секунды, но не мгновения — для прямого эфира нужен живой голос.
-
Пение. Спикми генерирует речь, не вокал. Спеть своим клонированным голосом через сервис не получится.
-
Смена языка посреди фразы. Если в тексте русский абзац, потом английский, потом снова русский — это нужно генерировать отдельными фрагментами с разными голосами.
-
Чужой голос без согласия. Клонировать можно только свой голос или с подтверждённым правом. Клон голоса знаменитости или коллеги без разрешения — вне допустимого.
-
Когда нужна «неотличимая» копия живого человека. Клон звучит узнаваемо похоже на тебя, но не идентично. Для рекламы с юридической ответственностью за каждое слово лучше записать живой голос.
-
Сложная импровизация и реакция на собеседника. ИИ-голос работает по заранее написанному тексту.
Speakmi озвучивает текст и клонирует голос; приложения для практики английского с похожим названием — другой продукт.
Частые вопросы
- Как озвучить нарезку из фильма?
- Закадровый текст для нарезки берут из субтитров (файл SRT или встроенные субтитры YouTube) или расшифровывают вручную нужный кусок. Готовый текст вставляют в Speakmi, выбирают подходящий голос — например, «Новостной диктор» для документальной подачи или «Бархатный мужской» для драматичной — и скачивают MP3. Диалог с разными голосами собирается через функцию «Диалог» на сайте: до 5 ролей в одной сцене, один файл на выходе.
- Можно ли озвучить сцену из фильма разными голосами?
- Да, через раздел «Диалог» на speakmi.ru (меню «Создать»). Вставляете сценарий в формате «Имя: реплика», сервис создаёт роли автоматически — до 5 голосов в одной сцене, у каждой роли свой голос из каталога или клон. На выходе один аудиофайл со всей сценой. В Telegram-боте функция диалогов недоступна — только на сайте.
- Что такое Speakmi?
- Speakmi — сервис ИИ-озвучки текста и клонирования голоса на русском, работает как веб-студия на speakmi.ru и как Telegram-бот @speakmibot. Движок — Fish Audio. Первые 30 секунд бесплатно без карты, дальше пакеты токенов от 149 ₽ — токены не сгорают. Распознавания речи и публичного API в Speakmi нет.
- Как быстро генерируется аудио из текста?
- Короткая фраза (1–2 предложения) в Drama 3 — 1,5–3 секунды, в S2.1 Pro — 4–5 секунд (замеры Спикми, октябрь 2026). Длинный абзац занимает дольше: примерно 5–15 секунд в зависимости от объёма текста и загрузки сервера. Telegram-бот работает с той же скоростью, что веб-студия.
- Можно ли озвучить текст на русском бесплатно и без регистрации?
- Большинство сервисов требуют хотя бы регистрацию. У Speakmi — 30 секунд бесплатно новым пользователям, карта не нужна, но аккаунт нужен. Без регистрации работают некоторые зарубежные сервисы (например, Speaktor), но на русском языке у них обычно 1–2 голоса и ограниченная поддержка ударений.
- Чем отличается модель S2.1 Pro от Drama 3?
- S2.1 Pro — ровная дикторская модель, стабильные дубли, подходит для подкастов, обучающих видео и рекламы. Drama 3 — эмоциональная: поддерживает режиссуру через пометки в [квадратных скобках] и метки на словах (шёпот, акцент). Drama 3 точнее читает трудные слова (93,2% против 88,1% по данным Artificial Analysis) и быстрее на коротких фразах, но дубли сильнее отличаются друг от друга. До 12 ноября 2026 Drama 3 стоит как обычная озвучка.
- Можно ли исправить одно слово в готовой записи?
- Нет — ни в Speakmi, ни в большинстве TTS-сервисов. Редактирование отдельного слова в уже сгенерированном аудио недоступно. Если что-то не так — правите текст и генерируете фрагмент заново. Кнопка «Повторить» в Истории открывает тот же текст: можно переозвучить целиком с новыми правками.