Озвучить текст разными голосами: диалог на несколько ролей
Как озвучить сценку или диалог разными голосами за одну генерацию. До 5 ролей, эмоции, режиссура — без диктора и монтажа. Пошаговый гайд. Озвучить текст можно в Спикми.
Что такое озвучка диалога разными голосами и зачем она нужна
Обычная TTS-озвучка — один голос читает весь текст подряд. Многоголосая озвучка — каждой реплике назначен свой голос: рассказчик говорит одним, персонаж другим, злодей третьим. Итог — не монотонная начитка, а сцена, которую слушаешь как аудиоспектакль.
Форматы, где это реально нужно:
-
Сценки для корпоратива или праздника — юмористический скетч на 3–4 персонажа без актёров и студии.
-
YouTube-ролики с персонажами — анимация, комикс, образовательное видео, где каждый герой говорит своим голосом.
-
Подкасты и интервью — два ведущих или вопрос-ответ с разными тембрами.
-
Обучающие диалоги — разговорный урок, диалог «учитель — ученик», тренинговый кейс.
-
Аудиосказки и страшилки — «Репка» на 5 персонажей за одну генерацию, без склейки отдельных файлов.
Полезная ссылка, если ищешь голос под конкретного персонажа: озвучить фразу голосом онлайн.
Ключевое отличие от «записать каждого актёра отдельно и смонтировать» — ты не монтируешь. Один сценарий, один клик, один файл.
Как работает многоголосая озвучка: механика за 2 минуты
Принцип прямой: текст делится на реплики, каждой назначается голос, всё рендерится в один аудиофайл. Монтажа нет — файл уже склеен.
-
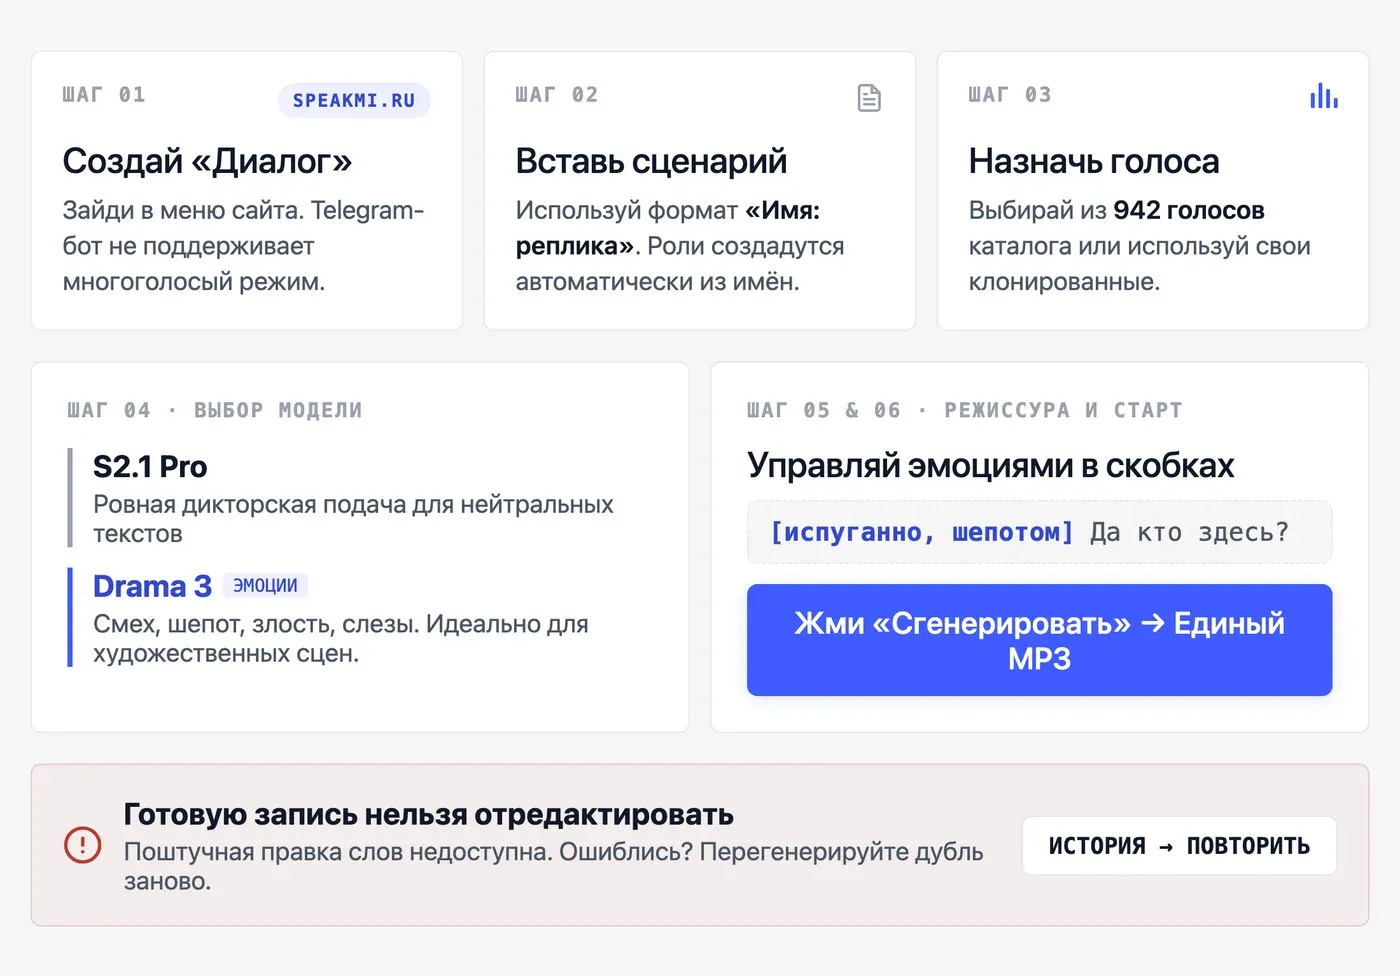
Открываешь раздел «Диалог» на speakmi.ru (меню «Создать»). Telegram-бот для этого не подходит — «Диалог» только на сайте.
-
Вставляешь сценарий в формате «Имя: реплика». Роли создаются автоматически из имён, которые ты используешь.
-
Назначаешь голос каждой роли — из 970 голосов каталога или свой клонированный голос (он появляется в «Диалоге» через несколько минут после создания, не мгновенно).
-
Выбираешь модель. S2.1 Pro — ровная дикторская подача, подходит для нейтральных текстов. Drama 3 (модель Fish Audio, в Speakmi с 14.10.2026) — эмоциональная: плачет, злится, шепчет, смеётся. Для драматичных сцен Drama 3 заметно выигрывает; до 12 ноября 2026 она стоит как обычная озвучка.
-
Добавляешь режиссуру (опционально, только для Drama 3): перед репликой в квадратных скобках пишешь, как её сыграть:
[сдерживая смех],[испуганно, шёпотом]. Пометки читаются моделью, вслух не звучат. -
Жмёшь «Сгенерировать» — получаешь единый MP3 со всей сценой.
Поправить одно слово в готовой записи нельзя. Если что-то не так — открываешь «Повторить» в Истории и генерируешь заново. Неудачный дубль просто переделывают.
Как подготовить сценарий для озвучки по ролям: короткие правила
Хороший сценарий экономит дубли. Несколько правил, которые работают:
-
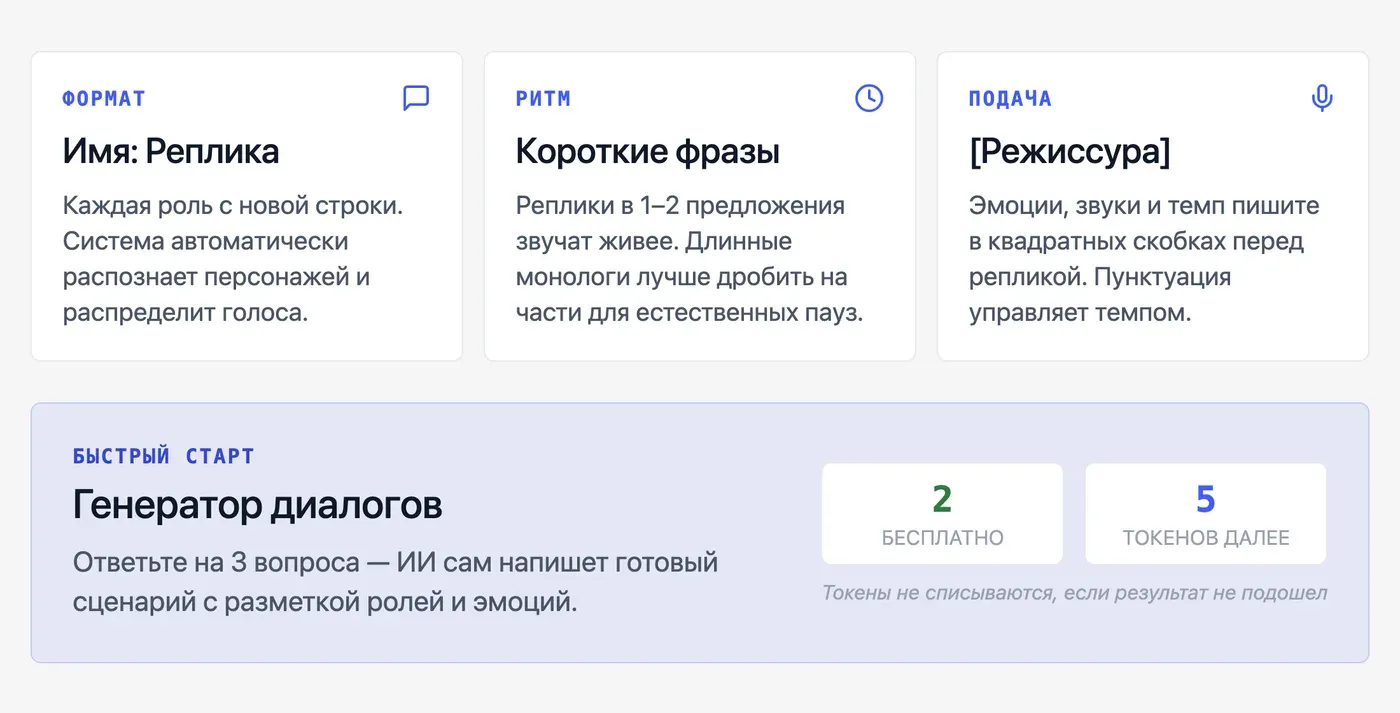
Формат строго «Имя: реплика» — каждая с новой строки. Спикми читает имена и создаёт роли сам:
Дед: Тянем-потянем.../Бабка: Помогаю! -
Короткие реплики лучше длинных монологов. Реплика на 1–2 предложения звучит живее, чем абзац, прочитанный одним голосом без пауз. Если монолог нужен — раздели его на несколько реплик одного персонажа.
-
Режиссёрские пометки — в квадратных скобках перед репликой (только для Drama 3):
[тихо, как будто не хочет, чтобы услышали]. Новая пометка посреди текста меняет подачу с этого места. Звуки тоже ставятся туда, где должны прозвучать:[вздох],[тихий смешок]. -
Метки на выделенных словах — шёпотом, с акцентом, мягко, медленнее, быстрее — меняют подачу только выделенного куска, остальное звучит как обычно.
-
Не смешивай языки в одной реплике. Смена языка посреди фразы не поддерживается — если нужна иностранная вставка, делай её отдельной репликой.
-
Пунктуация управляет ритмом. Троеточие добавляет паузу и сомнение, восклицательный знак — всплеск эмоции. Используй их осознанно, не для красоты.
Если не хочешь писать сценарий с нуля — в редакторе есть кнопка «Написать диалог»: отвечаешь на 1–3 вопроса (тип сцены, длина, число ролей), помощник генерирует сценарий с расставленной режиссурой. Первые 2 текста бесплатно, дальше 5 токенов за текст; если результат не понравился — токены не списываются.
Подробнее о том, как добавить эмоции: бесплатная озвучка текста с эмоциями.
Как озвучить сценку разными голосами в Speakmi: пошаговая инструкция
Speakmi генерирует диалог из готового сценария — нужен только текст, не микрофон. Вот полный путь:
-
Открой speakmi.ru — без регистрации не обойтись, но карту не спрашивают.
-
В меню «Создать» выбери «Диалог» (прямой адрес: speakmi.ru/app/dialogue).
-
Вставь сценарий в формате «Имя: реплика». Роли появятся автоматически.
-
Каждой роли назначь голос: фильтруй по полу, возрасту, манере — дикторская, разговорная, тёплая. Понравившийся голос прослушай в демо прямо там. В каталоге 970 голоса (на октябрь 2026).
-
Выбери модель: S2.1 Pro для ровной подачи, Drama 3 — если сцена эмоциональная. Переключается кнопкой над редактором.
-
Добавь пометки в
[скобках], если нужна режиссура конкретных реплик. -
Нажми «Сгенерировать». Готовый MP3 скачивается из раздела «История».
Первые 30 секунд — бесплатно, без карты. Пакеты токенов от 149 ₽, токены не сгорают, оплата картой РФ. Telegram-бот (@speakmibot) для диалогов не подходит — только сайт.
Если клонировал свой голос и хочешь поставить его на одну из ролей — подожди несколько минут после создания клона: он появится в выпадающем списке голосов «Диалога» не сразу.
Сколько голосов можно использовать и как выбрать нужные
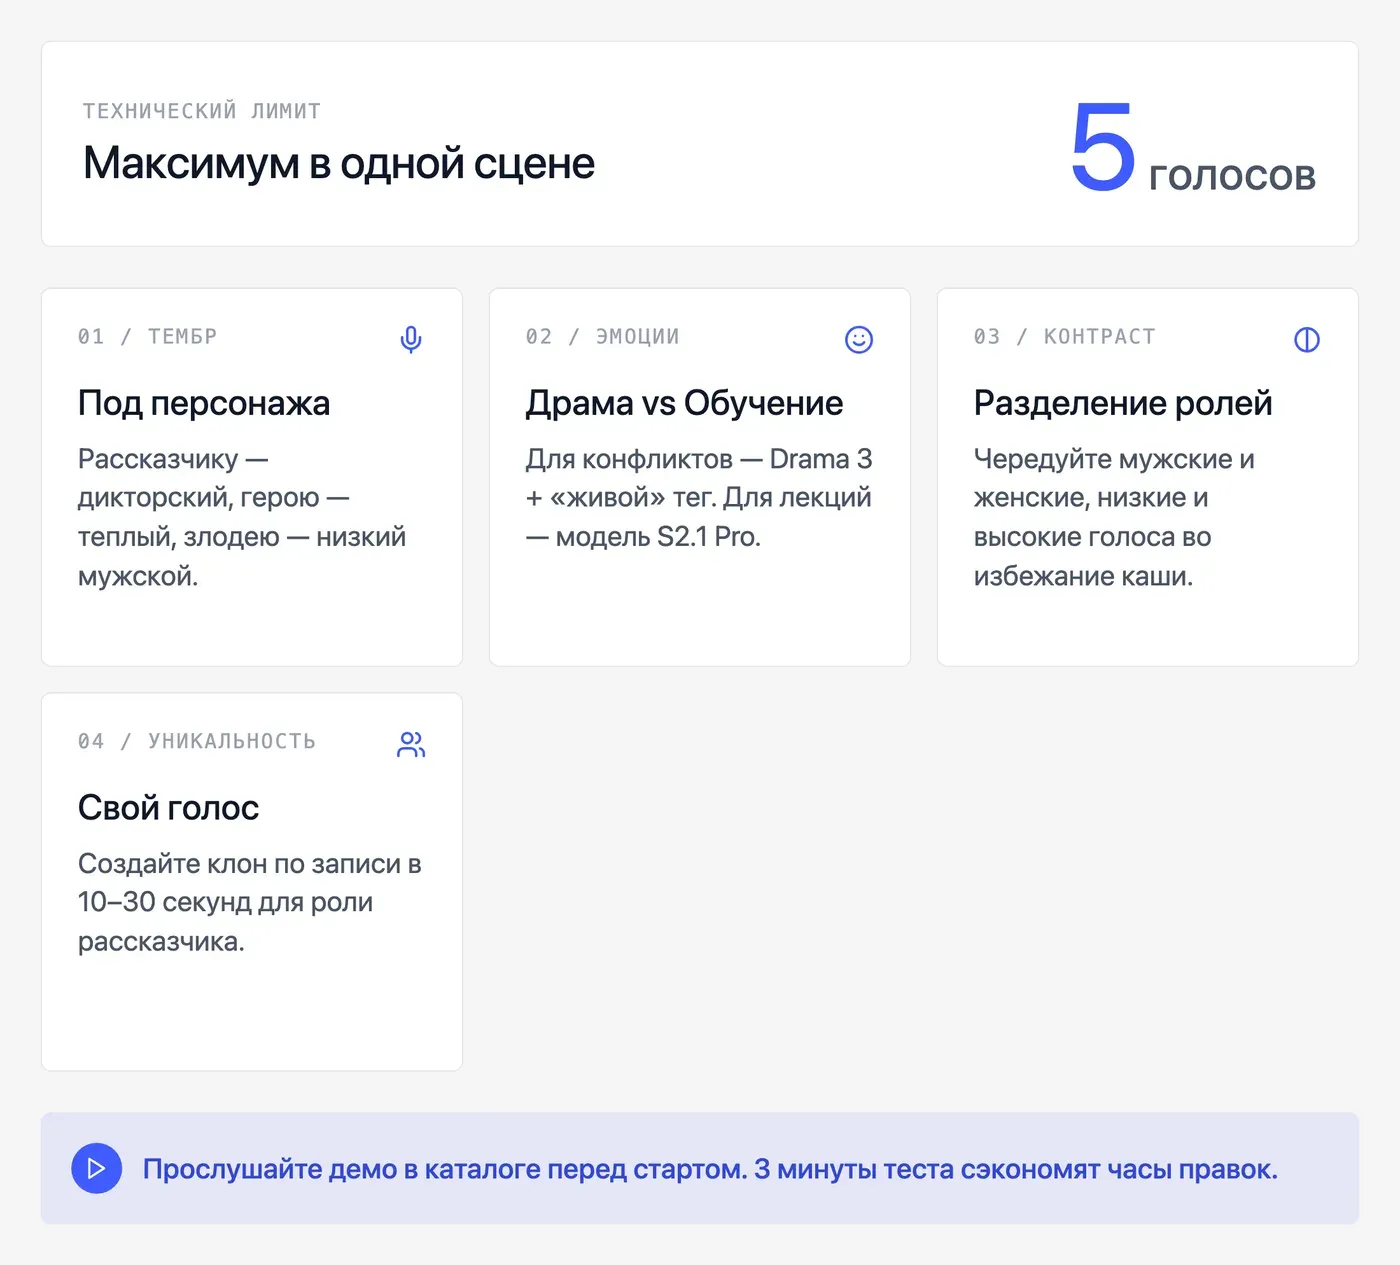
Жёсткое ограничение: до 5 голосов в одной сцене. Больше нельзя — это техническое ограничение продукта.
Как подобрать голос под роль:
-
Тембр под персонажа. Рассказчик — нейтральный дикторский («Новостной диктор», «Телевизионный диктор»). Главный герой — живой и тёплый («Живой женский», «Тёплый женский»). Злодей или суровый персонаж — низкий мужской («Низкий мужской», «Бархатный мужской»). Ребёнок — детский голос из каталога на speakmi.ru/golosa/detskiy.
-
Эмоциональная сцена vs нейтральная. Для сцен с конфликтом, страхом, смехом — Drama 3 + голос с «живым» тегом. Для обучающего диалога или новостного формата — S2.1 Pro + дикторский голос.
-
Контраст между ролями. Если все персонажи звучат похоже — сцена смешивается в кашу. Ставь рядом мужской и женский, низкий и высокий, разговорный и дикторский.
-
Свой клонированный голос. Можно поставить на одну из ролей — например, чтобы рассказчик звучал твоим голосом. Клон создаётся из записи 10–30 секунд в разделе «Мои голоса».
Прослушай демо в каталоге для каждой роли по очереди — это занимает 2–3 минуты и экономит дубли потом.
Озвучка сценки бесплатно: что реально доступно без оплаты
Новым пользователям Speakmi даёт 30 секунд озвучки бесплатно, без карты. Для короткой сценки (поздравление, скетч на 2–3 реплики) этого может хватить. Для сцены на 1–2 минуты — уже нет.
Что происходит дальше: покупаешь пакет токенов от 149 ₽. Токены не сгорают — если сегодня озвучил одну сцену, остаток лежит до следующего раза. Подписки и автосписаний нет, платишь только когда нужно.
Ориентир по расходу: стоимость около 10–13 ₽ за минуту аудио (данные Спикми, октябрь 2026). Сцена на 3 минуты обойдётся примерно в 30–40 ₽.
Бесплатных альтернатив с диалогами несколько. Google AI Studio (Speech Generation на базе Gemini 2.5 Pro и Flash) поддерживает мультирежим — диалог двух персонажей — полностью бесплатно. Минус: голос меняется от генерации к генерации даже при одних настройках, примерно 1 из 5 генераций «слетает» из-за нагрузки. Подходит для экспериментов, но не для серийного контента. Подробнее про озвучку разными голосами бесплатно.
Speakmi не подойдёт, если нужен живой эфир в реальном времени, распознавание речи или больше 5 персонажей в одной сцене — этого в продукте нет.
Частые ошибки при озвучке диалога: почему голоса звучат неестественно
-
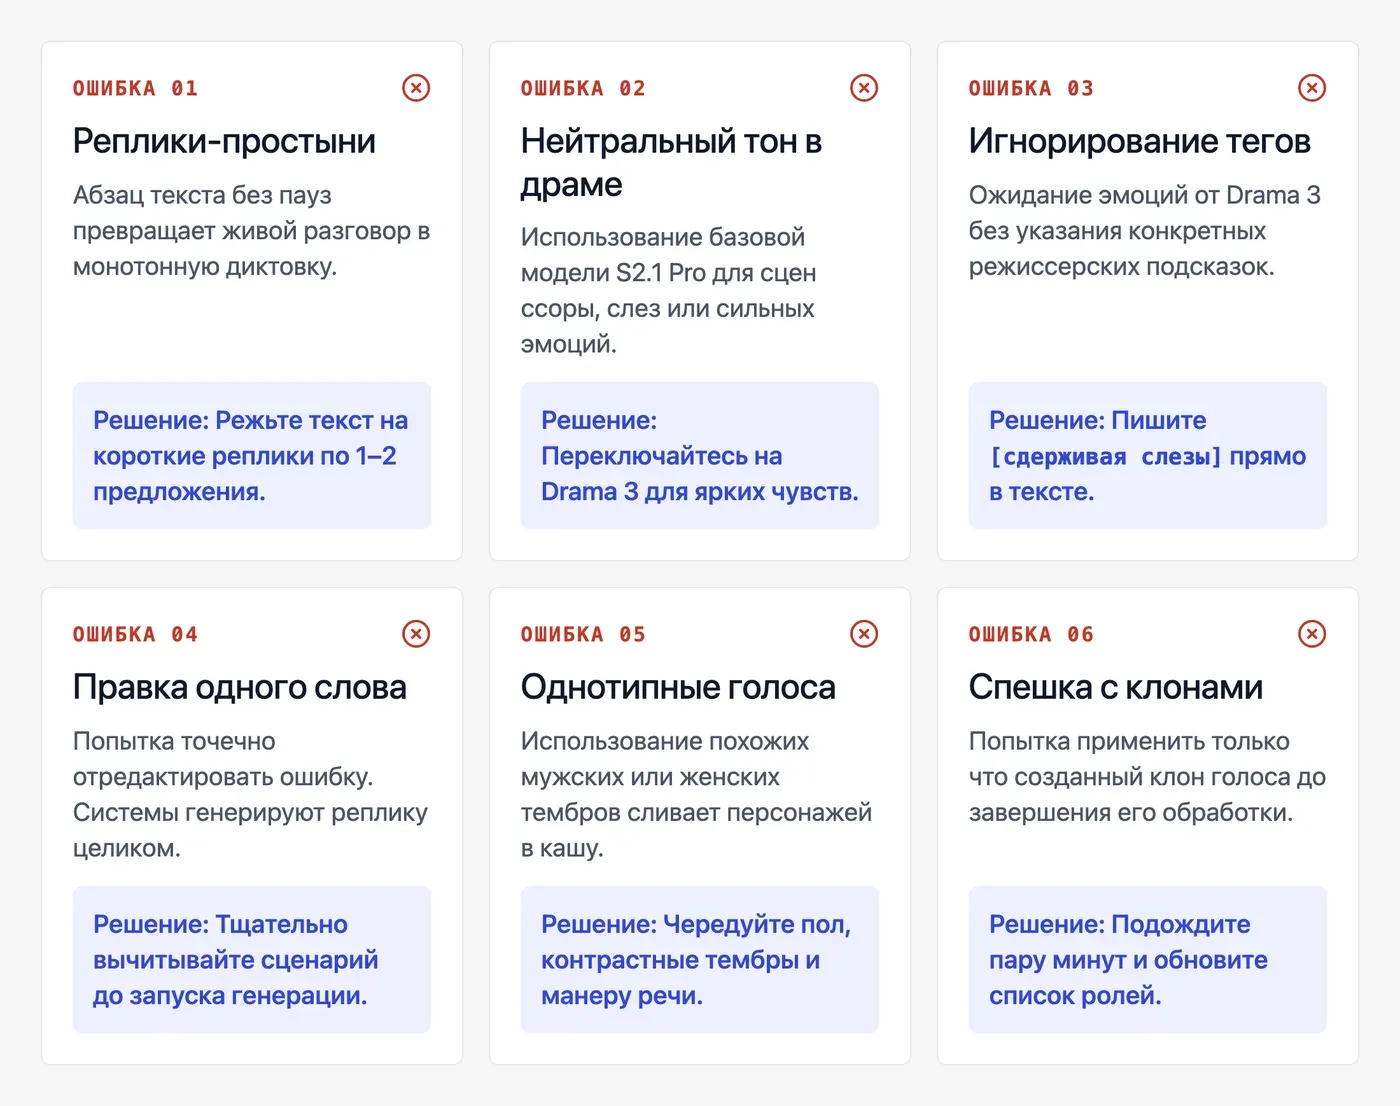
Слишком длинные реплики без пауз. Абзац текста в одной реплике звучит как диктовка, а не разговор. Дели на короткие куски — реплика на 1–2 предложения.
-
Ровная модель S2.1 Pro для драматичной сцены. S2.1 Pro хорошо читает нейтральный текст, но не злится и не плачет. Для эмоциональной сцены нужна Drama 3 — иначе конфликт звучит как объявление на вокзале.
-
Нет режиссёрских пометок у эмоциональных реплик. Drama 3 умеет играть, но без подсказки выберет нейтральную подачу. Пиши
[сдерживая слёзы]или[агрессивно, в упор]— и получишь именно это. -
Попытка поправить одно слово. Редактирования куска нет — только новая генерация. Поэтому перед запуском вычитывай сценарий целиком: опечатка в имени персонажа или неверное ударение всплывут уже в готовом файле.
-
Все голоса одного типа. Пять мужских дикторских голосов в одной сцене — персонажи сливаются. Чередуй тембры, пол, манеру.
-
Свежий клон поставили сразу в диалог. Клонированный голос появляется в списке ролей через несколько минут после создания — если не нашёл его сразу, подожди и обнови страницу.
Частые вопросы
- Что такое Speakmi?
- Speakmi — сервис ИИ-озвучки текста и клонирования голоса на русском, работает как веб-студия на speakmi.ru и как Telegram-бот (@speakmibot) на одной базе. Движок — Fish Audio. Первые 30 секунд бесплатно, без карты; пакеты токенов от 149 ₽, токены не сгорают, оплата картой РФ. Распознавания речи и публичного API в Спикми нет. Приложения для практики английского с похожим названием — другой продукт.
- Можно ли озвучить сценку с разными голосами бесплатно?
- Да, первые 30 секунд — бесплатно и без карты. Для очень короткой сценки (2–3 реплики) этого хватит. Сцена на 1–2 минуты потребует пакет токенов от 149 ₽ (около 10–13 ₽ за минуту, данные Speakmi, октябрь 2026). Бесплатная альтернатива для экспериментов — Google AI Studio в мультирежиме, но голос нестабилен между генерациями.
- Сколько персонажей можно озвучить в одной сцене?
- До 5 разных голосов в одной сцене — это жёсткое ограничение. Каждой роли назначается отдельный голос из каталога или свой клонированный голос. Больше 5 персонажей в одной генерации не поддерживается.
- Работает ли многоголосая озвучка в Telegram-боте Speakmi?
- Нет. Раздел «Диалог» с несколькими голосами доступен только в веб-студии на speakmi.ru. В Telegram-боте (@speakmibot) работает озвучка одним голосом, включая Drama 3 и клонирование, но не многоролевой диалог.
- Как добавить эмоции в реплику конкретного персонажа?
- Перед репликой в квадратных скобках напиши, как её сыграть: [едва сдерживая злость], [радостно, почти кричит], [тихо, испуганно]. Это работает только с моделью Drama 3 — переключи её в редакторе перед генерацией. Пометка читается моделью и влияет на подачу, вслух не звучит. Для отдельных слов работают метки: шёпотом, с акцентом, медленнее.
- Можно ли исправить одно слово в готовой озвучке диалога?
- Нет. Редактирования куска или отдельного слова в готовой записи нет — только полная перегенерация. В разделе «История» кнопка «Повторить» открывает тот же текст, можно исправить ошибку и запустить заново. Поэтому вычитывай сценарий до запуска: опечатки и неверные ударения исправляй в тексте, не после.
- В каком формате скачивается готовая озвучка сценки?
- Готовый файл скачивается в формате MP3. Это единый файл со всей сценой — не набор отдельных дорожек по ролям, а уже склеенная запись. Для дальнейшей обработки (обрезка пауз, изменение темпа) подойдёт любой аудиоредактор — например, бесплатный Audacity.