Промт для генерации голоса: правила настройки
Как написать промт для озвучки текста, чтобы ИИ-голос звучал естественно. Параметры, примеры промтов, типичные ошибки — практический гайд для Спикми (Speakmi).
Что такое промт для голоса и зачем он нужен при озвучке?
Промт — это инструкция для нейросети: описываешь голос словами, и она генерирует речь с нужным характером. Без промта сервис выбирает дефолтные настройки — ровный механический голос без пауз и живой интонации.
Промт нужен в двух ситуациях. Первая — ты создаёшь новый голос с нуля и описываешь его характер текстом (возраст, тембр, темп, манера подачи). Вторая — ты работаешь с уже выбранным голосом и управляешь конкретными фразами через теги эмоций прямо в тексте. Оба подхода работают вместе: промт задаёт общий характер голоса, теги управляют отдельными репликами.
Какие параметры влияют на результат: скорость, эмоция, стиль речи?
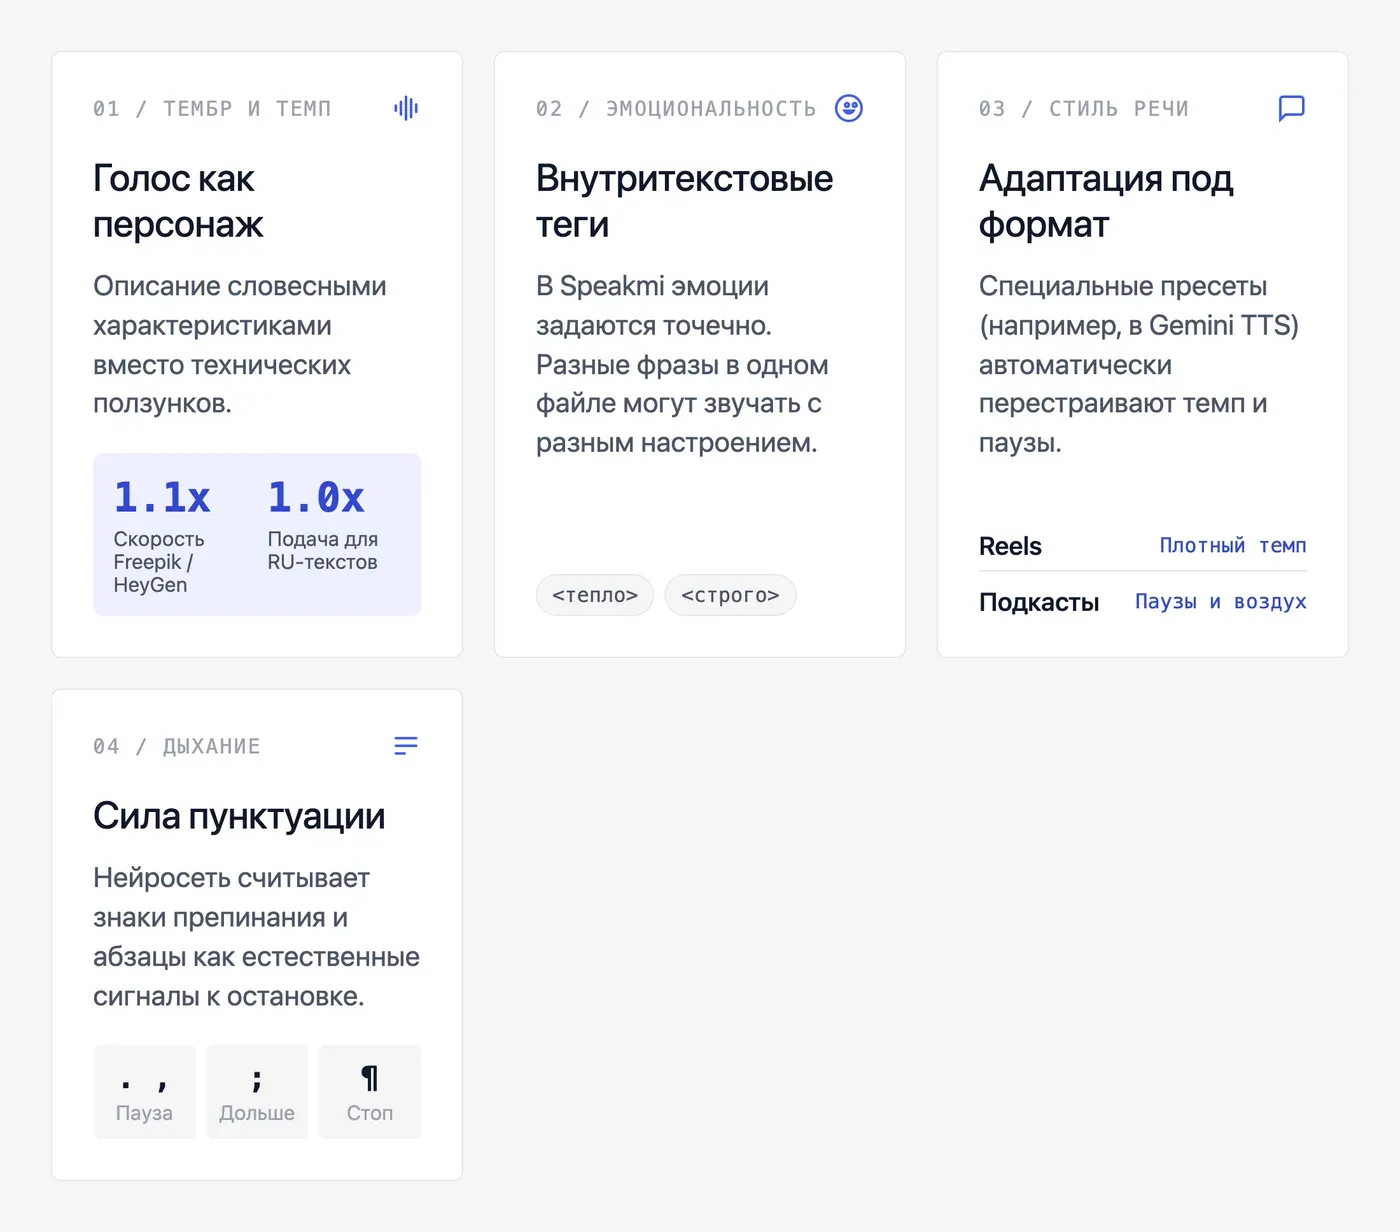
Четыре основных слоя, которые описывает промт: тембр (низкий/высокий, мягкий/жёсткий), темп (быстро/медленно, с паузами или без), характер подачи (уверенный, доверительный, нейтральный, игровой) и эмоциональный тон (спокойный, воодушевлённый, тревожный, грустный). Это не технические ползунки — это словесные характеристики персонажа.
Тембр и темп. Описываешь голос как персонажа: «молодой мужчина, говорит уверенно, темп чуть выше среднего». В Freepik есть отдельный числовой параметр скорости — авторы, которые работают с этим сервисом, рекомендуют значение 1.1 для ощущения динамики. В HeyGen (Minimax) скорость тоже выставляется на 1.1, подача — на 1.0 при работе с русскими текстами.
Эмоция. В Speakmi (Спикми) эмоции задаются тегами прямо в тексте. Это значит, что в одном файле разные фразы могут звучать по-разному: одна — тепло, другая — строго.
Стиль речи. Сервисы вроде Gemini TTS выделяют стиль речи в отдельное поле — оно влияет на темп и паузы под конкретный формат: Reels, YouTube, подкаст. Для подкаста нужны паузы после тезисов, для Reels — плотный темп без пустот.
Паузы и дыхание. Управляются не только через промт голоса, но и через оформление текста: точки, тире, абзацы. Нейросеть читает пунктуацию как сигнал к остановке. Короткое предложение — пауза. Точка с запятой — чуть дольше. Абзац — полная остановка.
Как написать промт для озвучки текста: пошаговая инструкция
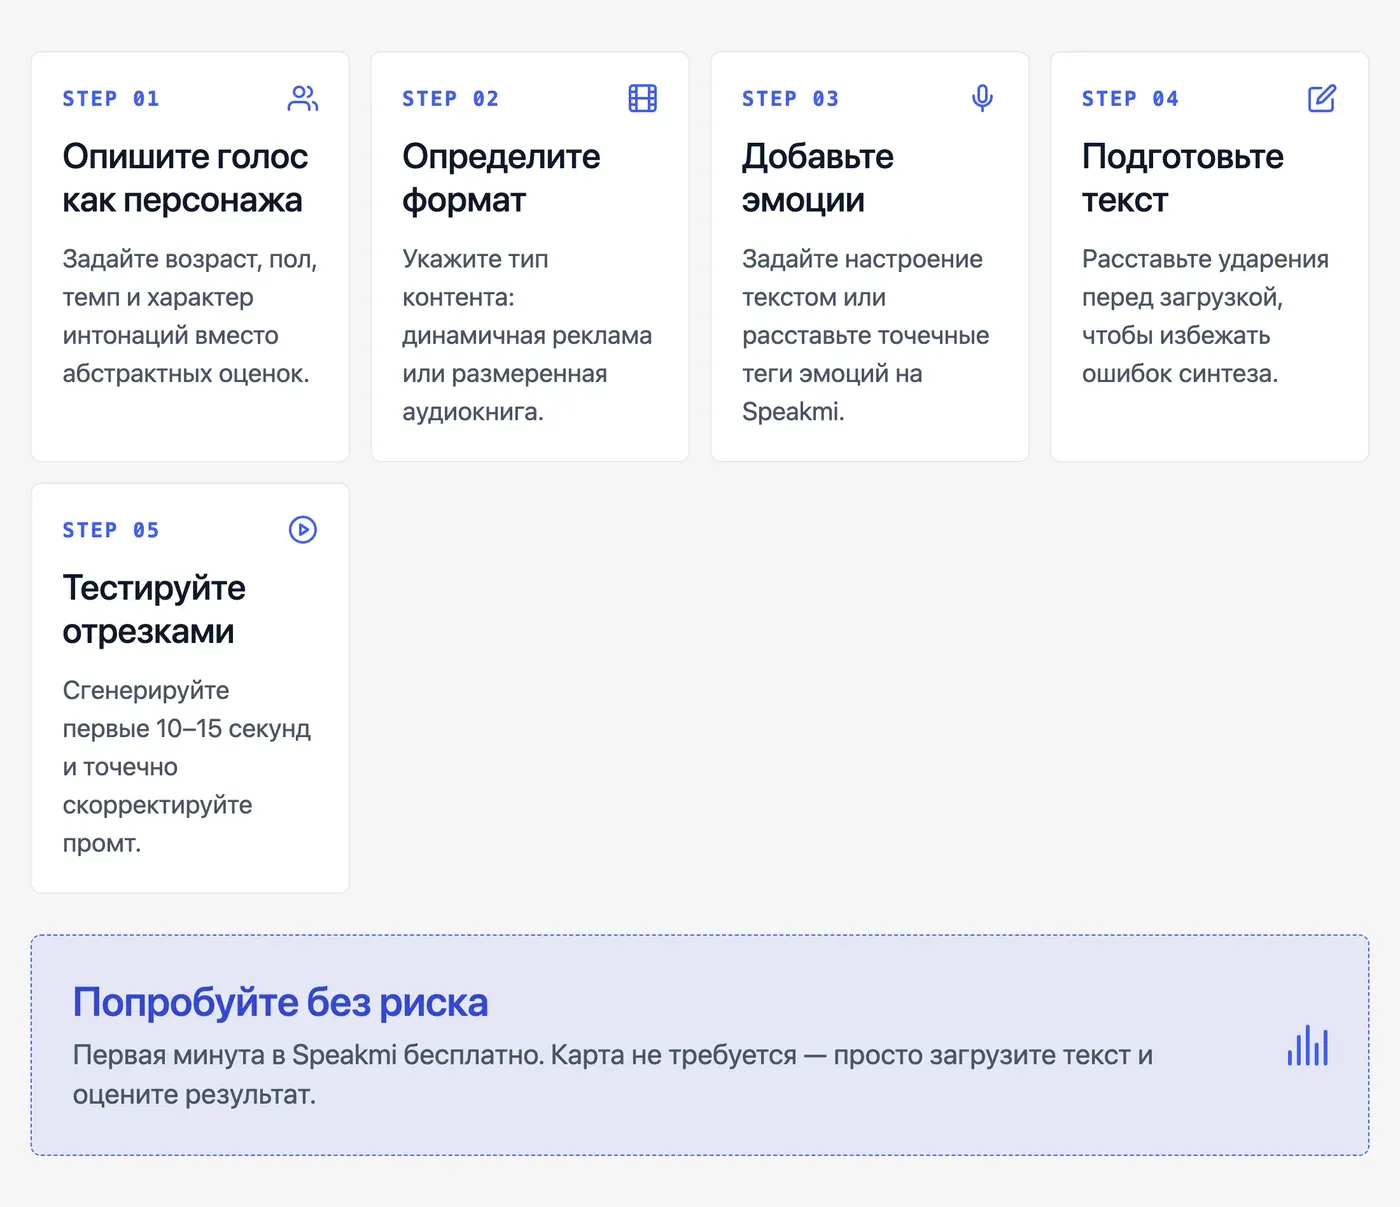
Шаг 1. Опиши голос как персонажа.
Не «хороший голос», а конкретно: «женщина 30–35 лет, говорит спокойно и тепло, темп средний, интонация поднимается в конце важных тезисов». Чем точнее описание, тем меньше итераций. Модель bytedance/seed-audio-1.0 и аналогичные ей принимают именно такой текст — голос описывается словами, не выбирается из списка.
Шаг 2. Определи формат.
Подкаст, реклама, видеоролик, аудиокнига — у каждого своя динамика. Для рекламы нужна энергия и чёткая дикция, для аудиокниги — ровный темп и выразительные паузы. Укажи формат в промте явно: нейросеть скорректирует подачу.
Шаг 3. Добавь эмоциональный контекст.
«Расскажи эту историю в драматическом стиле. Голос спокойный и грустный» — именно так выглядит рабочий промт в Google AI Studio. Для Speakmi — вставляешь теги эмоций в нужные места текста.
Шаг 4. Подготовь текст перед генерацией.
Это отдельный этап, не часть промта голоса. Проверь ударения — это главная проблема русскоязычной озвучки. В Word можно поставить ударение вручную: после нужной гласной вводишь 0301, нажимаешь Alt+X — символ ударения встаёт на место. Потом загружаешь текст в сервис.
Шаг 5. Сгенерируй и послушай первые 10–15 секунд.
Если темп не тот — правишь одно слово в описании, не весь промт. Если эмоция «плоская» — добавляешь тег в конкретное место текста.
Если боишься начинать: первые 30 секунд в Speakmi бесплатно, карта не нужна. Можно послушать свой текст реальным голосом прежде, чем разбираться с настройками.
Примеры промтов для разных задач: подкаст, реклама, видеоролик
Готовые промты под форматы — самый быстрый способ получить нужное звучание без долгих итераций.
| Формат | Промт | На что влияет |
|---|---|---|
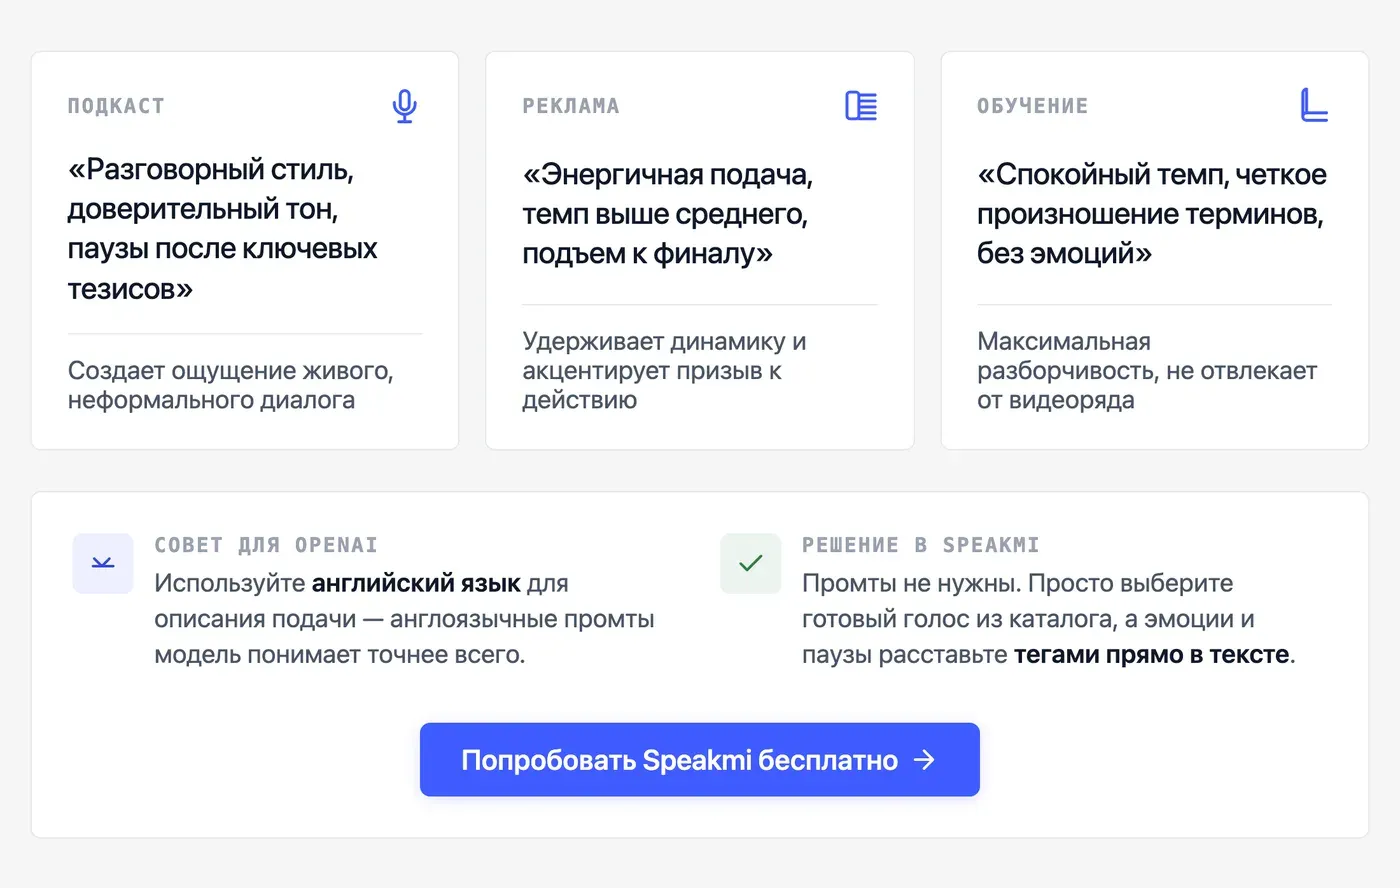
| Подкаст | «Мужчина 35–40 лет, разговорный стиль, доверительный тон, паузы после ключевых тезисов, темп чуть ниже среднего» | Паузы, ощущение живого разговора |
| Реклама | «Женщина 28–32 года, энергичная подача, чёткая дикция, темп выше среднего, интонация поднимается к финальному призыву» | Динамика, акцент на последней фразе |
| Видеоролик (обучение) | «Нейтральный мужской голос, спокойный темп, чёткое произношение терминов, без лишних эмоций» | Разборчивость, не отвлекает от картинки |
| Аудиокнига | «Женщина 40+, тёплый тембр, выразительные паузы, эмоция меняется по ходу сцены» | Погружение, смена настроения |
| Игровой персонаж / тематика | «Голос пирата: низкий, грубоватый, с театральной интонацией» | Узнаваемый характер |
Тестовый инструмент от OpenAI (сейчас в открытом доступе) принимает ровно такие описания — 11 базовых голосовых моделей, 5 пресетов подачи. Если промт написан на русском — прогони его через ChatGPT и попроси перевести на английский: модель OpenAI лучше реагирует на английские описания.
Для Speakmi промт в поле описания не нужен — выбираешь голос из каталога, а эмоции и паузы расставляешь тегами прямо в тексте. Попробовать бесплатно →
Какие ошибки в промте портят голос и как их исправить?
Три ошибки встречаются чаще остальных.
Ошибка 1: слишком общее описание. «Хороший голос для видео» — нейросеть выберет дефолт. Правило: каждое прилагательное в промте должно исключать противоположное. «Спокойный» исключает «взволнованный». «Быстрый» исключает «медленный». Если описание можно применить к любому голосу — оно не работает.
Ошибка 2: использование готовых пресетов из библиотеки без изменений. Пресеты ElevenLabs узнаются в десятках чужих роликов — аудитория это слышит. Даже небольшое изменение описания голоса даёт уникальный результат.
Ошибка 3: игнорирование текста. Промт задаёт общий характер, но паузы и ударения — это работа с самим текстом. Нейросеть читает знаки препинания как инструкцию. Слипшиеся предложения без точек дают монотонный поток. Неверное ударение в слове «замок» (замок или замок?) — это уже не промт, это опечатка в тексте, которую промт не исправит.
Ошибка 4: ждать идеала с первой генерации. Лиза Наговицына, сооснователь Speakmi, говорит об этом прямо:
«Вайбкодинг — это и правда не один раз написал промпт, получил готовый сайт. Это инструмент и формат взаимодействия с нейросетью, которая спустя много итераций, много правок и обучения будет приносить результаты.»
То же самое про озвучку: первая генерация — черновик, не финал.
Как проверить и доработать промт без повторной генерации всего текста?
Слушай по частям, не целиком. Первые 10–15 секунд скажут всё про темп и тон. Если они устраивают — слушаешь дальше. Если нет — меняешь одну переменную, не весь промт.
Правило одной переменной. Темп не тот — меняешь только описание темпа. Эмоция плоская — добавляешь тег эмоции к конкретной фразе. Ударение съехало — правишь слово в тексте. Менять всё сразу — значит не понимать, что сработало.
Постобработка как страховка. Если встроенных инструментов не хватает — голос можно обработать в аудиоредакторе. Эквалайзер, компрессор, лёгкое изменение высоты тона меняют звучание до неузнаваемости. Авторы, которые работают в Premiere Pro, добавляют поверх сгенерированной дорожки тихий фоновый шум микрофона — голос перестаёт звучать «чисто студийно» и воспринимается как живая запись.
Тест на монотонность. Прослушай текст с закрытыми глазами. Если через 30 секунд интонация не изменилась — промт не работает. Добавь в текст короткие предложения, точки, тире. Разбей длинный абзац на два. Это бесплатная правка, которая работает до любой генерации.
В Speakmi эмоции задаются тегами прямо в тексте — не ползунками, поэтому интонацию можно поправить за одну правку, а не пересводить всё заново. Попробуй в Telegram-боте: отправляешь текст с тегами — получаешь дорожку.
Частые вопросы
- Что писать в промте для ИИ-голоса, чтобы он звучал живо?
- Описывай голос как персонажа: пол, примерный возраст, темп, характер подачи, эмоциональный тон. Например: «женщина 30 лет, говорит тепло и уверенно, темп средний, делает паузы после важных тезисов». Каждый параметр должен исключать противоположное — «быстрый» исключает «медленный». Общие слова вроде «хороший голос» нейросеть игнорирует и выбирает дефолт.
- Можно ли задать эмоцию в промте для озвучки?
- Да. Способ зависит от сервиса. В Google AI Studio пишешь промт над диалоговым окном: «Расскажи эту историю в драматическом стиле. Голос спокойный и грустный» — модель Gemini 2.5 Flash стабильно реагирует на такие описания. В Speakmi эмоции задаются тегами прямо внутри текста — каждая фраза может звучать с разной эмоцией без повторной генерации всего файла.
- Как указать скорость и паузы в промте для генерации голоса?
- Скорость — через описание («темп чуть выше среднего», «говорит размеренно, не торопится»). Паузы — через пунктуацию в тексте: точка даёт короткую паузу, абзац — длинную. В Freepik и HeyGen есть числовой параметр скорости — авторы, работающие с этими сервисами, рекомендуют значение 1.1 для ощущения динамики.
- Промт влияет на выбор голоса или только на стиль речи?
- Зависит от сервиса. При создании нового голоса с нуля (например, в ElevenLabs или через модель seed-audio) промт описывает сам голос — тембр, возраст, характер. Это формирует голосовую модель. Если голос уже выбран из каталога — промт или теги влияют только на стиль подачи конкретного текста, не на базовый тембр.
- Как написать промт для рекламной озвучки с нужной интонацией?
- Укажи формат явно и добавь динамику: «женщина 28–32 года, энергичная подача, чёткая дикция, темп выше среднего, интонация поднимается к финальному призыву». Для рекламы важно, чтобы последняя фраза звучала с подъёмом — пропиши это отдельно. В Speakmi финальный призыв можно выделить тегом эмоции прямо в тексте.
- Почему ИИ-голос звучит монотонно, хотя промт написан правильно?
- Скорее всего, дело в тексте, а не в промте. Нейросеть читает знаки препинания как паузы — слипшиеся длинные предложения без точек дают монотонный поток. Разбей абзацы, добавь тире и короткие предложения. Ещё одна причина — ровный ритм слов: чередуй длинные и короткие предложения внутри абзаца. Если сервис поддерживает теги эмоций — добавь их к ключевым фразам.
- Сколько символов должен быть промт для озвучки текста?
- Для описания голоса — 50–150 символов достаточно. Длинный промт не улучшает результат: нейросеть берёт ключевые характеристики, остальное игнорирует. Важна точность, а не объём. Если промт на русском плохо воспринимается моделью — переведи его на английский через ChatGPT: большинство западных TTS-моделей (OpenAI, ElevenLabs) лучше реагируют на англоязычные описания.
- Нужен ли промт, если я клонирую свой голос?
- При клонировании промт голоса не нужен — модель берёт характеристики из твоей записи-образца (10–30 секунд). В Speakmi клонирование работает прямо в Telegram-боте: отправляешь голосовое сообщение — получаешь свой голос, который можно использовать повторно. Управлять интонацией в уже клонированном голосе можно через теги эмоций в тексте.