Как записать голос нейросетями: клонирование без микрофона
Клонировать голос или получить чужой — без студии и микрофона. Пошагово: что нужно, сколько занимает, где попробовать бесплатно прямо сейчас. Разбор от Спикми.
Если тебе нужна дорожка сегодня, а микрофона нет — заходишь в Speakmi (Спикми), вставляешь текст, выбираешь голос из каталога и получаешь аудио за секунды. Первые 30 секунд бесплатно, без карты.
Чем «записать голос нейросетью» отличается от обычной записи в микрофон?
Обычная запись фиксирует звук в реальном времени — нужен микрофон, тихая комната и голос прямо сейчас. Нейросеть работает иначе: она берёт текст и превращает его в речь, либо по образцу конкретного голоса, либо по готовому голосу из библиотеки.
Два разных сценария:
-
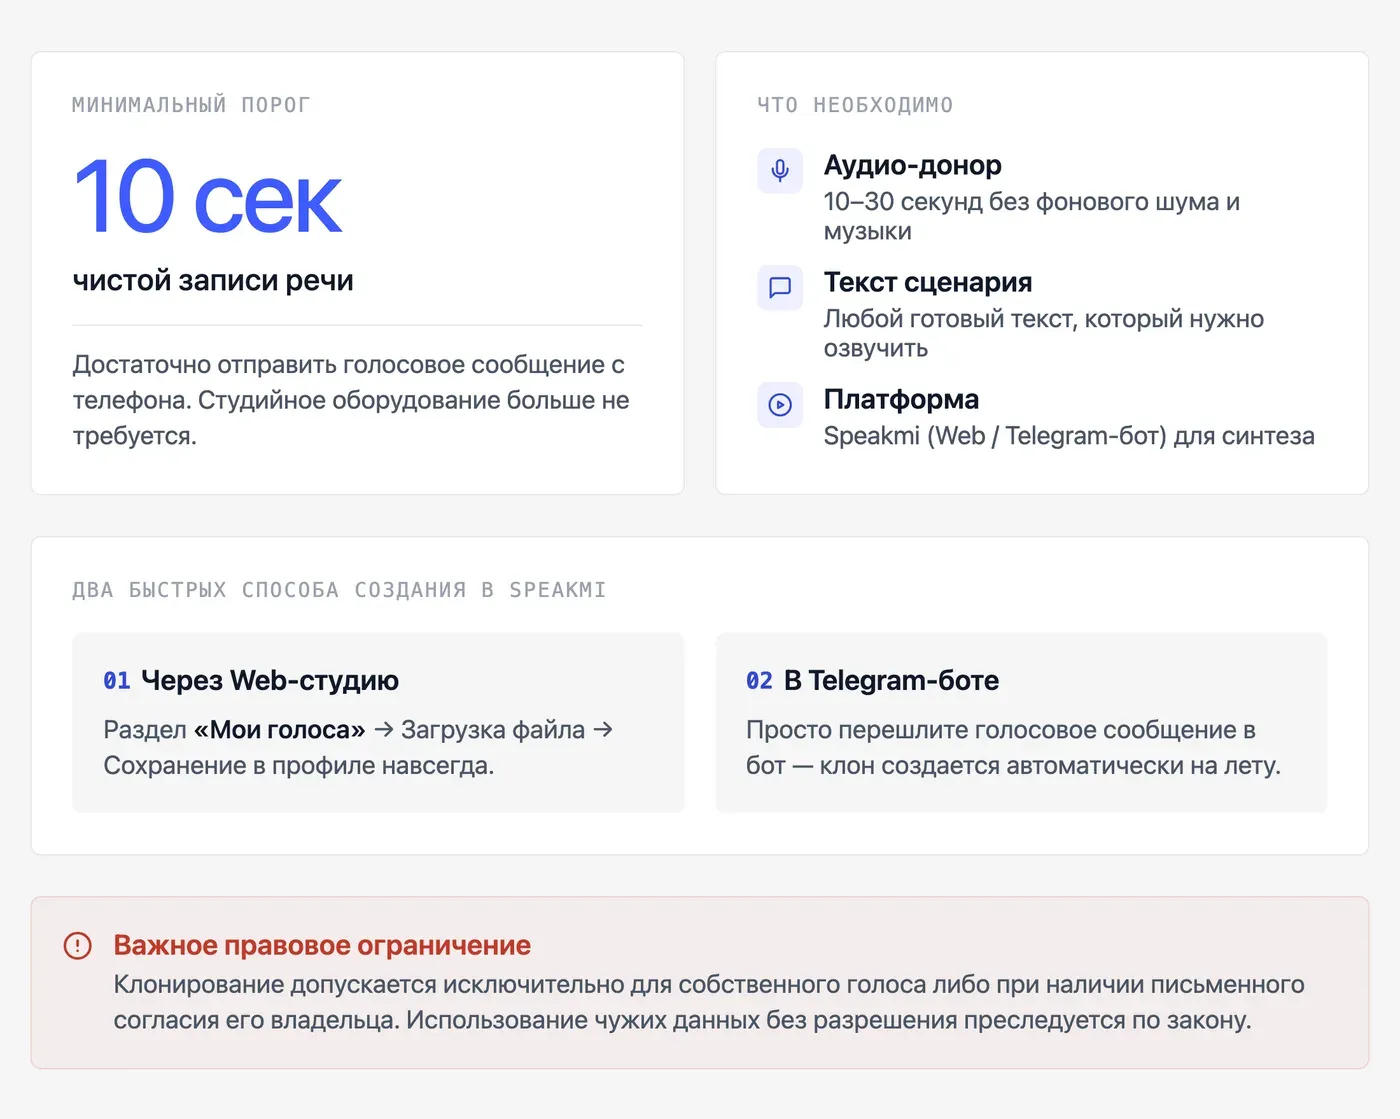
Клонирование — загружаешь короткую запись своего голоса (10–30 секунд), нейросеть создаёт его цифровую копию. Дальше любой текст она читает узнаваемо похожим на тебя голосом.
-
Генерация из библиотеки — выбираешь голос из каталога (мужской, женский, разные тембры) и получаешь озвучку без какой-либо записи вообще.
Главная разница с микрофоном: голос не привязан к моменту. Захрипел, нет времени, ночь — не важно. Текст озвучивается в любое время.
Как клонировать голос человека: что нужно и сколько это занимает?
Клонирование голоса сегодня работает по короткому образцу — студийная запись не нужна. Достаточно 10–30 секунд чистой речи, записанной даже на диктофон телефона в тихой комнате.
Что нужно для клонирования:
-
Запись голоса — 10–30 секунд без музыки и шума на фоне. Подойдёт голосовое сообщение из мессенджера.
-
Сервис клонирования — Speakmi, Voicebox (локальный, бесплатный, но требует мощный ПК и сложную настройку), ElevenLabs (облачный, платный, недоступен в РФ без VPN).
-
Текст, который нужно озвучить.
Как это работает в Speakmi:
-
В веб-студии: раздел «Мои голоса» → «Клонирование» → загрузи запись → голос сохраняется навсегда.
-
В Telegram-боте (https://t.me/speakmibot): просто отправь голосовое сообщение — мгновенный клон готов без загрузки файлов.
Свой голос клонируется из записи на 10–30 секунд — в Telegram-боте это просто отправленное голосовое сообщение, без настройки студии.
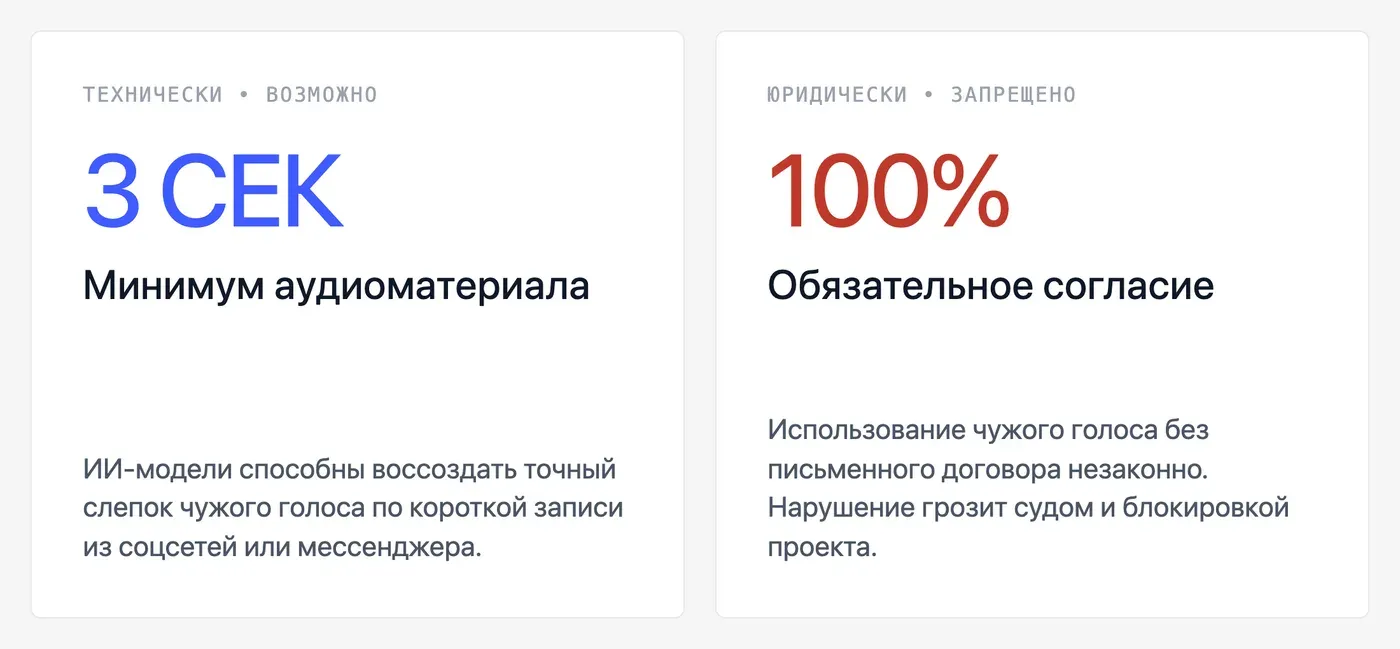
Важно: клонировать можно только свой голос или голос, на использование которого у тебя есть явное согласие владельца. Клонирование чужого голоса без разрешения — нарушение закона.
По данным исследований рынка TTS-сервисов за 2026 год, минимальный порог для качественного клона — 10 секунд чистой речи (Neironka.pro, 2026). Некоторые сервисы заявляют о работе от 3 секунд, но на практике 10–15 секунд дают заметно более устойчивый результат.
Как сгенерировать другой голос без записи — только из текста?
Если клонировать свой голос не нужно — достаточно выбрать готовый голос из библиотеки сервиса и вставить текст. Никакого образца не требуется.
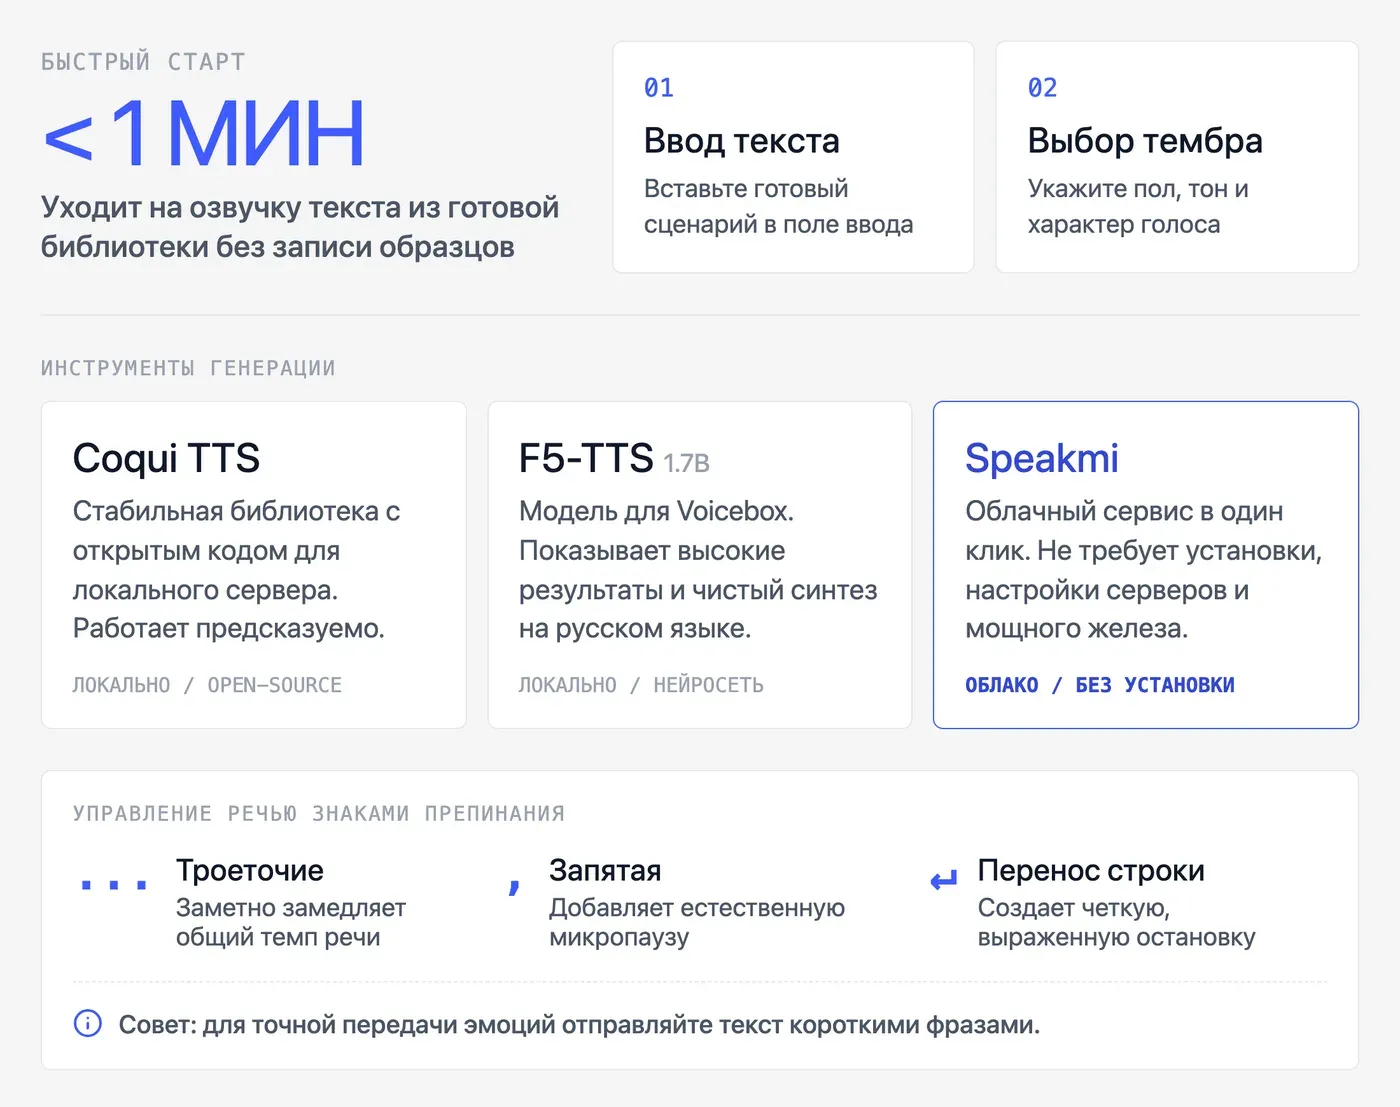
Это самый быстрый способ получить озвучку: открываешь сервис, пишешь или вставляешь текст, выбираешь голос (мужской, женский, нужный тембр) — и скачиваешь аудио. Весь процесс занимает меньше минуты на короткий текст.
Среди инструментов, которые используют разработчики для локальной генерации:
-
Coqui TTS — библиотека с открытым кодом, работает стабильно и предсказуемо на локальном сервере (в отличие от модели Bark, которую авторы видео-обзоров характеризуют как «непредсказуемую»).
-
F5-TTS (версия 1.7B) — модель, которую используют в локальных сборках Voicebox; показывает хорошие результаты на русском.
-
Speakmi — облачный вариант без установки: вставил текст, выбрал голос, скачал файл.
Интонацию и паузы в нейросетевой озвучке можно контролировать знаками препинания: троеточие замедляет темп, запятая добавляет паузу, перенос строки — чёткую остановку. Для точного контроля эмоций лучше отправлять текст короткими фразами, а не целиком.
Запись голоса через программу vs нейросеть: что выбрать для контента?
Зависит от задачи. Вот прямое сравнение:
| Критерий | Программа записи (Audacity, Adobe Audition) | Нейросеть (Speakmi, ElevenLabs) |
|---|---|---|
| Нужен микрофон | Да, обязательно | Нет |
| Нужен тихий фон | Да | Нет |
| Время на озвучку 1 минуты текста | 5–15 минут с дублями и монтажом | 10–30 секунд |
| Правка ошибки в тексте | Перезапись фрагмента | Перегенерация за секунды |
| Узнаваемость голоса | 100% — это ты | При клонировании — узнаваемо похоже |
| Стоимость старта | Бесплатно (Audacity) | Первые 30 секунд бесплатно |
| Регулярный контент | Каждый выпуск — новая запись | Один раз сохранил голос — дальше только текст |
Программа записи выигрывает, если важна абсолютная точность голоса и есть условия для записи. Нейросеть выигрывает в скорости, повторяемости и независимости от физического состояния и условий.
Для серийного контента особенно заметна разница: один раз сохраняешь голос в «Мои голоса» и дальше просто вставляешь новый текст на каждый выпуск, без повторной записи.
Какое качество аудио даёт нейросеть по сравнению с микрофоном?
Современные нейросети для озвучки генерируют аудио, которое на слух трудно отличить от живой записи — при условии качественного образца и хорошего текста. Но есть нюансы.
Где нейросеть проигрывает живой записи:
-
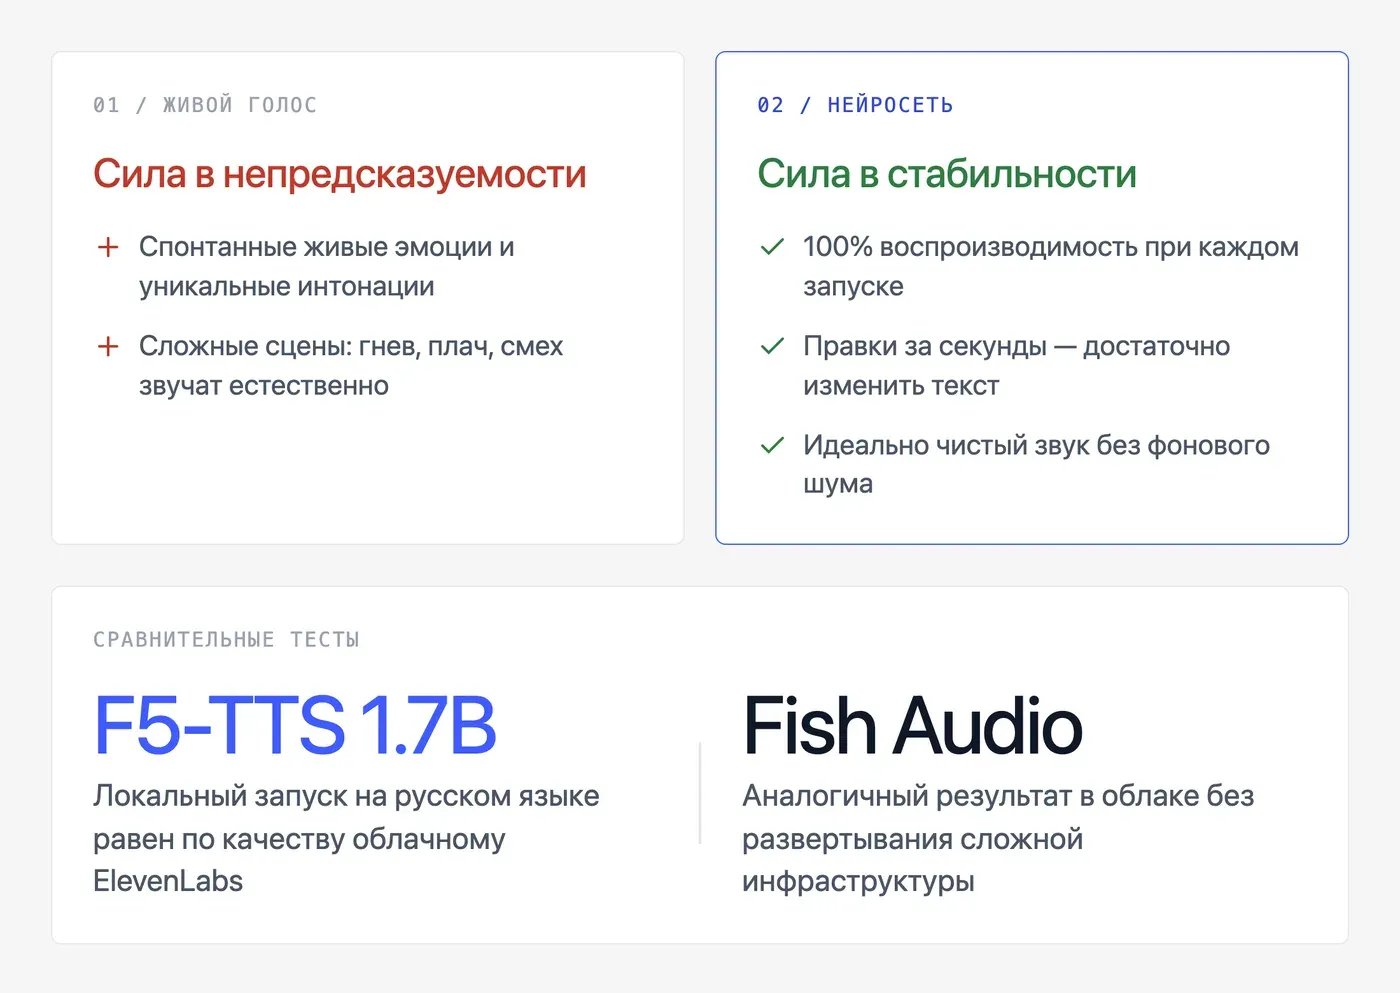
Спонтанные эмоции и уникальные интонации — нейросеть работает предсказуемо, а человек — непредсказуемо, и это иногда именно то, что нужно.
-
Сложные эмоциональные сцены — гнев, плач, смех — воспроизводятся хуже, чем нейтральная речь.
Где нейросеть выигрывает:
-
Воспроизводимость: один и тот же текст прозвучит одинаково хоть сто раз.
-
Скорость правки: изменил слово в тексте — перегенерировал за секунды.
-
Отсутствие фонового шума: дорожка чистая по умолчанию.
По данным сравнительных тестов 2026 года, модель F5-TTS 1.7B на русском языке демонстрирует качество, сопоставимое с ElevenLabs при локальном запуске (по оценкам авторов независимых обзоров). Облачные сервисы, работающие на движке Fish Audio, показывают схожие результаты без необходимости разворачивать локальную инфраструктуру.
Fish Audio — товарный знак его правообладателя. Мы не являемся его представителем или партнёром; используем API Fish Audio как поставщика технологии генерации речи.
Можно ли записать голос другого человека без его участия?
Нет — и это не техническое ограничение, а юридическое.
Клонирование голоса без согласия человека нарушает его право на голос как часть биометрических персональных данных. В России это регулируется ФЗ-152 «О персональных данных». Использовать клонированный голос другого человека в публичном контенте без его разрешения — основание для гражданского иска.
Технически создать клон по чужой записи возможно — сервисы это позволяют. Но добросовестные платформы требуют подтвердить, что голос принадлежит тебе или у тебя есть согласие владельца. Speakmi работает так же: клонирование только своего голоса или с подтверждением прав.
Голоса знаменитостей, публичных людей, исторических персонажей — отдельная тема с отдельными рисками. Даже если запись доступна публично, это не означает права на клонирование.
Где попробовать запись голоса нейросетью бесплатно прямо сейчас?
Быстрее всего — через Telegram-бот: открываешь https://t.me/speakmibot, отправляешь текст или голосовое сообщение и получаешь озвучку или клон. Без регистрации, без карты.
Для работы с проектами и сохранёнными голосами — веб-студия speakmi.ru: там доступны «Мои голоса», история генераций и выгрузка файлов в нужном формате.
Первые 30 секунд озвучки бесплатно — можно послушать свой голос на реальном тексте прежде, чем платить.
Частые вопросы
- Можно ли записать свой голос нейросетью, если у меня нет микрофона?
- Да. Достаточно любой записи голоса — голосовое сообщение из Telegram или WhatsApp подходит. Если хочешь только озвучку чужим голосом из библиотеки — микрофон не нужен вообще: просто вставляешь текст и выбираешь готовый голос в Speakmi.
- Сколько секунд аудио нужно, чтобы клонировать голос человека?
- Минимум — 10 секунд чистой речи без шума на фоне (Neironka.pro, 2026). Некоторые сервисы заявляют о работе от 3 секунд, но устойчивый результат даёт 10–30 секунд. В Speakmi рекомендуемый диапазон — 10–30 секунд; Voicebox принимает образцы от 15 секунд.
- Как записать другой голос — мужской вместо женского или наоборот?
- Выбери нужный голос из каталога сервиса при генерации. В Speakmi каталог содержит голоса разного пола и тембра — выбираешь нужный перед отправкой текста. Клонирование здесь не нужно: это просто выбор готового голоса из библиотеки.
- Отличается ли клонированный голос от оригинала на слух?
- Узнаваемо похоже, но не идентично. Спонтанные эмоции и нестандартные интонации нейросеть воспроизводит хуже. Для дикторской озвучки, подкастов и видеоконтента качества хватает. Для живого разговора или игры — нет.
- Законно ли клонировать голос другого человека?
- Только с явного согласия владельца голоса. Голос — биометрические персональные данные, защищённые ФЗ-152. Клонирование без согласия и тем более использование в публичном контенте — основание для иска. Голоса знаменитостей и публичных людей — отдельный юридический риск вне зависимости от доступности записей.
- Какие форматы файлов получаются на выходе при записи голоса нейросетью?
- В большинстве облачных сервисов на выходе MP3 или WAV — это стандарт, который принимают все видеоредакторы, монтажные программы и подкаст-платформы. Speakmi выдаёт аудиофайл, готовый к вставке в монтаж без конвертации.
- Можно ли использовать записанный нейросетью голос в коммерческих видео?
- Зависит от условий сервиса. В Speakmi сгенерированный голос можно использовать в коммерческом контенте — проверяй актуальные условия в пользовательском соглашении на speakmi.ru. Если используешь клон чужого голоса — нужно дополнительное согласие правообладателя независимо от условий сервиса.
- Где сделать диалог из нескольких голосов?
- В Speakmi — через веб-студию: создаёшь несколько генераций с разными голосами и собираешь их в монтажной программе. Voicebox (локальная сборка) имеет вкладку Stories для многоголосых диалогов напрямую в интерфейсе, но требует настройки на мощном ПК.