Text to Speech API: интеграция озвучки в приложение
Как подключить Text to Speech API к приложению или боту: сравнение Google TTS, Fish Audio и других движков, цены, лимиты и примеры кода. Озвучить текст можно в Спикми.
Что такое Text to Speech API и зачем он нужен разработчику?
TTS API принимает текст и возвращает аудио — MP3, WAV или OGG — в одном HTTP-запросе. Разработчику не нужно разбираться в синтезе речи: это слой абстракции, за которым стоит нейросетевая модель провайдера.
Старые TTS-движки склеивали заранее записанные куски речи — на стыках слышны были «швы» и роботизированный ритм. Современные модели обучены на миллионах часов живой речи и генерируют паттерны интонации целиком, включая паузы и смех. Разница слышна с первой фразы.
Типичные сценарии:
-
голосовые реплики Telegram-бота или ассистента
-
приветствие в IVR / автоответчике
-
озвучка карточек товаров и рекламных роликов
-
нейровитубер или персонаж для стрима в реальном времени
-
обучающие материалы с озвучкой на иностранном языке
Ключевой параметр для интерактивных сценариев — задержка до первого чанка аудио. Порог восприятия: менее 500 мс. Если ответ приходит дольше — диалог ощущается как «мёртвый».
Google Text to Speech API vs Fish Audio API vs другие: что выбрать для русского языка?
Google Cloud TTS — зрелый сервис с поддержкой 40+ языков и WaveNet-моделями. Хорошо работает в экосистеме GCP. Для русского — приемлемо, но не лидер по естественности интонации. Тарификация — по символам, с автосписанием при превышении бесплатного лимита; страница квот обновлена 14 июля 2026 г., конкретные цифры бесплатного лимита Google оговаривает право менять.
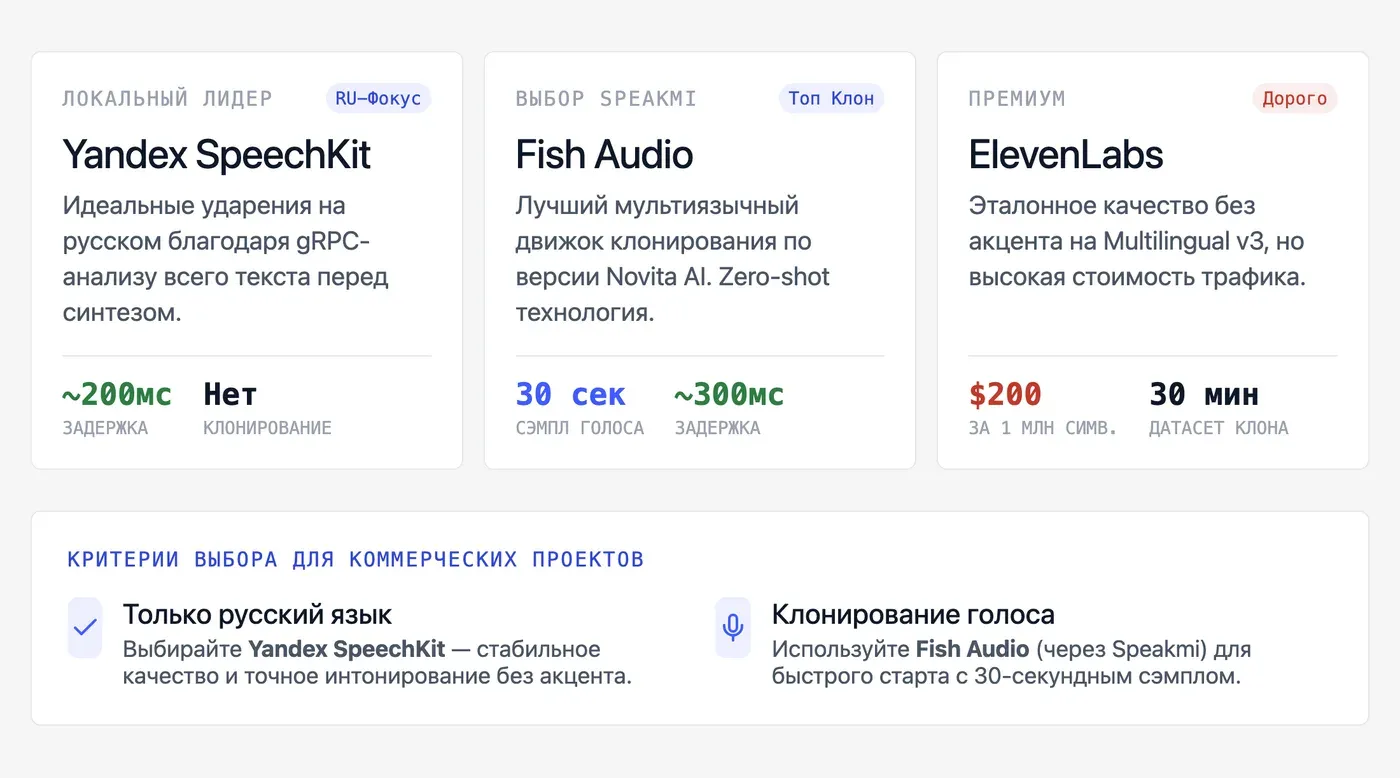
Fish Audio — по оценке рейтинга Novita AI (май 2026), лучший API для клонирования голоса среди мультиязычных провайдеров. Клон строится из образца длиной 30 секунд, без дообучения модели (zero-shot). Именно на движке Fish Audio работает Speakmi (Спикми).
Fish Audio — товарный знак его правообладателя. Мы не являемся его представителем или партнёром; используем API Fish Audio как поставщика технологии синтеза речи.
ElevenLabs — лидер по качеству голоса в независимых тестах. Multilingual v3 работает с русским без акцента. Минус — цена: стандартная модель стоит $200 за 1 млн символов, Turbo-версия вдвое дешевле ($100 за 1 млн символов), но у Turbo есть фоновый белый шум. Задержка Turbo v2.5 — около 300 мс до первого чанка.
Yandex SpeechKit v3 — сильный вариант для русского, работает по gRPC, аутентификация через IAM-токен. Оценивает весь текст перед синтезом, что даёт стабильные ударения.
Таблица сравнения (данные на сентябрь 2026):
| Движок | Качество русского | Цена за 1 млн символов | Бесплатный лимит | Latency (первый чанк) | Клонирование голоса |
|---|---|---|---|---|---|
| Google Cloud TTS | Хорошее | Несколько уровней, зависит от типа голоса | Есть, точный лимит уточнять на странице pricing | ~200–400 мс | Нет |
| Fish Audio / Speakmi | Отличное | Зависит от пакета | Первые 30 секунд бесплатно (Speakmi) | ~300–400 мс | Да, 30 сек образец |
| ElevenLabs Standard | Отличное | ~$200 | Ограниченный free tier | ~400 мс | Да, 30 мин датасет |
| ElevenLabs Turbo v2.5 | Хорошее | ~$100 | То же | ~300 мс | Да |
| Yandex SpeechKit v3 | Отличное (русский) | По символам, тарифы на yandex.cloud | Есть | ~200–350 мс | Нет |
| GenVoice | Хорошее | В рублях, см. genvoice.ru | Есть | ~300 мс | Нет |
Для русского языка в коммерческих проектах — SpeechKit или Fish Audio. Для мультиязычного продукта с клонированием — Fish Audio или ElevenLabs (если бюджет позволяет).
Как подключить Text to Speech API: пошаговая интеграция на примере Speakmi
Speakmi не раскрывает публичный API как готовую функцию — он в разработке. Пример ниже показывает универсальную логику подключения любого TTS API с OpenAI-совместимым эндпоинтом (AITUNNEL, Zowy, GenVoice и другие реализуют тот же паттерн).
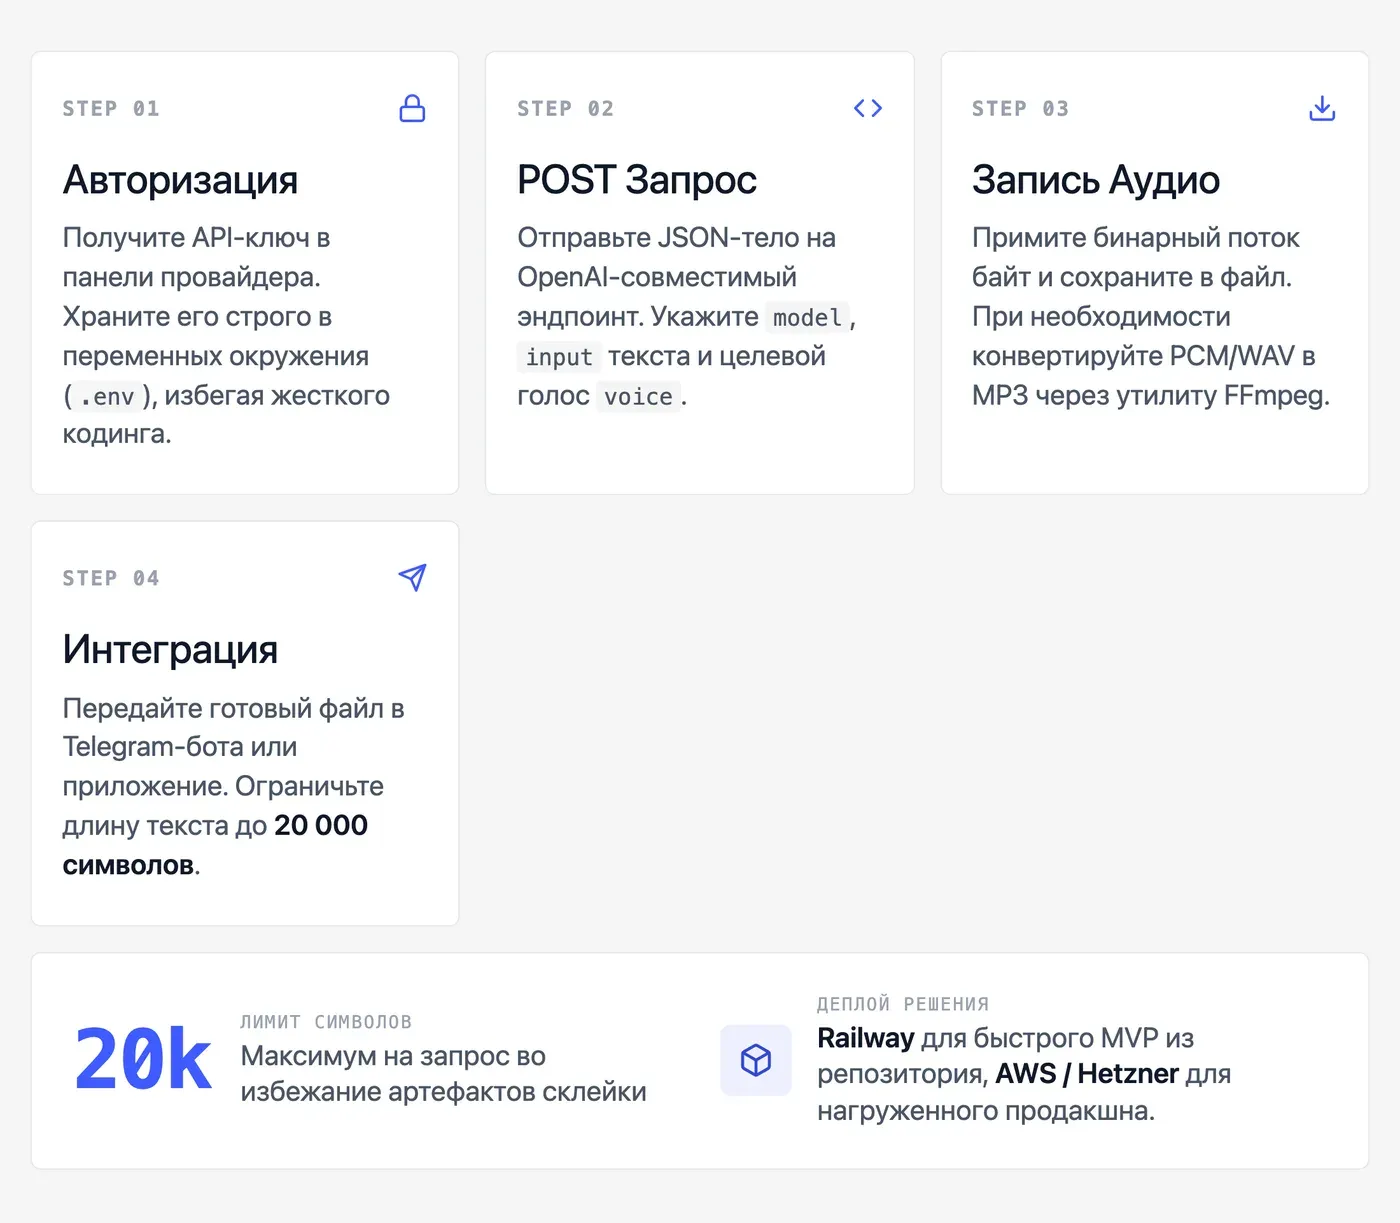
1. Получить API-ключ
Зарегистрируйся на сайте провайдера, перейди в раздел API / Developer, создай ключ. Храни его в переменной окружения, не в коде.
2. Сформировать запрос
Стандартный OpenAI-совместимый эндпоинт:
POST https://<provider>/v1/audio/speech
Authorization: Bearer <API_KEY>
Content-Type: application/json

{
  "model": "tts-1",
  "input": "Привет, это тестовая озвучка.",
  "voice": "alloy",
  "response_format": "mp3"
}
Для AITUNNEL достаточно сменить base_url — структура запроса идентична OpenAI.
3. Обработать аудио-ответ
Ответ — бинарный поток. В Python:
import requests, os

response = requests.post(
    "https://api.aitunnel.ru/v1/audio/speech",
    headers={"Authorization": f"Bearer {os.environ['API_KEY']}"},
    json={"model": "tts-1", "input": "Текст для озвучки", "voice": "alloy"}
)
with open("output.mp3", "wb") as f:
    f.write(response.content)
Если провайдер возвращает сырой PCM (например, Zowy — WAV 24 kHz mono), конвертируй через FFmpeg:
ffmpeg -i input.wav -codec:a libmp3lame output.mp34. Встроить в приложение или бота
Для Telegram-бота на Aiogram — отправь файл методом send_audio или send_voice. Установи лимит на длину входного текста (разумный потолок — 20 000 символов за один запрос, иначе модель сама бьёт текст на чанки и на стыках могут появляться артефакты).
5. Задеплоить
Для MVP — Railway: деплой прямо из GitHub-репозитория по кнопке, без настройки инфраструктуры. Для продакшна с нагрузкой — Hetzner или AWS.
Сколько стоит Text to Speech API: как считать токены и не переплатить?
Большинство TTS API тарифицирует по числу символов (или токенов), отправленных на синтез. Логика простая: чем длиннее текст — тем больше списывается.
Как считать бюджет:
-
Одна минута русской речи ≈ 800–1000 символов.
-
1000 минут контента ≈ 800 000–1 000 000 символов.
-
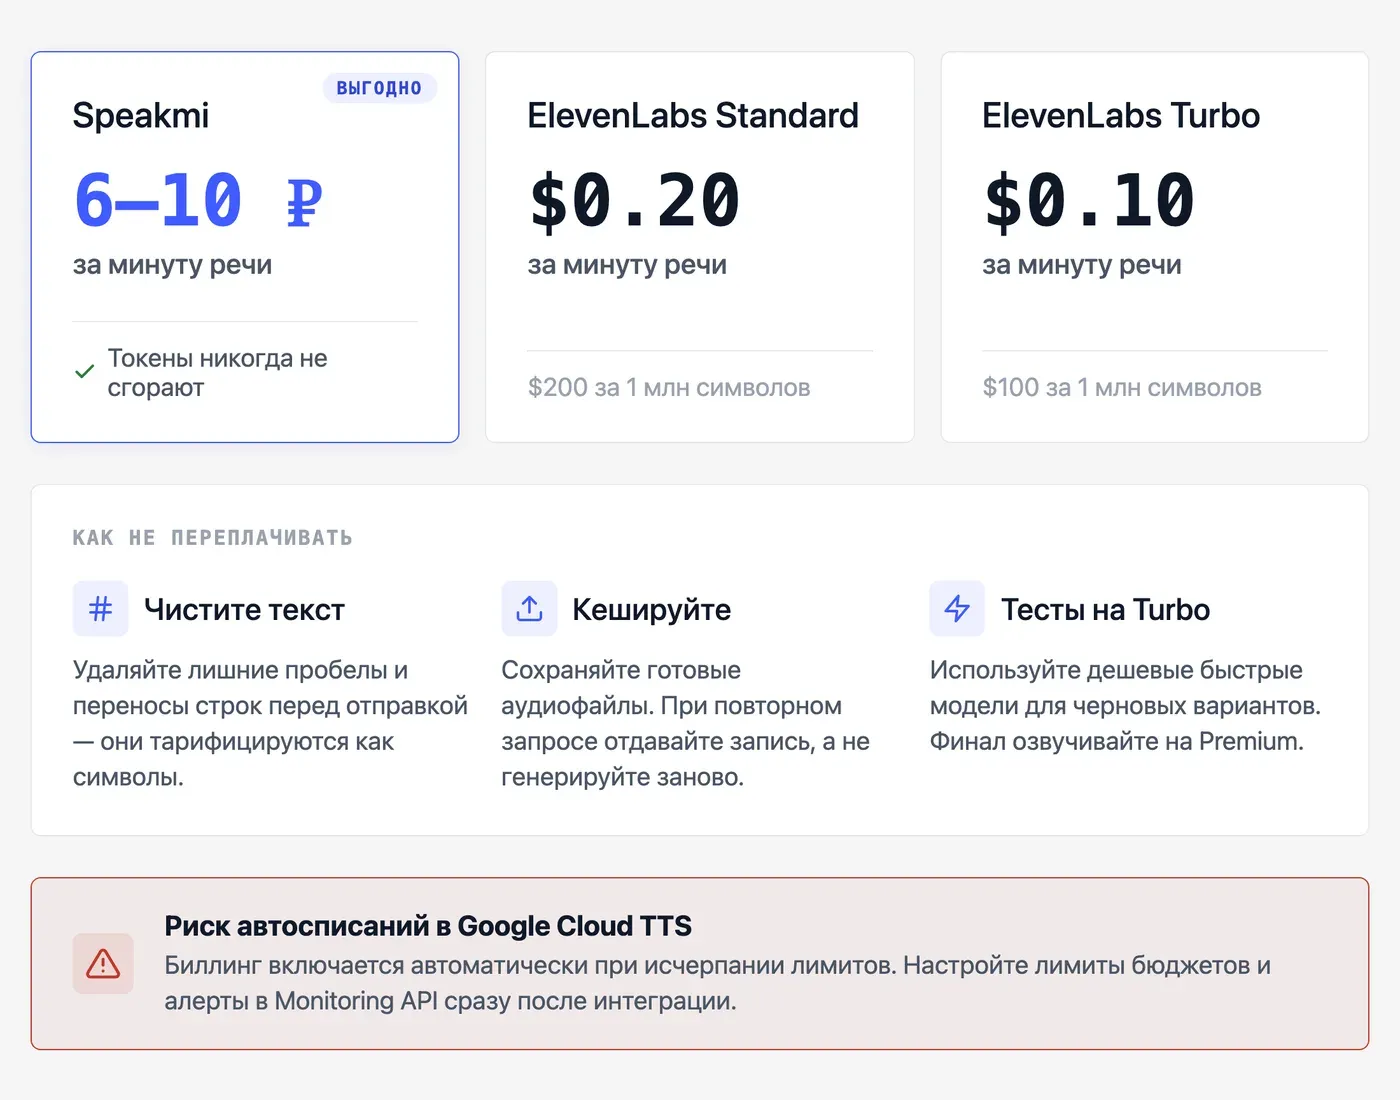
ElevenLabs Standard: 1 млн символов = $200 → минута ≈ $0,20.
-
ElevenLabs Turbo: 1 млн символов = $100 → минута ≈ $0,10.
-
Speakmi: стоимость минуты — около 10–13 ₽, цена видна до нажатия «Озвучить».
Токены у Speakmi не сгорают: купил пакет — списывается только то, что реально озвучил, хоть сегодня, хоть через полгода.
Три правила, чтобы не переплатить:
-
Обрезай пробелы и лишние переносы до отправки — они тоже считаются символами.
-
Кешируй результат: если один и тот же текст озвучивается повторно — отдавай сохранённый файл, не делай новый запрос.
-
Используй Turbo/Flash-модели для черновиков — они дешевле, для финального варианта переключись на стандартную.
Отдельный риск: у Google Cloud TTS биллинг включается автоматически при превышении лимита. Если не выставлен алерт на бюджет — счёт может прийти неожиданно. Настрой Monitoring API usage сразу после подключения.
Text to Speech Pro: чем платные тарифы отличаются от бесплатных?
Коротко: бесплатный уровень — для тестирования, платный — для продакшна.
| Параметр | Бесплатный | Платный (Pro) |
|---|---|---|
| Лимит символов/месяц | Ограничен (у каждого провайдера свой порог) | Высокий или неограниченный |
| Клонирование голоса | Обычно недоступно | Доступно |
| Качество модели | Базовая | Улучшенная / нейросетевая |
| Поддержка эмоций | Нет | Да (у части провайдеров) |
| Автодокупка при исчерпании | Нет | Есть (ElevenLabs Creator+) |
| Перенос неиспользованных токенов | Нет | Да (ElevenLabs при активной подписке) |
| SLA / приоритет в очереди | Нет | Да |
Важный нюанс по ElevenLabs: на тарифе Creator и выше доступна автоматическая докупка токенов при исчерпании лимита — сервис не останавливается посреди месяца. Неиспользованные токены переносятся на следующий месяц, если подписка активна.
Для Professional Voice Cloning в ElevenLabs нужен датасет 30 минут записей. Для zero-shot клонирования в Fish Audio достаточно 30 секунд — это принципиальная разница, если нужен быстрый прототип.
Speakmi: первые 30 секунд озвучки бесплатно — можно оценить качество голоса до оплаты. Попробовать на speakmi.ru.
Какие форматы вывода поддерживает TTS API: MP3, WAV, OGG — что выбрать?
MP3 — универсальный выбор для большинства задач: маленький размер, воспроизводится везде. WAV — без потерь, нужен, если дальше будешь обрабатывать аудио в редакторе. OGG/Opus — оптимален для Telegram (бот возвращает голосовые сообщения именно в этом формате).
Zowy отдаёт WAV 24 kHz mono или сырой PCM — для Telegram нужна конвертация через FFmpeg. Большинство других провайдеров поддерживают MP3 напрямую.
Правило: если конечный пункт — Telegram-бот, проверь, принимает ли метод send_voice твой формат. Для send_audio подходит MP3. Для send_voice — OGG/Opus.
Как встроить TTS API в Telegram-бота или веб-приложение без бэкенда?
Telegram-бот — самый быстрый путь до пользователя. Бот удобнее веб-приложения на телефоне: не нужно открывать браузер, авторизовываться, нажимать лишние кнопки.
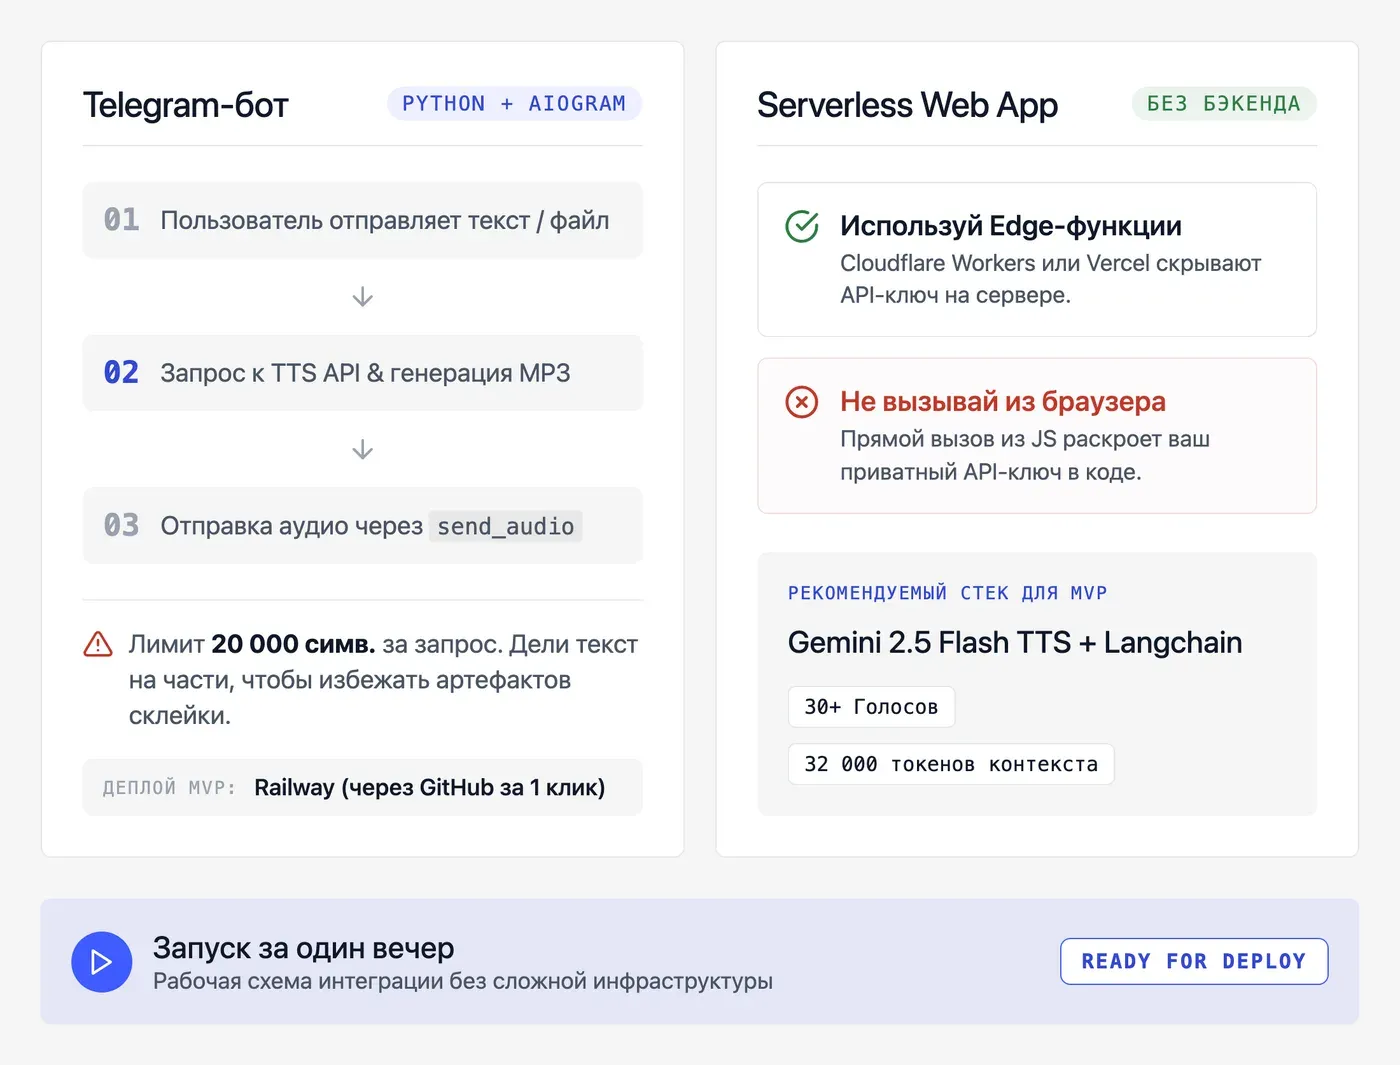
Минимальная архитектура бота с озвучкой (Python + Aiogram):
-
Пользователь отправляет текст или Markdown-файл.
-
Бот передаёт текст на TTS API.
-
Получает MP3 в ответе.
-
Отправляет аудио пользователю через
send_audio.
Лимит обрабатываемого текста за один запрос — 20 000 символов. Длиннее — дели на части вручную, иначе модель сама нарежет текст на чанки и на стыках появятся артефакты. Их можно вырезать в аудиоредакторе, но проще не допускать.
Деплой без бэкенда в классическом смысле — Railway: подключаешь GitHub-репозиторий, нажимаешь Deploy. Для MVP этого достаточно.
Веб-приложение без бэкенда (serverless):
-
Используй Cloudflare Workers или Vercel Edge Functions — они выполняют запрос к TTS API на сервере, ключ не попадает в браузер.
-
Не вызывай TTS API напрямую из браузерного JS — API-ключ окажется в открытом виде в коде.
Готовый Telegram-бот на базе Gemini 2.5 Flash TTS через Langchain, задеплоенный на Railway, — рабочая схема, которую реализуют за один вечер. Gemini TTS поддерживает 30+ голосов и лимит контекста 32 000 токенов за запрос.
Частые вопросы
- Можно ли использовать Google Text to Speech API бесплатно и какой лимит?
- Да, бесплатный уровень есть. Точные цифры лимита Google оговаривает право менять — смотри актуальные данные на cloud.google.com/text-to-speech/pricing (страница обновлена 14 июля 2026 г.). При превышении лимита биллинг включается автоматически, поэтому сразу настрой алерт на бюджет в Google Cloud Monitoring — иначе счёт придёт неожиданно.
- Какой TTS API лучше всего работает с русским языком в 2026 году?
- Для чистого русского — Yandex SpeechKit v3: модель оценивает весь текст целиком перед синтезом, ударения стабильнее. Для мультиязычного продукта с клонированием голоса — Fish Audio (30 секунд образца, zero-shot). ElevenLabs Multilingual v3 тоже работает с русским без акцента, но стоит $200 за 1 млн символов против вдвое более дешёвого Turbo. Источник: рейтинг Novita AI, май 2026; тест avatarbox.ru, май 2026.
- Как получить API-ключ для озвучки текста и сколько это стоит?
- Регистрируешься на сайте провайдера → раздел API / Developer → создаёшь ключ. Это бесплатно. Деньги списываются за использование: ElevenLabs Turbo — ~$100 за 1 млн символов, Yandex SpeechKit — по символам на yandex.cloud, Speakmi — около 10–13 ₽ за минуту. Большинство провайдеров дают бесплатный лимит для тестирования.
- Чем Fish Audio API отличается от Google Cloud TTS по качеству голоса?
- Fish Audio специализируется на клонировании голоса: 30 секунд образца — и готовый клон без дообучения модели. Google Cloud TTS сильнее в масштабируемости и интеграции с GCP-экосистемой, поддерживает 40+ языков. По естественности русской речи Fish Audio субъективно выигрывает; по инфраструктурной зрелости и корпоративной поддержке — Google. Источник: рейтинг Novita AI, май 2026.
- Как интегрировать Text to Speech в Telegram-бота на Python?
- Используй Aiogram как фреймворк для бота. Логика: получить текст от пользователя → POST-запрос к TTS API с текстом в теле → получить MP3 в ответе → отправить через bot.send_audio(). Если провайдер возвращает WAV или PCM — конвертируй через FFmpeg перед отправкой. Лимит на один запрос — 20 000 символов. Для деплоя MVP — Railway (подключение GitHub-репозитория по кнопке).
- Что такое Text to Speech Pro и стоит ли платить за расширенный тариф?
- Pro-тариф открывает клонирование голоса, улучшенные нейросетевые модели, автодокупку токенов при исчерпании лимита и перенос остатка на следующий месяц. Для тестирования идеи хватает бесплатного уровня. Для продакшна (бот с реальными пользователями, регулярная озвучка контента) — Pro оправдан: базовые модели дают заметно более роботизированный результат, а остановка сервиса из-за исчерпания лимита обходится дороже абонентской платы.
- Как не превысить лимит токенов при массовой озвучке через API?
- Три конкретных шага: 1) Кешируй результат — одинаковый текст озвучивай один раз, отдавай сохранённый файл повторным запросам. 2) Обрезай лишние пробелы и переносы строк до отправки — они тоже считаются символами. 3) Для черновиков и тестов используй Turbo/Flash-модели (в 2 раза дешевле стандартных), финальную версию озвучивай на основной. У Google Cloud TTS дополнительно настрой бюджетный алерт в Monitoring API usage — автосписание включается без предупреждения.